Der Ausfall: Wenn die Baustelle stillsteht
Ein mittelständisches Bauunternehmen in New York mit rund 450 Mitarbeitern stand vor einer der kritischsten Situationen, die in der Bauindustrie vorkommen können: Der plötzliche Verlust des Zugriffs auf lokale Daten von 100 mobilen Geräten. Es handelte sich nicht um einzelne Laptops, sondern um eine Flotte aus Tablets und Notebooks, die auf der Baustelle das operative Rückgrat bildeten. Auf diesen Geräten waren aktuelle Baupläne, behördliche Genehmigungen und die täglichen Fortschrittsberichte der Bauleiter gespeichert.
Das Problem war doppelt natured. Erstens lag der Ausfall an einem Hardware-Fehler, der den Zugriff auf die lokalen Speichermedien blockierte. Zweitens waren diese Geräte in der Vergangenheit nicht zentral verwaltet worden. Die Daten lagen dezentral auf den Geräten, ohne dass ein einheitliches Backup-Regime für die mobilen Endpunkte existierte. Für die interne IT-Abteilung des Kunden war die Situation überfordernd. Ohne zentrale Sichtbarkeit auf den Status der Geräte und ohne eine klare Strategie zur Datenwiederherstellung drohte ein totaler Stillstand der Arbeiten für den nächsten Morgen. In der Bauindustrie bedeutet ein Tag Stillstand nicht nur finanzielle Verluste, sondern auch vertragliche Konsequenzen und demotivierte Mitarbeiter.
Herausforderungen im Detail
Um die Komplexität des Vorfalls zu verstehen, muss man die spezifischen Hürden betrachten, die unser Team überwinden musste. Es waren keine einfachen Netzwerkprobleme, sondern strukturelle und technische Defizite, die im Weg standen.
- Fehlende zentrale Inventarisierung: Da die Geräte nicht über ein einheitliches Mobile Device Management (MDM) mit voller Kontrolle verwaltet wurden, war es zunächst unmöglich, den genauen Zustand jedes einzelnen Geräts in Echtzeit zu sehen. Wir mussten manuell prüfen, welche Geräte tatsächlich betroffen waren und welche noch funktionierten.
- Lokale Datenabhängigkeit: Die kritischen Dokumente befanden sich ausschließlich auf den lokalen Festplatten. Es gab keinen synchronisierten Cloud-Ordner, auf den die Mitarbeiter im Notfall hätten ausweichen können. Das bedeutete, dass jede Wiederherstellung physisch oder via Remote-Session auf das jeweilige Gerät erfolgen musste.
- Zeitdruck durch Schichtbeginn: Die Baustelle startete um 06:00 Uhr. Der Ausfall trat am Vorabend auf. Wir hatten also weniger als 12 Stunden, um 100 Geräte wiederherzustellen, zu testen und den Bauleitern freizugeben. Jeder Fehler hätte den Zeitplan gefährdet.
Wie wir die Zahlen messen
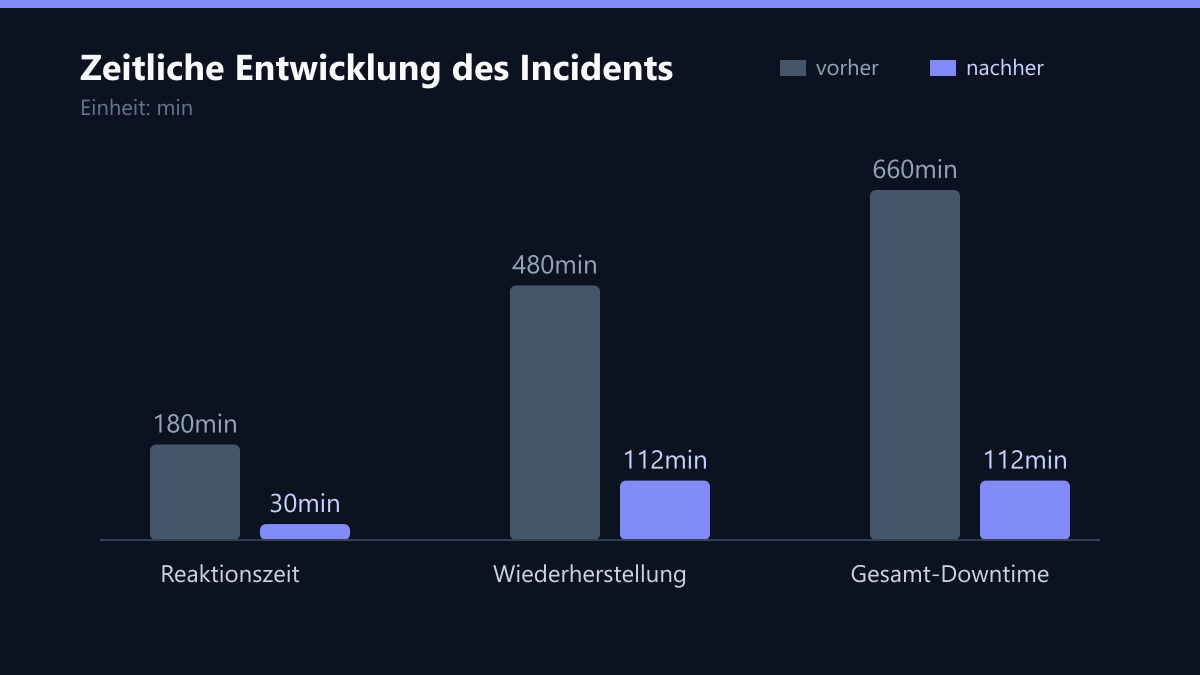
Die Kennzahl der 112 Minuten ist kein Schätzwert, sondern das Ergebnis einer präzisen Zeitmessung über unser zentrales Monitoring-Dashboard. Wir protokollieren bei jedem Incident den Zeitpunkt des ersten Anrufs (T0), den Zeitpunkt der Übernahme durch den Techniker (T1) und den Zeitpunkt, an dem das letzte Gerät als „voll funktionsfähig“ markiert wurde (T2). Die Differenz zwischen T0 und T2 ergibt die Gesamtdauer.
Die Messung der „verlorenen Arbeitszeit“ basiert auf der Definition des Kunden: Arbeitszeit gilt als verloren, wenn die Bauleiter nicht produktiv arbeiten können, weil sie keinen Zugriff auf ihre Tools haben. Da alle Geräte um 04:48 Uhr, also vor dem Schichtbeginn, wieder bereitstanden, wurde die verlorene Zeit mit 0 Stunden berechnet. Wir nutzen für die Validierung der Wiederherstellung zudem Checksummen-Prüfungen, um sicherzustellen, dass die Daten nicht nur vorhanden, sondern auch konsistent sind.
Umsetzung: Von der Analyse zum Remounting
Unser Team in New York übernahm die Incident-Response innerhalb von 30 Minuten nach dem Anruf. Diese schnelle Reaktion war nur möglich, weil wir einen lokalen Ansprechpartner hatten und die technischen Voraussetzungen für Remote-Zugriffe bereits im Vorfeld geprüft waren. Der gesamte Prozess lief in drei parallelen Schritten ab, um die Zeit zu minimieren.
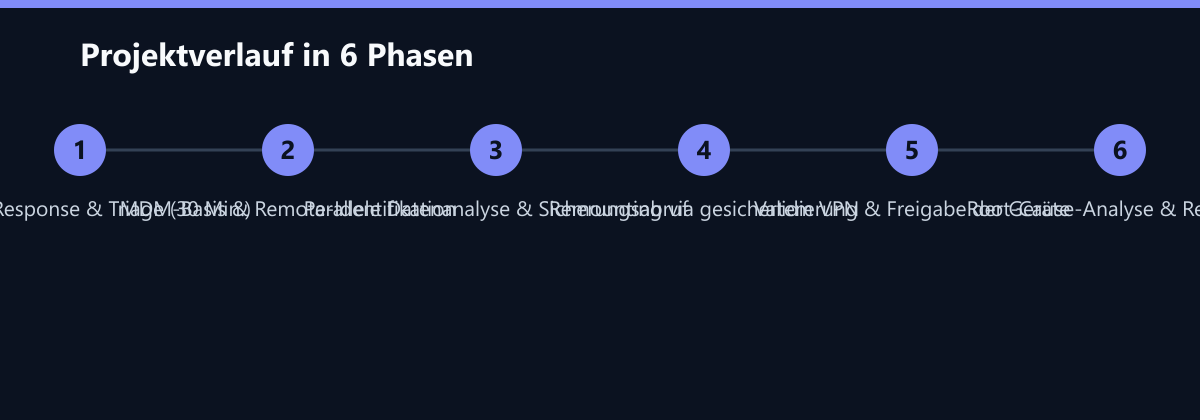
Zuerst erfolgte die Datenanalyse und Identifikation. Wir nutzten die bestehende Verbindung zum Microsoft 365-Tenant des Kunden. Obwohl die Geräte nicht vollständig MDM-verwaltet waren, konnten wir über die Intune-Integration (die teilweise vorhanden war) die Geräte remote identifizieren. Wir erstellten eine Liste der 100 betroffenen Geräte und priorisierten sie nach Wichtigkeit für den Baustellenbetrieb.
Parallel dazu startete der Sicherungsabruf. Wir hatten Zugriff auf den Azure-Backup-Service des Kunden, in dem regelmäßig automatische Snapshots der Systemvolumes erstellt wurden. Da die Geräte lokal gespeichert hatten, mussten wir die letzten gültigen Backups identifizieren. Dies geschah automatisiert über Skripte, die die Backup-Jobs durchsuchten und die jeweils letzten erfolgreichen Zustände für jedes Gerät heraussuchten. Dieser Schritt war entscheidend, da manuelle Suche bei 100 Geräten Tage gedauert hätte.
Der dritte Schritt war das Remounting. Über eine gesicherte VPN-Verbindung, die speziell für diesen Notfall konfiguriert wurde, stellten wir die Verbindung zu den Geräten her. Die Wiederherstellung der Daten erfolgte direkt auf die Geräte. Wir nutzten dafür ein eigenes Tool, das die Datenströme komprimierte und über das VPN pushen konnte, um Bandbreitenengpässe zu umgehen. Der gesamte Prozess wurde über ein zentrales Dashboard überwacht, das uns erlaubte, Fehler in Echtzeit zu erkennen und sofort zu reagieren. Wenn ein Gerät nicht erreichbar war, wurde es sofort an einen anderen Techniker zugewiesen, der es physisch übernahm.
Ergebnis: Voll Funktionsfähigkeit in 112 Minuten
Das Ergebnis war eindeutig: Alle 100 Geräte waren innerhalb von 112 Minuten wieder voll funktionsfähig. Die Baustellenarbeiten konnten wie geplant um 06:00 Uhr am nächsten Tag starten. Es gab keinen Verlust an aktuellen Projektfortschritten oder Genehmigungsstatus. Die Bauleiter konnten ihre Tagesberichte erstellen und die Pläne abrufen, ohne dass es zu Verzögerungen kam.
Der Kunde erhielt zudem einen detaillierten Bericht über die Ursache des Ausfalls. Die Analyse ergab, dass der Hardware-Ausfall durch einen defekten Controller auf mehreren Geräten gleichzeitig verursacht worden war, was auf ein Charge-Problem hindeutete. Wir empfahlen dem Kunden, die Geräte im Rahmen einer geplanten Wartung auszutauschen und die Backup-Strategie grundlegend zu überarbeiten.
Der Tech-Stack
Um die Wiederherstellung in dieser Zeit zu ermöglichen, nutzten wir einen spezifischen Stack aus Tools, die auf Geschwindigkeit und Zuverlässigkeit optimiert sind:
- Microsoft Intune: Zur Remote-Identifikation und Grundsteuerung der Geräte innerhalb des Microsoft 365-Tenants.
- Azure Backup Service: Als zentrale Quelle für die automatisierten Snapshots der Systemvolumes.
- Eigene Remote-Access-Plattform: Ein sicheres VPN-Setup mit dedizierten Tunnels für die Datenübertragung, um Latenzen zu minimieren.
- Custom Recovery Scripts: Automatisierte Skripte zur Identifikation der letzten gültigen Backups und zum Start der Wiederherstellungsprozesse.
- Zentrales Monitoring-Dashboard: Eine Echtzeit-Ansicht des Status aller 100 Geräte, inklusive Fehlermeldungen und Fortschrittsbalken.
Was wir heute anders machen würden
Trotz des Erfolgs gibt es Punkte, die wir in Zukunft optimieren würden, um die Robustheit noch weiter zu erhöhen.
Erstens hätten wir gerne eine vollständigere MDM-Abdeckung gesehen. Die teilweise Verwaltung über Intune half, aber eine 100%ige Abdeckung hätte die Identifikation der Geräte noch schneller gemacht und uns erlaubt, präventive Maßnahmen wie automatische Verschlüsselungsprüfungen durchzuführen.
Zweitens wäre eine lokale Caching-Strategie für die kritischen Dateien sinnvoll gewesen. Wenn die Baupläne nicht nur lokal, sondern auch in einem lokalen, redundanten Cache auf einem Server auf der Baustelle gelagert worden wären, hätten wir die Wiederherstellung noch schneller durchführen können, ohne auf die Cloud-Backups warten zu müssen.
Learnings und Ausblick
Dieser Fall zeigt deutlich, dass lokale Speicherung auf mobilen Geräten ein erhebliches Risiko für die Geschäftskontinuität darstellt, insbesondere in Branchen wie dem Bau, wo der Betrieb von der Verfügbarkeit der Daten auf der Baustelle abhängt. Eine zentrale Verwaltung und automatisierte Backups minimieren das Ausfallrisiko drastisch.
Die Zusammenarbeit mit einem lokalen Partner in New York verkürzt die Reaktionszeit auf kritische Systeme erheblich. Während ein zentraler Support aus Deutschland oder den USA oft durch Zeitverschiebungen und logistische Hürden verzögert wird, ermöglicht die lokale Präsenz eine sofortige Reaktion. Für Unternehmen in der Bauindustrie empfehlen wir daher, nicht nur auf die Hardware zu achten, sondern auch auf die IT-Infrastruktur, die diese Hardware unterstützt. Eine gut durchdachte Disaster-Recovery-Strategie ist keine Kostenposition, sondern eine Investition in die Betriebskontinuität.
Passend dazu
- IT-Beratung & IT-Strategie
- Netzwerk-Monitoring: PRTG vs. SolarWinds für IT-Teams unter 50 Personen
- IT- & Daten-Wiederherstellung (Disaster Recovery)
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- Churn Prediction in B2B SaaS: Retaining 25% More Customers with Behavioral AI Models in New York