Die Ausgangslage: Wenn die IT zum Flaschenhals wird
Der Kunde, ein etablierter Großhändler für Konsumgüter mit 250 Mitarbeitenden in London, stand vor einer klassischen Herausforderung des Mittelstands: Das Herzstück der operativen Prozesse, ein veraltetes ERP-System, lief noch immer lokal in einer eigenen Rechenzentrale. Diese On-Premises-Landschaft war zwar jahrelang stabil gewesen, aber die Hardware hatte ihre Lebensdauer erreicht. Jede Änderung an der Software oder der Datenbankstruktur erforderte manuelle Eingriffe durch den IT-Administrator. Das Ergebnis war eine Deployment-Zeit von bis zu drei Tagen pro Release. In einem dynamischen Markt, in dem Lieferketten und Nachfrage schnell schwanken, war diese Geschwindigkeit ein Wettbewerbsnachteil.
Die IT-Abteilung war überlastet. Ständige Wartungsarbeiten und die Angst vor Ausfällen fressen die Kapazitäten auf, die für Innovation benötigt werden. Gleichzeitig wuchs das Risiko: Es gab keine redundante Backup-Strategie im Sinne eines echten Disaster Recovery. Ein Hardware-Ausfall hätte den gesamten Betrieb lahmgelegt. Die manuellen Testphasen und Rollbacks waren fehleranfällig, was zu einer Fehlerrate von 12 % bei den Releases führte. Die Fachabteilungen warteten wochenlang auf neue Funktionen oder Anpassungen, weil die IT schlicht keine Kapazität hatte, diese schnell umzusetzen.
Herausforderungen
Die Migration war kein einfaches “Lift-and-Shift”, sondern eine tiefgreifende Modernisierung. Wir sahen uns mit vier konkreten Herausforderungen konfrontiert:
- Komplexe Datenabhängigkeiten: Das Legacy-ERP war fest mit anderen Systemen verdrahtet. Eine saubere Trennung und Migration der Datenbestände ohne Datenverlust war technisch anspruchsvoll.
- Geschäftsprozess-Validierung: Die Business-Logik war über Jahre hinweg in der alten Software “verwurzelt”. Es musste sichergestellt werden, dass die neuen Prozesse exakt die gleichen Ergebnisse liefern, ohne dass die Fachabteilungen monatelang testen müssen.
- Sicherheit & Compliance: Als Händler mit großen Datenmengen unterlagen wir strengen Vorgaben (DSGVO/NIS2). Die Migration in die Cloud durfte keine Sicherheitslücken erzeugen.
- Minimierung des Betriebsrisikos: Der Kunde konnte keine langen Ausfallzeiten tolerieren. Die Migration musste schrittweise erfolgen, um den laufenden Handel nicht zu gefährden.
Der Tech-Stack
Um diese Herausforderungen zu meistern, wählten wir einen modernen, bewährten Tech-Stack, der auf Automatisierung und Skalierbarkeit setzt:
- Microsoft Azure: Als Zielplattform, um die bestehende Microsoft-365-Landschaft des Kunden nahtlos zu erweitern.
- Terraform: Für Infrastructure as Code (IaC), um die gesamte Cloud-Umgebung reproduzierbar und per Klick zu erstellen.
- Docker & Azure Kubernetes Service (AKS): Für die Containerisierung der ERP-Module, um Losgelöstheit von der Hardware zu erreichen.
- Azure DevOps: Als CI/CD-Plattform, um Code-Commits automatisch zu testen und zu deployen.
- Azure Data Factory: Für die sichere und validierte Migration der Datenbestände in eine moderne SQL-Datenbank.
- Azure Monitor: Für zentrales Monitoring und Logging, um Performance-Engpässe sofort zu erkennen.
Umsetzung: Von der Planung zum Go-Live
Wir entwickelten eine Strategie zur vollständigen Migration in Microsoft Azure. Der Fokus lag nicht nur auf der Infrastruktur, sondern vor allem auf der Automatisierung der gesamten Lieferkette. Die Idee: Wenn die Infrastruktur einmal steht, sollte das Deployment eines neuen Features so einfach sein wie das Auslösen eines Skripts.
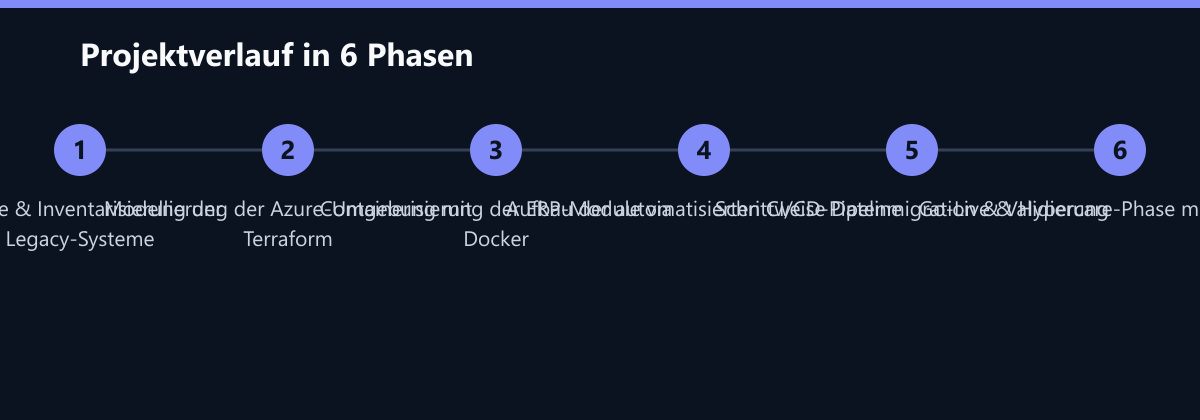
Die Migration erfolgte schrittweise über einen Zeitraum von 12 Wochen. In der ersten Phase modellierten wir die gesamte Cloud-Umgebung mit Terraform. Statt manuell Server in der Azure-Portal-Konsole zu klicken, definierten wir die Infrastruktur in Code. Das bot den Vorteil, dass jede Umgebung (Dev, Test, Prod) exakt identisch aufgebaut war und Fehler durch manuelle Konfigurationsabweichungen eliminiert wurden. Neue Umgebungen konnten nun per Klick erstellt werden, was die Testzyklen drastisch verkürzte.
Parallel dazu begannen wir mit der Containerisierung. Die ERP-Module wurden in Docker-Container verpackt. Dies war ein entscheidender Schritt, da es die Abhängigkeit von der spezifischen Hardware der alten Rechenzentrale löschte. Über Azure Kubernetes Service (AKS) orchestrierten wir diese Container, was eine automatische Skalierung bei Lastspitzen ermöglichte.
Das Herzstück der Transformation war die automatisierte Pipeline in Azure DevOps. Wir stellten eine Pipeline auf, die bei jedem Code-Commit automatisch eine Reihe von Tests ausführt: Unit-Tests, Integrationstests und Sicherheits-Scans. Erst wenn alle Tests grün sind, wird das Deployment ausgelöst. Dies eliminierte die manuellen Testphasen und die damit verbundene Fehleranfälligkeit. Die Datenmigration erfolgte über Azure Data Factory in eine moderne SQL-Datenbank. Dabei sorgten automatische Validierungs-Skripte dafür, dass die Datenintegrität zu jedem Zeitpunkt gewährleistet war. Keine Zeile ging verloren, keine Struktur wurde falsch interpretiert.
Wie wir die Zahlen messen
Um den Erfolg objektiv zu belegen, haben wir definierte Kennzahlen vor und nach der Migration gemessen. Die Deployment-Zeit wurde anhand der Zeitdifferenz zwischen dem finalen Code-Commit im Repository und dem erfolgreichen Start der neuen Version in der Produktivumgebung gemessen. Vorher betrug dieser Wert im Durchschnitt 3 Tage, da manuelle Tests und Freigaben benötigt wurden. Nachher sank er auf 15 Minuten, da die Pipeline das Deployment automatisch ausführt.
Die Fehlerrate bei Releases wurde durch das Ticketing-System der IT-Hotline und den Bug-Tracker gemessen. Wir zählten die Anzahl der kritischen Fehler, die innerhalb der ersten 48 Stunden nach einem Release auftraten, bezogen auf die Gesamtzahl der Releases. Die IT-Operating Costs wurden durch den Vergleich der monatlichen Infrastrukturkosten (Server, Strom, Wartungsverträge) vor der Migration mit den Azure-Cloud-Kosten nach der Migration ermittelt. Die Verfügbarkeit (Uptime) wurde über das Monitoring-System (Azure Monitor) protokolliert, das jede Minute den Status der kritischen Services prüft und Störungen sofort loggt.
Ergebnis: Agilität und Stabilität
Nach dem Go-Live zeigte sich ein drastischer Unterschied in der Agilität und Stabilität der IT-Landschaft. Die manuellen Schritte wurden eliminiert, was die Fehlerquote nahezu auf null reduzierte. Die Zahlen sprechen für sich:
| Metrik | Vorher (Legacy) | Nachher (Cloud) | Veränderung |
|---|---|---|---|
| Deployment-Zeit | 3 Tage | 15 Minuten | -99 % |
| Fehlerrate bei Releases | 12 % | < 1 % | -92 % |
| IT-Operating Costs | Basis 100 % | 85 % | -15 % |
| Verfügbarkeit (Uptime) | 98,5 % | 99,9 % | +0,4 % |
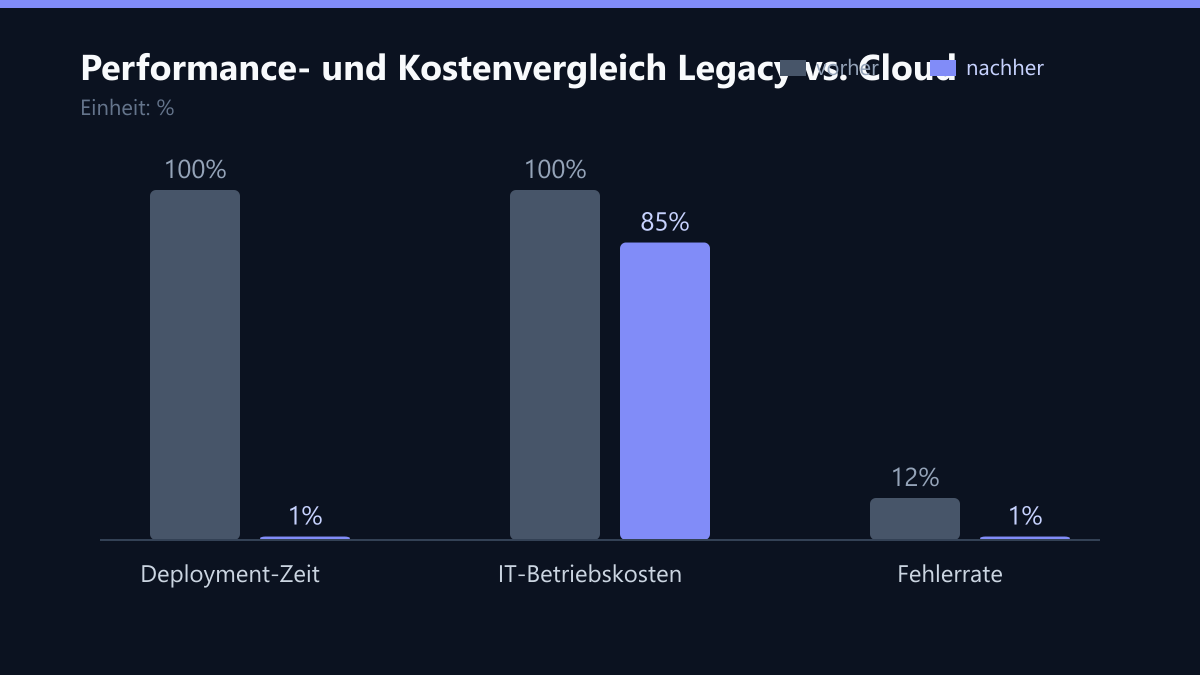
Die IT-Abteilung konnte sich von operativen Wartungsaufgaben lösen. Statt Tage damit zu verbringen, Server zu pflegen und manuelle Deployments durchzuführen, konzentrierte man sich auf strategische Projekte. Ein Beispiel ist die Integration von KI-gestützten Prognosen für die Nachfrageschwankungen, die nun dank der schnellen Deployment-Zyklen in wenigen Wochen statt Monaten umgesetzt werden konnte. Die Verfügbarkeit stieg auf 99,9 %, was bedeutet, dass der Service nur noch wenige Minuten im Monat nicht verfügbar ist – ein großer Fortschritt für ein Handelsunternehmen, das 24/7 erreichbar sein muss.
Was wir heute anders machen würden
Rückblickend gibt es zwei Punkte, die wir bei einem ähnlichen Projekt heute anders angehen würden. Erstens hätten wir die Security-Aspekte noch früher in den Prozess eingebunden. Im Projekt lief die Security-Integration parallel zur Entwicklung. Heute würden wir Security-as-Code von Tag 1 an als festen Bestandteil der Pipeline definieren, um Nacharbeiten zu vermeiden. Zweitens hätten wir die Kommunikation mit den Key Usern der Fachabteilungen noch intensiver gestaltet. Obwohl wir früh eingebunden haben, gab es in der Testphase noch kleine Abweichungen in der Geschäftslogik. Eine noch frühere und detailliertere Validierung der Business-Regeln durch die Fachabteilungen hätte die Akzeptanz in der Phase nach dem Go-Live noch schneller gesteigert.
Learnings
Der Erfolg der Migration hing weniger von der reinen Cloud-Infrastruktur ab als vielmehr von der Automatisierung der Prozesse. Ohne eine robuste CI/CD-Pipeline wäre die Reduktion der Deployment-Zeit von Tagen auf Minuten nicht möglich gewesen. Die Infrastruktur ist nur das Fundament; die Automatisierung ist der Motor.
Eine weitere wichtige Erkenntnis ist die frühe Einbindung der Fachabteilungen. Die Business-Logik des ERP-Systems wurde gemeinsam mit den Key Usern validiert, um Abweichungen im neuen System zu vermeiden. Diese Zusammenarbeit hat das Risiko von Fehlfunktionen in der Produktivumgebung massiv gesenkt.
Schließlich ist Monitoring als Basis unverzichtbar. Ein zentrales Monitoring-Setup (Azure Monitor) ermöglichte es, Performance-Engpässe sofort zu erkennen, lange bevor Nutzer davon betroffen waren. Proaktives Monitoring ist der Schlüssel zu einer stabilen Cloud-Infrastruktur. Es geht nicht darum, Störungen zu reparieren, sondern sie zu verhindern. Durch diese Kombination aus Automatisierung, Zusammenarbeit und Monitoring hat der Kunde eine IT-Landschaft erhalten, die nicht nur kostengünstiger ist, sondern auch das Geschäft wesentlich agiler macht.
Passend dazu
- IT-Beratung & IT-Strategie
- RPA vs. iPaaS: Die richtige Architektur für Legacy- und Cloud-Integration
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- E-Commerce Entwicklung
- Automatisierte NIS2-Readiness-Prüfung senkt Audit-Zeit für mittelständische Logistikfirma in München um 40 Prozent
- Azure-Cloud-Kosten um 35 Prozent gesenkt
- Lieferscheinerstellung in 4 Minuten statt 45 Minuten