Ausgangslage: Der Flaschenhals in der Mandantenaktenverwaltung
Die Kanzlei in Singapur, mit 45 Mitarbeitern, stand vor einer klassischen Herausforderung des digitalen Wandels in traditionellen Branchen. Über 50.000 Dokumente – darunter Vertragsentwürfe, Urteile und sensible Mandantenakten – waren über Jahre hinweg fragmentiert auf lokalen Netzlaufwerken und isolierten Servern gespeichert. Es gab keine zentrale Indexierung, keine einheitliche Nomenklatur und keine durchgängige Versionierungsstrategie.
Das operative Ergebnis war ein erheblicher Produktivitätsverlust. Anwälte verbrachten im Durchschnitt 25 Minuten pro Anfrage damit, die relevanten Dokumente zu finden. Diese Zeit kostete nicht nur wertvolle Beratungsstunden, sondern führte auch zu Frustration und erhöhtem Fehlerpotenzial. Manuelle Ablageprozesse resultierten in massiven Duplikaten und Versionierungsfehlern, bei denen oft unklar war, welche Fassung eines Vertrags gültig war.
Zusätzlich zur Effizienzproblematik bestand ein erhebliches Compliance-Risiko. Sensitive Mandantendaten lagen ohne klare Datenhoheit und ohne nachvollziehbare Zugriffsprotokolle verstreut. Die interne IT-Abteilung, besetzt mit nur zwei Personen, war durch die manuelle Pflege dieser Infrastruktur vollständig überlastet. Eine konsistente Backup-Strategie oder proaktive Sicherheitsmaßnahmen waren in diesem Zustand schlicht nicht mehr darstellbar. Die Notwendigkeit einer strukturierten, zentralen und sicheren Lösung war daher nicht verhandelbar.
Herausforderungen: Warum Standardlösungen nicht reichten
Beim Start des Projekts identifizierten wir vier zentrale Herausforderungen, die über eine einfache Cloud-Migration hinausgingen:
- Heterogene Datenqualitäten: Die Alt-Daten wiesen keine konsistenten Metadaten auf. Filenamen waren willkürlich, und die Zuordnung zu Mandanten war oft nur über Kontextwissen möglich.
- Fachliche Komplexität der Suche: Eine einfache Volltextsuche hätte bei juristischen Dokumenten mit spezifischen Fachbegriffen und komplexen Satzstrukturen zu ungenauen Treffern geführt. Die Suche musste semantisch verstehen, nicht nur Wörter abgleichen.
- Akzeptanz der Anwender: Anwälte sind gewohnt, ihre Dateien lokal zu haben. Der Umstieg auf ein zentrales System erforderte eine hohe Usability und schnelle Antwortzeiten, um Widerstände zu minimieren.
- Regulatorische Anforderungen: Das Rechtswesen unterliegt strengen Verschwiegenheitspflichten. Die Lösung musste nicht nur sicher sein, sondern auch die Nachvollziehbarkeit aller Zugriffe und Änderungen (Revisionssicherheit) lückenlos dokumentieren.
Der Tech-Stack: Tools für eine intelligente Dokumentenbasis
Um diese Herausforderungen zu lösen, nutzten wir einen bewährten Stack aus Microsoft-Technologien, der speziell für Enterprise-Umgebungen optimiert ist:
- Microsoft 365 SharePoint: Diente als zentrale Plattform für die Ablage, Strukturierung und Berechtigungssteuerung der Dokumente.
- Azure Search: Bot die Infrastruktur für die leistungsstarke, skalierbare Indexierung und Abfrage der Dokumenteninhalte.
- Azure Cognitive Services: Stellte die KI-Fähigkeiten bereit, darunter semantische Suche und automatische Metadaten-Extraktion.
- Microsoft Defender for Endpoint: Schützte die Endpunkte der Mitarbeiter vor Malware und unbefugten Zugriffen auf die sensiblen Akten.
- Microsoft Purview (ehemals Compliance): Verwaltete die Retention Policies, DLP-Regeln und die auditierbaren Protokolle für die Compliance-Anforderungen.
Umsetzung: In drei Phasen zur intelligenten Akte
Die Implementierung erfolgte nicht als Big-Bang, sondern in einem kontrollierten, dreistufigen Prozess über einen Zeitraum von 12 Wochen. Dieser Ansatz minimierte das Risiko für den laufenden Betrieb und ermöglichte es, Feedback der Anwender kontinuierlich in die Konfiguration einzuarbeiten.
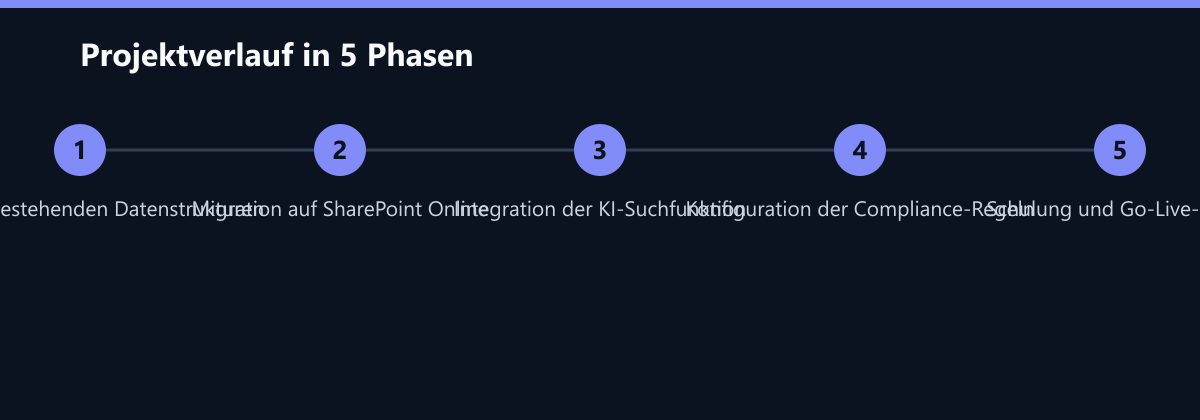
Phase 1: Migration und Strukturierung (Woche 1–4) Der Fokus lag zunächst auf der Schaffung eines sauberen Fundaments. Wir migrierten alle Alt-Daten in SharePoint Online. Dabei war die Definition einer einheitlichen Taxonomie der kritischste Schritt. Wir arbeiteten eng mit den Senior-Partnern zusammen, um eine Logik nach Mandanten, Aktenzeichen und Dokumenttyp zu etablieren. Parallel dazu richteten wir Berechtigungsprofile ein, strikt basierend auf dem Prinzip der geringsten Privilegierung. Jeder Mitarbeiter erhielt nur Zugriff auf die Akten, die er für seine aktuellen Mandate benötigte. Dies reduzierte nicht nur das Sicherheitsrisiko, sondern auch die kognitive Last der Anwender, da sie in einer übersichtlichen Struktur navigierten.
Phase 2: KI-gestützte Suche (Woche 5–8) Nachdem die Daten zentralisiert waren, integrierten wir Azure Cognitive Services. Hier lag der eigentliche Mehrwert. Wir trainierten das Modell auf spezifischen juristischen Fachbegriffen und typischen Dokumentstrukturen. Die KI lernte, dass bestimmte Phrasen in Vertragsklauseln unterschiedliche Bedeutungen je nach Kontext haben können. Zusätzlich implementierten wir eine automatische Metadaten-Extraktion. Das System identifizierte nun Schlüsselinformationen wie Beträge, Vertragspartner und Fristen aus dem Dokumenteninhalt und indexierte diese, ohne dass ein Mitarbeiter sie manuell eintragen musste. Dies war der Schlüssel zur Reduktion der Suchzeit.
Phase 3: Compliance und Monitoring (Woche 9–12) In der finalen Phase stellten wir sicher, dass die Lösung den regulatorischen Anforderungen standhielt. Wir konfigurierten Retention Policies, die eine automatische Archivierung nach 7 Jahren sicherstellen. Dies entlastete die aktive Ablage und garantierte die rechtliche Beweissicherheit. Gleichzeitig implementierten wir DLP-Regeln (Data Loss Prevention), die verhindern, dass sensible Daten per E-Mail oder über externe Dienste aus der Kanzlei abfließen. Abschließend schulten wir die Anwender in der neuen Suchsyntax und den Compliance-Vorgaben, um eine reibungslose Adoption sicherzustellen.
Wie wir die Zahlen messen: Transparenz bei den KPIs
Um den Erfolg objektiv zu belegen, etablierten wir ein Messkonzept, das bereits vor dem Go-Live definiert wurde. Die Baseline der 25 Minuten Suchzeit ergab sich aus einer repräsentativen Stichprobe von 50 Suchanfragen, die wir vor der Migration manuell zeitlich protokolliert hatten. Nach der Einführung nutzten wir die eingebauten Analytics-Tools von Azure Search, um die Antwortzeiten und die Trefferquote zu überwachen.
Die Kennzahl der gewinnenen Produktivität (12 Stunden) wurde über eine anonyme Befragung der Anwender nach 3 Monaten ermittelt. Dabei wurde die Zeitersparnis bei der Dokumentensuche und -ablage quantifiziert und auf die Wochenarbeitszeit hochgerechnet. Die 100 % Revisionssicherheit wurde durch automatische Audits der Versionierungsprotokolle in SharePoint verifiziert, die lückenlose Aufzeichnungen aller Änderungen nachweisen.
Ergebnis: Von der Suche zum strategischen Vorteil
Nach der vollständigen Einführung und einer Stabilisierungsphase zeigte sich eine deutliche und messbare Verbesserung. Die Anwälte fanden relevante Dokumente nun in wenigen Sekunden statt Minuten. Die Transformation war nicht nur technisch, sondern kulturell spürbar.
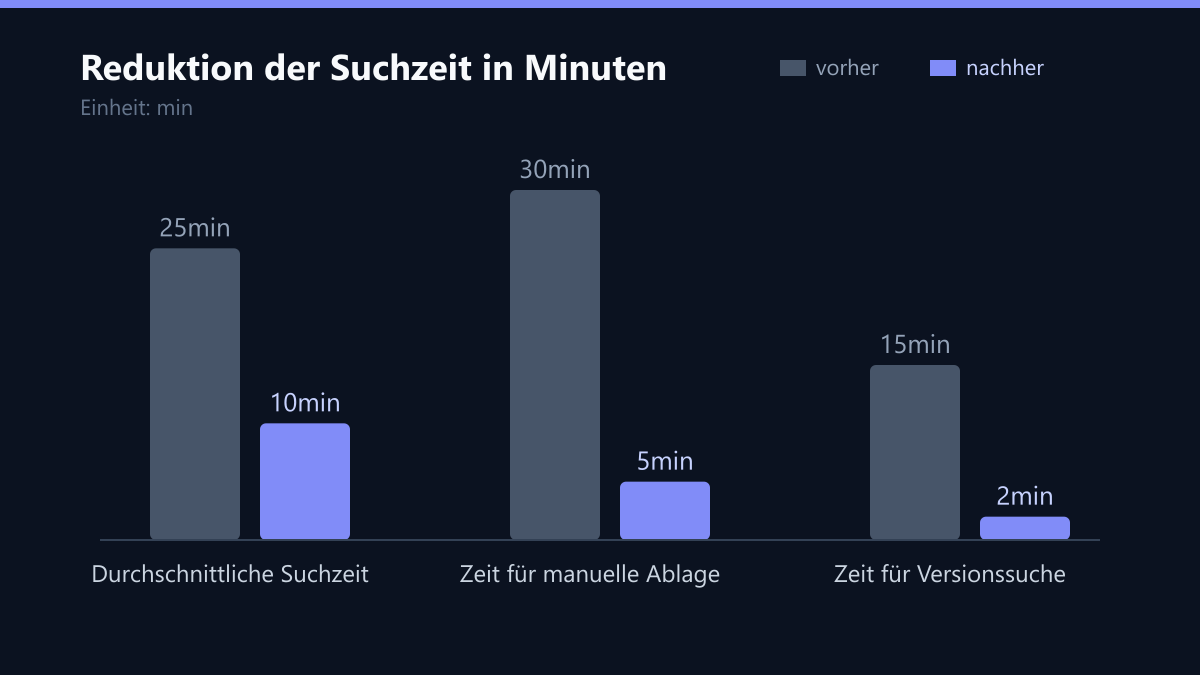
Die Kern-KPIs nach 6 Monaten Betrieb bestätigten den Erfolg:
- Suchzeit: Die Reduktion von 25 auf 10 Minuten pro Anfrage (-60 %) war der direkteste Indikator. Diese Zeitersparnis wurde nicht nur als „schneller“ empfunden, sondern als „genauer“, da die KI die relevantesten Treffer oben anzeigte.
- Produktivität: Die freigesetzten 12 Stunden pro Woche pro Anwalt wurden primär für strategische Beratung und Mandantenpflege genutzt. Dies steigerte die Kundenzufriedenheit und die Marge der Kanzlei erheblich.
- Compliance: 100 % der Dokumente sind zentralisiert und revisionssicher. Die Angst vor Datenverlust oder unbefugtem Zugriff wurde durch die technische Umsetzung der DLP- und Retention-Policies gebannt.
- Sicherheit: Es gab keine Vorfälle bei externen Zugriffen. Die DLP-Policies funktionierten wie ein unsichtbarer Wächter und verhinderten potenzielle Lecks proaktiv.
Die zentrale Ablage eliminierte die Duplikate vollständig. Anwälte arbeiten nun immer mit der aktuellsten Fassung eines Vertrags, was das Risiko von Fehlleistungen durch veraltete Dokumente auf null reduzierte. Das System skaliert nun mühelos mit dem Wachstum der Kanzlei, da die Infrastruktur in der Cloud automatisch Ressourcen nach Bedarf zuweist.
Learnings: Was wir aus dem Projekt mitgenommen haben
Der Erfolg dieses Projekts lag weniger in der Komplexität der Technologie selbst, als in der konsequenten Durchsetzung der Taxonomie und Datenhygiene. Ohne klare Regeln zur Benennung und Ablage hätte die KI-Suche nur „Müll“ indiziert und die Ergebnisse wären unbefriedigend gewesen. Die Technologie ist ein Verstärker der vorhandenen Struktur, nicht ein Ersatz für sie.
Wichtige Erkenntnisse für ähnliche Projekte:
- Frühzeitige Einbindung der Fachabteilung: Die Definition der Metadaten und der Taxonomie muss gemeinsam mit den Domain-Experten (hier: den Anwälten) erfolgen. IT kann die Logik nicht allein definieren.
- KI ersetzt keine Hygiene: Semantische Suche ist mächtig, aber sie kann schlechte Datenqualität nicht kompensieren. Ein „Garbage In, Garbage Out“-Prinzip gilt auch für KI-Modelle.
- Monitoring ist ein Dauerauftrag: Die Suchtrefferquote muss regelmäßig überwacht werden. Wenn Anwender bestimmte Suchbegriffe häufig eingeben, aber keine Treffer erhalten, ist das ein Signal, um das Modell oder die Indexierung zu optimieren.
Die Kombination aus strukturierter SharePoint-Ablage und KI-gestützter Suche hat den Dokumentenfluss von einem operativen Flaschenhals zu einem strategischen Wettbewerbsvorteil gemacht. Die Kanzlei kann nun schneller reagieren, sicherer beraten und effizienter wachsen.
Was wir heute anders machen würden
Trotz des Erfolgs gibt es immer Optimierungspotenziale. Im Nachhinein würden wir zwei Punkte anders angehen:
Erstens hätten wir die Schulungen noch stärker an realen, anonymisierten Fallbeispielen der Kanzlei orientiert, statt nur an generischen Tutorials. Dies hätte die Akzeptanz in der Anfangsphase noch schneller gesteigert. Zweitens hätten wir das Monitoring der Suchqualität von Woche 1 an automatisiert und in ein Dashboard integriert, das die IT-Abteilung täglich abruft. So hätten wir Abweichungen in der Trefferquote noch früher erkennen und korrigieren können, bevor sie von den Anwendern als Problem wahrgenommen wurden. Diese Iterationen sind Teil unseres kontinuierlichen Verbesserungsprozesses, den wir bei künftigen Projekten von Anfang an integrieren werden.