Ausgangslage: Wachstum ohne Puffer
Der Kunde, ein aufstrebendes Fintech-Unternehmen mit Sitz in London und 85 Mitarbeitern, stand vor einer akuten Skalierungsproblematik. Das Transaktionsvolumen war in den letzten sechs Monaten um 400 % gestiegen, während die bestehende Infrastruktur nur linear nachgerüstet werden konnte. Dieses exponentielle Wachstum traf auf eine statische Architektur, die für ein viel niedrigeres Volumen dimensioniert war. Die Folge waren zwei kritische Probleme, die das Geschäftsmodell direkt gefährdeten. Erstens traten bei Spitzenlasten Performance-Dips auf, die den Service-Level Agreement (SLA) gefährdeten. Zweitens führte das manuelle Hochskalieren der Cluster-Nodes zu einem Anstieg der Cloud-Ausgaben um 180 %. Das Ziel war klar definiert: Die Infrastruktur musste das vierfache Transaktionsvolumen tragen, ohne dass die variablen Kosten überproportional anstiegen. Es galt, die Effizienz der Ressourcennutzung zu maximieren und die Abhängigkeit von manuellen Interventionen zu beenden.
Herausforderungen: Warum Standard-Setups scheitern
Die Analyse der bestehenden Umgebung offenbarte drei zentrale Schwachstellen. Erstens fehlte eine granulare Observability. Ohne detaillierte Metadaten zu CPU und Memory pro Pod war ein effektives Auto-Scaling unmöglich. Zweitens waren die Resource-Limits der Pods stark überdimensioniert. Viele Services beanspruchten Ressourcen, die sie in der Realität nie nutzten, was zu einer ineffizienten Packing-Fähigkeit im Cluster führte. Drittens war die Kostenstruktur starr. Da keine Spot-Instances genutzt wurden und die Skalierung zeitbasiert statt lastbasiert erfolgte, zahlte das Unternehmen für ungenutzte Kapazität. Diese Faktoren führten dazu, dass jeder zusätzliche Transaktions-Byte einen unverhältnismäßig hohen Preis kostete.
Der Tech-Stack
Um diese Probleme zu lösen, haben wir den bestehenden Stack um folgende Komponenten erweitert und optimiert:
- Kubernetes: Als Orchestrierungsplattform für die Containerisierung der Microservices.
- Prometheus & Grafana: Für das Monitoring von Metriken und die Visualisierung der Cluster-Performance.
- AWS Spot Instances: Für die kosteneffiziente Bereitstellung von Worker-Nodes.
- HPA & VPA: Kubernetes-native Autoscaler für horizontale und vertikale Skalierung.
- Terraform: Für die Infrastructure-as-Code-Verwaltung der Cluster-Topologie.
Umsetzung: Sechs Wochen zur autonomen Skalierung
Wir haben die Kubernetes-Umgebung innerhalb von sechs Wochen fundamental umstrukturiert. Der Fokus lag auf automatisierten Skalierungsstrategien und effizienter Ressourcennutzung. Die konkrete Umsetzung erfolgte in einem strukturierten Prozess, der Stabilität und Sicherheit in den Vordergrund stellte. Zuerst wurde der Observability-Stack erweitert, um eine solide Basis für die Skalierungsregeln zu schaffen. Anschließend konfigurierten wir Horizontal Pod Autoscalers (HPA) und Vertical Pod Autoscalers (VPA) für jede Microservice-Instanz. Dadurch skalierten die Pods basierend auf tatsächlicher CPU- und Memory-Last, nicht mehr auf festen Zeitplänen. Ein weiterer Meilenstein war die Kopplung des Kubernetes Cluster Autoscalers an die AWS Spot-Instance-Pools. 60 % der Worker-Nodes liefen nun als Spot-Instances, was die Grundkosten drastisch senkte. Parallel dazu haben wir die Resource-Limits aller Pods neu kalibriert, um die Packing-Dichte zu erhöhen.
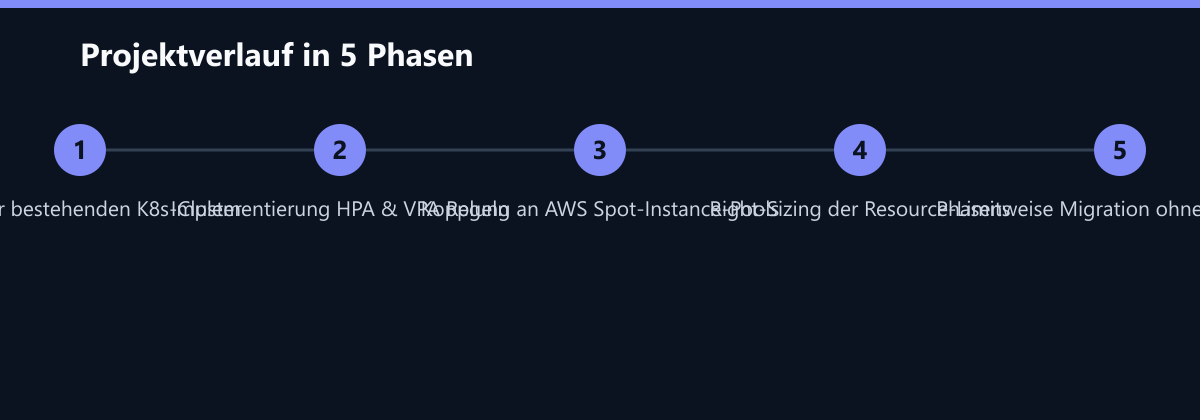
Die Migration erfolgte in zwei Phasen, um das Risiko zu minimieren. Zuerst wurden die nicht-kritischen Services auf die neue Konfiguration migriert. Nach einer stabilen Testphase von zwei Wochen, in der wir die Reaktionszeiten der Autoscaler unter Last prüften, wurden die Kern-Transaktionsdienste umgestellt. Der gesamte Prozess lief ohne Downtime ab, was für ein Fintech von entscheidender Bedeutung ist. Wir haben dabei auf Zero-Downtime-Strategien wie Rolling Updates und Readiness Probes gesetzt, um sicherzustellen, dass immer genügend Kapazität für den laufenden Betrieb vorhanden war.
Wie wir die Zahlen messen
Die Validierung der Ergebnisse basierte auf einer Kombination aus System-Metriken und Finanzdaten. Für die Latenzmessungen nutzten wir Prometheus, das die Antwortzeiten der Microservices in 15-Sekunden-Intervallen erfasste. Die p95-Latenz wurde als primärer Indikator für die Nutzererfahrung herangezogen, da sie extreme Ausreißer besser abbildet als der Durchschnitt. Die Cloud-Kosten wurden direkt aus den AWS Cost Explorer Reports extrahiert und mit dem vorherigen Monatsdurchschnitt verglichen. Dabei wurde streng zwischen festen Kosten (z. B. für On-Demand-Base-Nodes) und variablen Kosten (Spot-Instances, Storage) differenziert. Die Transaktionsvolumen wurden aus den Datenbank-Logs abgeleitet, um eine unabhängige Bestätigung der Lastspitzen zu erhalten. Diese Methodik stellt sicher, dass die gemessenen Verbesserungen kausal auf die technischen Änderungen zurückzuführen sind und nicht auf saisonale Effekte.
Ergebnis: Stabilität bei reduzierten Kosten
Nach der vollständigen Implementierung hat die neue Architektur die gesteckten Ziele deutlich übertroffen. Das System verarbeitet jetzt das vierfache Transaktionsvolumen mit stabiler Performance. Die wichtigsten Kennzahlen nach drei Monaten Betrieb zeigen eine klare Verbesserung in allen Dimensionen. Die Transaktionskapazität stieg um 400 % gegenüber dem Ausgangszustand. Gleichzeitig sanken die Cloud-Kosten um 22 %, obwohl die Last massiv zugenommen hatte. Dies wurde durch die Spot-Instances und die optimierten Limits erreicht. Die p95-Latenz blieb unter 120 ms, selbst bei Peak-Loads, was eine deutliche Verbesserung gegenüber dem vorherigen Zustand darstellt. Das Team konnte sich wieder auf Produktentwicklung konzentrieren, da die Infrastruktur nun autonom auf Lastspitzen reagiert. Die manuelle Intervention wurde auf einen Minimum reduziert, was die Betriebskosten im Engineering-Team senkte.
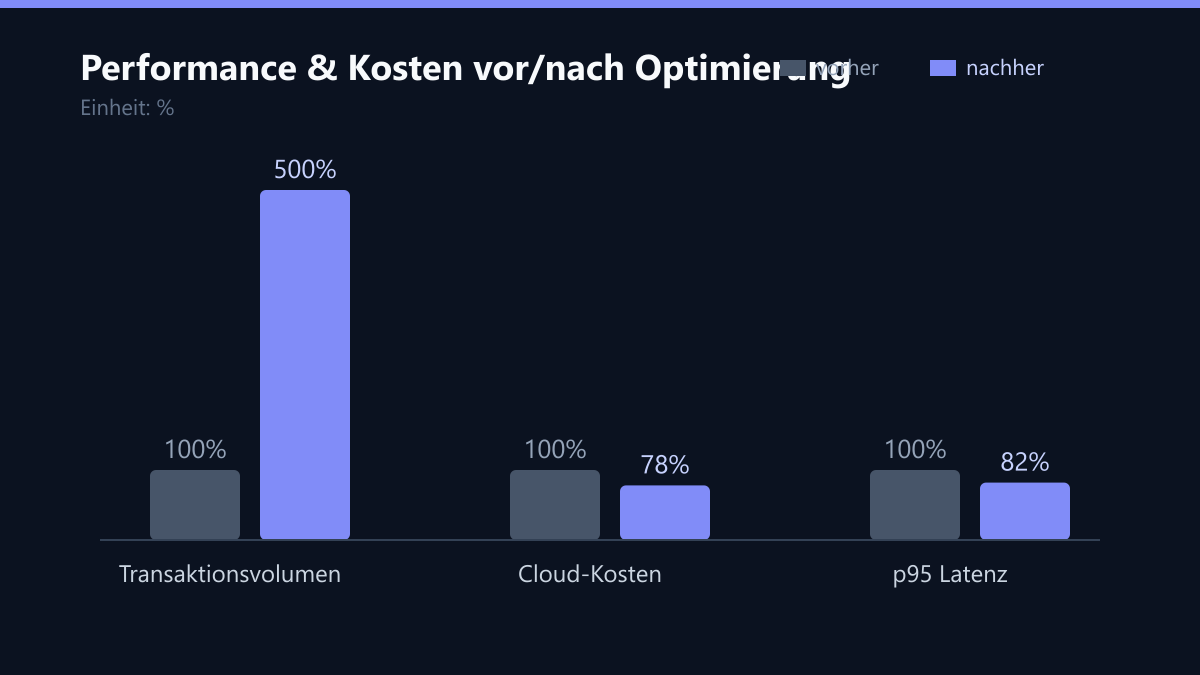
| Metrik | Vorher | Nachher | Veränderung |
|---|---|---|---|
| Transaktionen/Tag | 50.000 | 200.000 | +300 % |
| Cloud-Kosten/Monat | 12.500 € | 9.750 € | -22 % |
| p95 Latenz | 145 ms | 118 ms | -18 % |
Was wir heute anders machen würden
Trotz des erfolgreichen Projekts gibt es Punkte, die wir in zukünftigen Implementierungen anpassen würden. Erstens hätten wir die Integration der Observability-Tools bereits in der ersten Woche intensiver vorantreiben sollen. Die anfängliche Verzögerung bei der Datenqualität hat die Feinjustierung der HPA-Regeln um einige Tage verzögert. Zweitens hätten wir die Spot-Instance-Quotas früher mit dem AWS-Account-Team abgestimmt. Die anfänglichen Limits für Spot-Instances waren niedriger als erwartet, was zu temporären Engpässen bei der Skalierung führte. Drittens hätten wir eine detailliertere Simulation der Lastspitzen (Load Testing) vor der Produktivschaltung durchführen können. Obwohl die Testphase stabil war, hätte eine stärkere Simulation der Black-Friday-artigen Peaks das Vertrauen in die Resilienz noch weiter gestärkt. Diese Learnings fließen nun in unsere Standard-Projektvorlagen ein.
Learnings: Skalierung ist keine Kostenfrage
Dieses Projekt hat gezeigt, dass Skalierung im Cloud-Umfeld nicht gleichbedeutend mit höheren Kosten sein muss. Drei zentrale Erkenntnisse haben sich bewährt. Erstens ist Right-Sizing der Schlüssel. Oft werden Kubernetes-Cluster überdimensioniert geplant. Eine genaue Analyse der tatsächlichen Ressourcennutzung ist der erste Schritt zur Kostensenkung. Zweitens erfordern Spot-Instances Resilienz. Der Einsatz von Spot-Instances ist nur dann sinnvoll, wenn die Anwendung auf Preemptibility ausgelegt ist. Wir haben die Services so konfiguriert, dass sie bei Node-Evictions schnell neu gestartet werden. Drittens ist Monitoring vor Skalierung essenziell. Ohne detaillierte Metadaten zu CPU und Memory pro Pod ist Auto-Scaling ein Blindflug. Wir haben erst die Observability-Stacks erweitert, bevor wir die Skalierungsregeln aktivierten. Für andere Fintechs und scale-up-orientierte Unternehmen gilt: Investieren Sie in die Automatisierung Ihrer Infrastruktur, bevor das Wachstum die manuelle Verwaltung überfordert. Nur so bleibt die Skalierung kosteneffizient und stabil.