Warum Alert Fatigue ein Geschäftsrisiko ist
Alert Fatigue entsteht, wenn IT-Teams durch eine Flut irrelevanter Warnungen überfordert sind. Das Ergebnis ist nicht nur frustrierte Mitarbeiter, sondern ein erhöhtes Risiko, dass echte kritische Vorfälle übersehen werden. Für Geschäftsführer bedeutet das: Die Investition in IT-Sicherheit und Stabilität wird ineffektiv, da die Reaktionszeit auf reale Bedrohungen steigt. In einem Umfeld, in dem jede Minute Ausfallzeit Umsatz kostet, ist die Fähigkeit, das Signal vom Rauschen zu trennen, eine Kernkompetenz der modernen IT-Infrastruktur.
Das Ziel ist Klarheit, nicht Quantität.
- Fokus auf Business-Impact: Nur Warnungen, die den Betrieb oder die Einnahmen gefährden, sind relevant.
- Reduktion des Rauschens: Unnötige Benachrichtigungen werden durch automatische Filter und Gruppierung eliminiert.
- Vertrauen in das System: Das Team weiß, dass jede Alarmmeldung Handlungsbedarf signalisiert.
Wenn ein IT-Mitarbeiter den 50. Alarm an einem Tag ignoriert, weil er „wieder nur ein Netzwerk-Jitter“ vermutet, könnte er gleichzeitig einen Datenbank-Abbruch übersehen. Dieses psychologische Phänomen ist der eigentliche Feind der IT-Sicherheit. Es führt dazu, dass die Wahrnehmungsschwelle für kritische Ereignisse steigt und die Wahrscheinlichkeit eines Kaskadenfehlers dramatisch zunimmt.
Die verborgenen Kosten von übermäßigen Benachrichtigungen
Jede unnötige Alarmierung kostet Zeit und Konzentration. Studien zeigen, dass die Reaktionszeit bei kritischen Vorfällen steigt, wenn das Team zuvor mit Dutzenden falscher Positivs konfrontiert war. Im Mittelstand, wo IT-Teams oft schlank aufgestellt sind, kann dies zu einer Überlastung führen, die langfristig die Fluktuation erhöht. Die Kosten sind dabei nicht nur monetär messbar, sondern zeigen sich vor allem in der Degradierung der Arbeitsqualität.
Typische Auswirkungen:
- Ignorieren von Warnungen: Techniker gewöhnen sich an das Stoppelfeuer und prüfen Alarme nicht mehr gründlich.
- Längere MTTR: Die mittlere Wiederherstellungszeit (Mean Time to Recovery) verlängert sich durch Sucharbeit im Alarmsturm.
- Hohe Support-Kosten: Zeit, die in die Analyse unnötiger Alerts fließt, fehlt für strategische Verbesserungen.
Betrachtet man die Kostenstruktur genauer, lässt sich feststellen, dass die Analyse eines einzelnen Falschalarms im Schnitt 15 bis 20 Minuten dauert. Bei 50 Falschalarmen pro Tag sind das über 12,5 Stunden reiner Produktivitätsverlust täglich. Diese Zeit fehlt für die Entwicklung neuer Services, die Pflege der Dokumentation oder die proaktive Fehlerbehebung. Es ist ein teures Luxusproblem, das in der Bilanz oft nicht direkt als Kostenstelle erscheint, aber die Wettbewerbsfähigkeit langfristig aushölt.
Strategie 1: Definition kritischer Geschäftsziele
Bevor Sie Schwellwerte anpassen, müssen Sie definieren, was für Ihr Unternehmen wirklich kritisch ist. Nicht jeder Server-Crash ist gleich. Ein Ausfall des Backup-Servers ist kritisch, ein Ausfall eines internen Test-Servers nicht. Die Monitoring-Strategie muss an den Service Level Agreements (SLAs) und den Geschäftsprozessen ausgerichtet sein. Oft fehlt genau diese Übersetzung von Geschäftsprozessen in technische Metriken.
Schritte zur Priorisierung:
- Kritische Systeme identifizieren: Welche Anwendungen sind für den Umsatz direkt relevant? Hier lohnt es sich, mit dem Vertrieb und dem Kundenservice zu sprechen, um die „Pain Points“ zu identifizieren.
- Schwellwerte festlegen: Definiere, bei welchem Ressourcenverbrauch (CPU, RAM, Latenz) der Service beeinträchtigt wird. Achte dabei auf die Kausalität: Steigt die Latenz, bevor die CPU voll ist?
- Business-Hours vs. 24/7: Unterscheide zwischen Alarmen, die sofortige Reaktion erfordern, und solchen, die nur am nächsten Morgen gemeldet werden müssen. Nicht jeder Alarm ist ein Notfall.
Diese Schritt-für-Schritt-Analyse stellt sicher, dass das Monitoring-System nicht als „Wächter über alle Hardware“ agiert, sondern als „Schutzschild für den Umsatz“. Wenn ein Server nur für interne Entwicklungszwecke genutzt wird, reicht ein wöchentlicher Statusbericht völlig aus. Eine Echtzeit-Benachrichtigung ist hier reine Ressourcenverschwendung.
Strategie 2: Dynamische Schwellwerte statt statischer Limits
Statische Schwellwerte (z. B. CPU > 80 %) führen oft zu falschen Alarmen, da Lastspitzen je nach Tageszeit variieren. Moderne Monitoring-Tools nutzen Machine Learning, um Normalwerte zu lernen und Abweichungen zu erkennen. Dies reduziert Falschalarme erheblich, da das System zwischen einer erwartbaren Lastspitze um 9:00 Uhr und einer anomalen Auslastung um 3:00 Uhr unterscheiden kann. Die Abkehr von statischen Limits ist der wichtigste Hebel zur Reduktion von Alert Fatigue.
Vorteile dynamischer Thresholds:
- Adaptive Reaktion: Das System passt sich an saisonale oder tageszeitliche Muster an.
- Frühwarnung: Abweichungen vom individuellen Normalzustand werden erkannt, bevor feste Limits erreicht sind.
- Weniger manuelles Tuning: Die Notwendigkeit, Schwellwerte manuell anzupassen, sinkt drastisch.
Ein Beispiel aus der Praxis: Ein Webserver hat um 9:00 Uhr regelmäßig eine CPU-Auslastung von 85 %. Mit einem statischen Schwellwert von 80 % feuert das System jeden Morgen Alarm. Mit einem dynamischen Modell erkennt das System, dass 85 % um 9:00 Uhr normal ist, und meldet erst bei 95 % oder bei einer plötzlichen Steigerung auf 85 % um 3:00 Uhr. Dies eliminiert einen der häufigsten Quellen für Rauschen.
Strategie 3: Aggregation und Gruppierung von Alerts
Oft löst ein einzelnes Problem (z. B. ein Netzwerk-Ausfall) hunderte Einzel-Alerts aus. Ohne Aggregation wird das Team ertränkt. Durch die Gruppierung von verwandten Alarmen wird aus 500 Meldungen eine einzige, zusammengefasste Warnung. Das gibt dem Team einen klaren Überblick über die Ursache und den Umfang des Problems. Aggregation ist kein Nice-to-have, sondern eine Notwendigkeit in komplexen Umgebungen.
Best Practices für Aggregation:
- Root Cause Analysis: Gruppiere Alerts nach Ursache, nicht nur nach Host.
- Dependency Maps: Verbinde Alerts über Abhängigkeiten (z. B. Webserver, App-Server, Datenbank).
- Suppression: Unterdrücke Folgewarnungen, die logisch aus einer bereits gemeldeten Hauptstörung resultieren.
Wenn die Datenbank down ist, werden auch die App-Server und der Webserver Alarm schlagen. Durch die Definition von Abhängigkeiten kann das Monitoring-Tool erkennen, dass die Datenbank die Wurzel ist, und die anderen Alerts unterdrücken oder als „Teil der Störung“ markieren. Das Team erhält dann eine einzige, kohärente Meldung: „Datenbank-Cluster 1 offline, betroffen: 3 Services.“
Typische Fehler bei der Implementierung
Viele Unternehmen scheitern nicht an der Technik, sondern an der Umsetzung. Hier sind die häufigsten Stolperfallen, die Sie vermeiden sollten:
- Zu viele Eskalationsstufen: Wenn jeder Alarm erst durch drei Personen bestätigt werden muss, bevor er bearbeitet wird, steigt die MTTR exponentiell. Halten Sie die Eskalationskette kurz und direkt.
- Fehlende Dokumentation der Regeln: Wenn niemand weiß, warum ein Schwellwert bei 80 % und nicht bei 75 % liegt, wird er bei der nächsten Änderung blind angepasst. Dokumentieren Sie jede Regel mit ihrer Begründung.
- Ignorierung des Feedbacks des Teams: Wenn die IT-Mitarbeiter sagen, dass ein bestimmter Alarm nervt, sollten Sie zuhören. Sie kennen die Systeme am besten. Ein „nicht stören“-Modus für bekannte, unkritische Alerts kann die Akzeptanz deutlich erhöhen.
- Fehlende Trennung von Warnungen und Fehlern: Nicht jeder Alarm ist ein Fehler. Eine Warnung, dass der Speicherplatz bei 90 % liegt, ist eine andere Kategorie als ein Fehler, dass der Dienst nicht erreichbar ist. Verschiedene Kanäle (z. B. Ticket-System vs. Pager) sollten genutzt werden.
So messen Sie den Erfolg
Ohne Messung keine Optimierung. Definieren Sie klare KPIs, um den Erfolg Ihrer Alert-Optimierung zu bewerten:
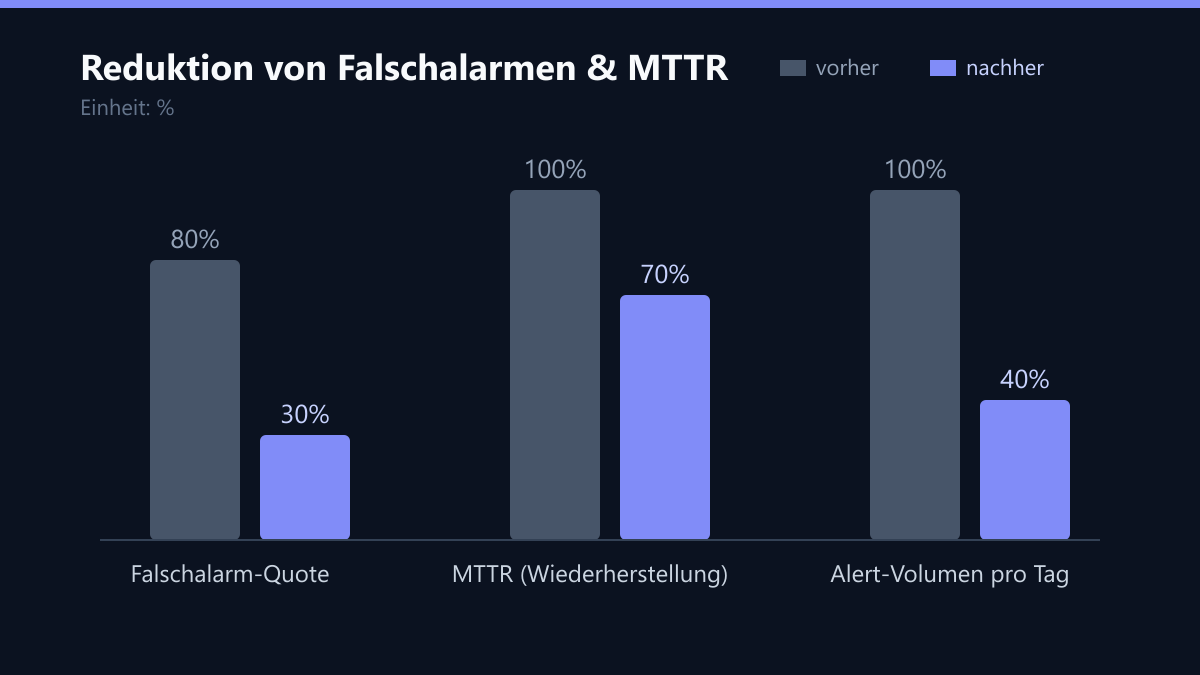
- Falschalarm-Quote: Anteil der Alerts, die als nicht relevant eingestuft werden. Ziel: Unter 10 %.
- Mean Time to Recovery (MTTR): Durchschnittliche Zeit von der Alarmierung bis zur Wiederherstellung. Ziel: Reduktion um 20–30 %.
- Alerts pro Mitarbeiter pro Schicht: Absolute Anzahl der zu bearbeitenden Alerts. Ziel: Maximal 5–10 relevante Alerts pro Schicht.
- Eskalationsrate: Wie oft muss ein Alarm an die nächste Ebene eskaliert werden? Eine hohe Rate deutet auf fehlende Kompetenz oder falsche Priorisierung hin.
Erstellen Sie einen monatlichen Report, der diese Kennzahlen visualisiert. Wenn die Falschalarm-Quote steigt, ist es Zeit für ein Review der Schwellwerte. Wenn die MTTR steigt, obwohl die Alert-Quote sinkt, liegt das Problem möglicherweise in der Aggregation oder der Eskalationslogik.
Checkliste für die Umsetzung
Nutzen Sie diese Checkliste, um den Übergang von der Theorie zur Praxis zu strukturieren:
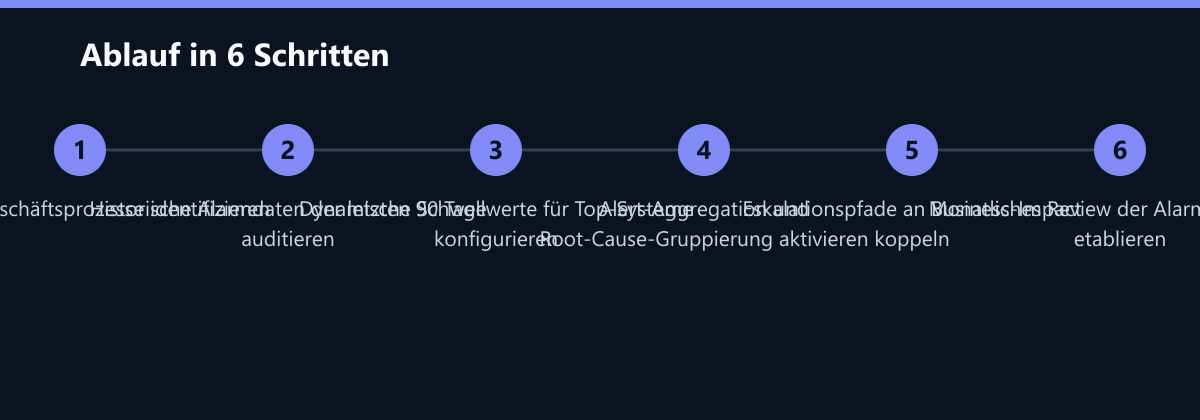
- Audit durchführen: Analysieren Sie historische Alarmdaten der letzten 90 Tage auf Falschpositive.
- Schwellwerte anpassen: Setzen Sie Limits basierend auf Business-KPIs, nicht nur auf Hardware-Werten.
- Aggregation aktivieren: Konfigurieren Sie Root-Cause-Gruppierung und Dependency Maps.
- Team-Schulung: Stellen Sie sicher, dass alle IT-Mitarbeiter die neue Alarmlogik verstehen.
- Eskalationspfade definieren: Koppeln Sie Eskalationen an den Business-Impact.
- Kontinuierliche Verbesserung: Reviewen Sie die Alarm-Statistiken monatlich und passen Sie die Regeln an.
Die Optimierung von Monitoring ist kein einmaliges Projekt, sondern ein kontinuierlicher Prozess. Beginnen Sie mit einer Analyse der letzten 90 Tage Alarme. Identifizieren Sie die Top 10 der häufigsten Alerts und fragen Sie sich: War diese Warnung notwendig? Hatte sie einen Business-Impact? Wenn nein, deaktivieren oder priorisieren Sie sie herunter. Dieser iterative Ansatz führt zu einem System, das nicht nur überwacht, sondern aktiv zur Stabilität und Effizienz des Unternehmens beiträgt. Indem Sie Alert Fatigue systematisch reduzieren, schaffen Sie eine IT-Umgebung, in der das Team fokussiert, sicher und effizient arbeiten kann – ein entscheidender Wettbewerbsvorteil im digitalen Zeitalter.
Passend dazu
- IT-Beratung & IT-Strategie
- Logistik-Unternehmen senkt Ausfallzeiten durch predictive Monitoring um 40 Prozent
- IT-Monitoring & Observability
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- IT-Ausfallzeiten reduzieren: Proaktive vs. Reaktive Wartungsstrategien
- Monitoring für 500 Remote-Mitarbeiter skalieren, ohne IT-Personal zu erhöhen