Die unsichtbare Bremse: Warum unstrukturierte Daten KI-Projekte scheitern lassen
KI-Modelle sind nur so gut wie die Daten, auf denen sie trainiert werden. Im Mittelstand liegt das Problem selten im Algorithmus, sondern in der Datenbasis. Wertvolle Informationen sind verstreut in Legacy-Systemen, verwaisten Excel-Dateien und isolierten Datenbanken. Diese Fragmentierung führt zu inkonsistenten Ergebnissen, hohen Kosten für manuelle Pflege und letztlich zu KI-Systemen, die als teure Experimente enden, statt produktiv zu sein.
Klare Datenstrukturen sind die Voraussetzung für Automatisierung. Ohne sie bleibt KI ein Black Box, das unzuverlässige Prognosen liefert. Dieser Ratgeber zeigt den Weg von der chaotischen Datenlage bis zur stabilen, nutzbaren KI-Basis.
Schritt 1: Die digitale Landkarte – Bestandsaufnahme und Quellen identifizieren
Bevor Sie bereinigen, müssen Sie wissen, was Sie haben. Der erste Schritt ist eine vollständige Inventarisierung aller Datenquellen. Viele Unternehmen haben keine exakte Übersicht, welche Systeme Daten produzieren, wo diese gespeichert sind und wer dafür verantwortlich ist. Eine Datenkarte ist hier das zentrale Werkzeug. Sie visualisiert die Quellen und ihre Beziehungen zueinander.
Typische Quellen im Mittelstand sind:
- ERP-Systeme (z. B. SAP, Microsoft Dynamics)
- CRM-Datenbanken (z. B. Salesforce, HubSpot)
- Historische Datenbank-Backups und Archive
- Unstrukturierte Dateien (PDF-Verträge, Excel-Listen, E-Mail-Threads)
Definieren Sie für jede Quelle einen klaren Eigentümer und bewerten Sie die Aktualität. Nur so können Sie priorisieren, welche Daten für Ihre spezifische KI-Anwendung relevant sind und welche in den Archiven bleiben dürfen. Ohne diese Klarheit riskieren Sie, dass Ihre KI mit veralteten oder irrelevanten Informationen trainiert wird.
Schritt 2: Der Realitätstest – Datenqualität bewerten und Defizite dokumentieren
Nicht alle Daten sind gleichwertig. Eine objektive Bewertung der Datenqualität erfolgt anhand harter Kriterien: Vollständigkeit, Konsistenz und Genauigkeit. Oft fehlen bei Legacy-Daten wichtige Attribute, oder es gibt widersprüchliche Einträge über verschiedene Systeme hinweg. Ein Kunde hat in der CRM-Datenbank eine andere Adresse als im ERP-System? Das ist ein klassisches Defizit.
Erstellen Sie einen Qualitätsbericht, der die größten Probleme benennt. Typische Beispiele sind:
- Fehlende Pflichtfelder in historischen Aufträgen (z. B. fehlende Steuerschlüssel)
- Doppelte Kundeneinträge durch manuelle Pflege über Jahre hinweg
- Inkompatible Datenformate zwischen Abteilungen (z. B. Datum als Text vs. Datumsfeld)
Dieser Bericht ist keine Kritik an den Mitarbeitern, sondern die Entscheidungsgrundlage für die folgenden Schritte. Er hilft, unrealistische Erwartungen an die KI zu vermeiden und den tatsächlichen Aufwand für die Bereinigung realistisch einzuschätzen.
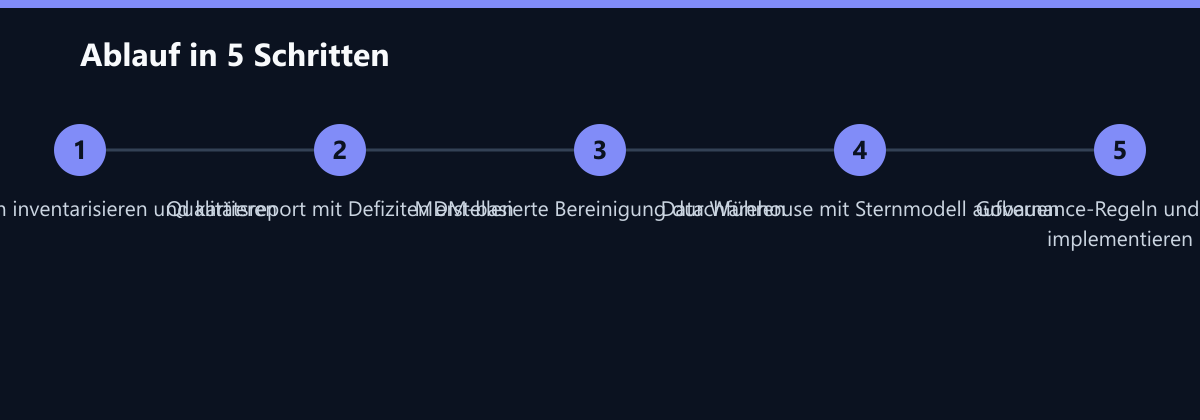
Schritt 3: Der Feinschliff – Bereinigung und Standardisierung via MDM
Nun beginnt die eigentliche Arbeit: Die Daten müssen bereinigt und auf ein gemeinsames Format gebracht werden. Standardisierung bedeutet, dass gleiche Informationen in allen Systemen gleich benannt und formatiert sind. Master Data Management (MDM) ist hier das zentrale Konzept. Es stellt sicher, dass es eine „Single Source of Truth“ für kritische Daten gibt.
Konkrete Maßnahmen umfassen:
- Vereinheitlichung von Adressformaten und Telefonnummern
- Auflösung von Dubletten durch automatisierte Matching-Verfahren
- Ergänzung fehlender Daten durch Referenzlisten oder gezielte manuelle Korrektur
- Konvertierung alter Datentypen in moderne Standards
Nutzen Sie hierfür spezialisierte ETL-Tools (Extract, Transform, Load). Manuelle Bereinigung in Excel ist bei großen Datenmengen ineffizient, fehleranfällig und nicht skalierbar. Automatisierte Skripte sorgen für reproduzierbare Ergebnisse. Wenn Sie heute eine Regel definieren, wird sie morgen auf 10.000 Datensätze angewendet – konsistent und ohne Ermessensspielraum.
Schritt 4: Das Herzstück – Strukturierung im zentralen Data Warehouse
Bereinigte Daten sollten in einem zentralen Speicherort zusammengeführt werden. Dies ist oft ein Data Warehouse oder ein Data Lakehouse. Diese Architektur trennt die operative Verarbeitung in den Fachsystemen von der analytischen Nutzung in der KI-Umgebung. Ein sternförmiges Datenmodell mit Faktentabellen (z. B. Verkäufe) und Dimensionstabellen (z. B. Kunden, Produkte, Zeit) ist bewährt, um komplexe Analysen und schnelle Abfragen zu ermöglichen.
Die Vorteile der Zentralisierung sind messbar:
- Einheitliche Datenansicht für alle Abteilungen
- Beschleunigte Ladezeiten für KI-Modelle
- Einfache Überwachung der Datenqualität an einem Punkt
- Skalierbarkeit bei wachsenden Datenmengen
Bei der Auswahl zwischen Cloud-Lösungen (wie Azure Synapse oder AWS Redshift) und On-Premise-Lösungen sollten Sie Compliance-Anforderungen und die bestehende Infrastruktur prüfen. Für viele Mittelständler ist die Cloud die wirtschaftlichste und sicherste Option, da Updates und Skalierung automatisch erfolgen.
Schritt 5: Nachhaltigkeit – Governance und kontinuierliche Pflege
Datenqualität ist kein einmaliges Projekt, sondern ein fortlaufender Prozess. Etablieren Sie klare Richtlinien für die Datenerfassung, -haltung und -nutzung. Data Governance definiert, wer was tun darf und wie Daten behandelt werden, insbesondere im Hinblick auf DSGVO und NIS2.
Wichtige Bausteine sind:
- Festlegung von Datenverantwortlichen (Data Stewards) in jedem Fachbereich
- Automatisierte Validierungsregeln bei der Datenerfassung (z. B. Pflichtfelder, Formatprüfung)
- Regelmäßige Audits der Datenqualität
- Dokumentation aller Datenflüsse und Transformationen
Ohne Governance verfallen Datenstrukturen schnell wieder in den alten Zustand. KI-Systeme, die auf veralteten oder inkonsistenten Daten trainieren, liefern unzuverlässige Prognosen. Investieren Sie in Prozesse, die die Qualität langfristig sichern, statt nur in die einmalige Bereinigung.
Typische Fehler bei der Datenmigration
Auch erfahrene Teams machen bei der Vorbereitung der Datengrundlage häufig dieselben Fehler. Diese können ein KI-Projekt verzögern oder den Nutzen deutlich mindern.
- Der „Big Bang“-Ansatz: Unternehmen versuchen, alle Systeme gleichzeitig zu migrieren. Das führt zu Chaos und Verzögerungen. Besser ist ein phasenweises Vorgehen mit klaren Meilensteinen.
- Fehlende Datenverantwortliche: Wenn niemand die Datenqualität im Tagesgeschäft verantwortet, entstehen neue Dubletten und Fehler schneller, als sie bereinigt werden. Governance braucht Menschen, nicht nur Regeln.
- Ignorieren der DSGVO: Daten werden bereinigt und in Cloud-Dienste geladen, ohne zu prüfen, ob Pseudonymisierung oder Löschfristen eingehalten wurden. Das birgt erhebliche rechtliche Risiken.
- Manuelle Bereinigung in Excel: Bei Datenmengen über 10.000 Datensätzen ist Excel ungeeignet. Es fehlen Validierungsregeln, und Fehler bleiben oft unbemerkt. Nutzen Sie ETL-Tools für Reproduzierbarkeit.
So messen Sie den Erfolg Ihrer Datenstrategie
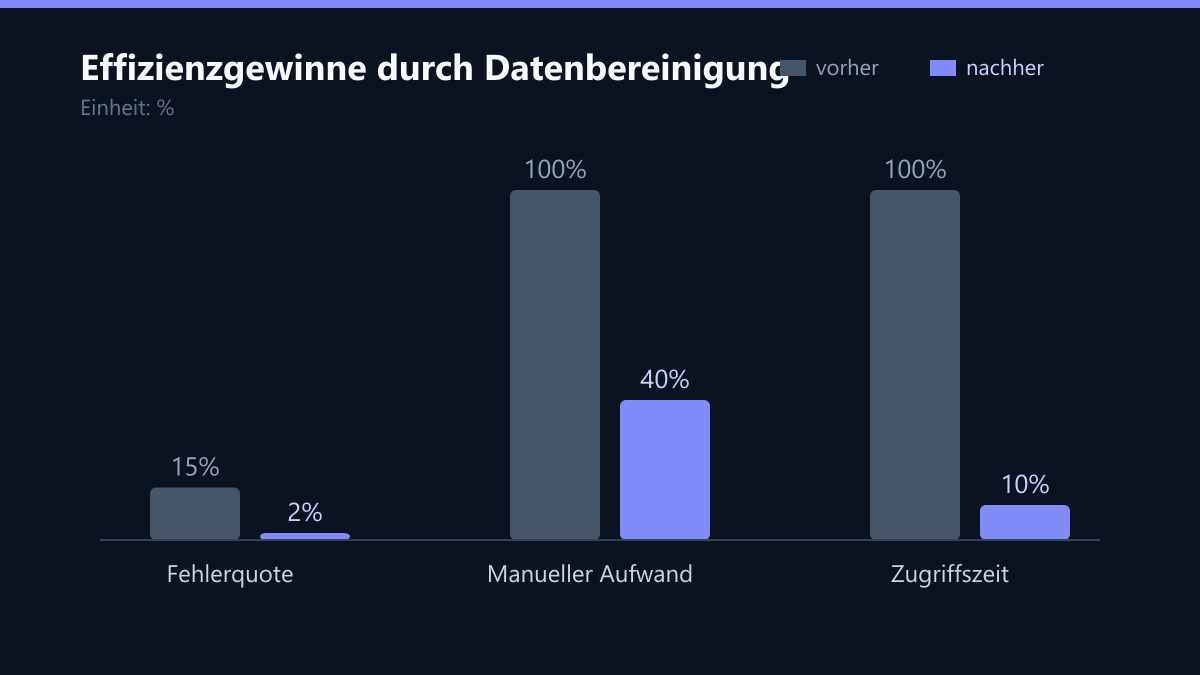
Ohne Messung keine Verbesserung. Definieren Sie klare KPIs, um den Erfolg Ihrer Maßnahmen zu quantifizieren. Hier sind drei konkrete Kennzahlen, die Sie vor und nach der Implementierung tracken sollten:
- Fehlerquote in kritischen Datenfeldern: Messen Sie, wie viele Datensätze in Ihren Top-10-Feldern (z. B. Kunden-IDs, Adressen) fehlerhaft sind. Ziel: Senkung von z. B. 15% auf unter 2%.
- Manueller Aufwand für Datenpflege: Erfassen Sie die Stunden, die Mitarbeiter pro Woche für manuelle Korrekturen und Abgleiche aufwenden. Ziel: Reduktion um mindestens 40% durch Automatisierung.
- Zeit bis zur Datenverfügbarkeit (Time-to-Data): Wie lange dauert es, bis ein neuer Datensatz in der KI-Umgebung verfügbar ist? Ziel: Reduktion von Tagen auf Stunden oder Minuten.
Diese Kennzahlen liefern die Argumente für das Management, weitere Investitionen in Data Governance zu genehmigen.
Checkliste für die Umsetzung
Nutzen Sie diese Checkliste, um Ihren Weg zur sauberen Datengrundlage zu strukturieren:
- Inventar erstellt: Alle Datenquellen sind identifiziert und in einer Datenkarte visualisiert.
- Qualitätsreport vorliegt: Die größten Defizite (Dubletten, fehlende Felder) sind dokumentiert.
- MDM-Strategie definiert: Regeln für die Standardisierung und Dublettenauflösung sind festgelegt.
- Data Warehouse konzipiert: Das Datenmodell (Sternschema) ist entworfen und die Infrastruktur (Cloud/On-Prem) gewählt.
- Governance-Regeln etabliert: Datenverantwortliche sind benannt und Validierungsregeln im ERP/CRM aktiviert.
- Pilot läuft: Eine erste KI-Anwendung nutzt die bereinigten Daten und liefert messbare Ergebnisse.
Fazit: Investition in die Zukunft
Die Modernisierung der Datengrundlage ist keine Kostenstelle, sondern eine Investition in die Zukunftsfähigkeit Ihres Unternehmens. Cloud-basierte KI-Dienste und automatische Datenqualitäts-Tools reduzieren den manuellen Aufwand erheblich. Die Kosten-Nutzen-Rechnung zeigt oft, dass die Einsparungen durch effizientere Prozesse und bessere Entscheidungen die Investitionen schnell amortisieren.
Planen Sie die Migration in Phasen. Beginnen Sie mit einem Pilotprojekt in einem Fachbereich, um Erfolge zu demonstrieren, bevor Sie die gesamte Organisation umstellen. So schaffen Sie eine stabile Basis, auf der Ihre KI-Strategie nachhaltig aufbauen kann.