Die Ausgangslage: Hybride Komplexität ohne 24/7-Augen
Der Kunde ist ein spezialisierter Zulieferer für Antriebskomponenten mit einem Werk in Oberbayern. Mit 450 Mitarbeitern und einer komplexen hybriden Infrastruktur, die lokale Server mit Azure-Workloads kombiniert, stand die IT-Abteilung vor einer enormen Herausforderung. Das interne IT-Team bestand aus 12 Vollzeitkräften, die zwar technisch hochqualifiziert waren, aber schlicht nicht in der Lage, eine durchgehende 24/7-Überwachung sicherzustellen.
Das Problem war struktureller Natur: Kritische Sicherheitsvorfälle, die oft in den Nachtstunden oder am Wochenende eintraten, wurden erst am nächsten Werktag bemerkt. In der Automobilindustrie, wo Stillstandskosten pro Stunde exponentiell steigen können, war eine durchschnittliche Dwell Time von 48 Stunden ein unkritisches Risiko, das jedoch immense finanzielle und reputationsbezogene Gefahren barg. Die IT-Abteilung agierte reaktiv, nicht proaktiv. Jeder Alarm, der über das Wochenende eintraf, blieb unbeachtet, bis ein Mitarbeiter am Montagmorgen die Logs prüfte. Dieser „Blindspot“ war der kritischste Schwachpunkt der gesamten Sicherheitsarchitektur.
Herausforderungen im Detail
Bevor wir mit der Umsetzung begannen, haben wir vier zentrale Herausforderungen identifiziert, die eine einfache Überlagerung eines Monitoring-Tools nicht gelöst hätten:
- Fragmentierte Log-Quellen: Logs aus lokalen Windows-Servern, Azure-Cloud-Diensten und Netzwerk-Geräten lagen in verschiedenen Systemen vor. Es gab keine zentrale Sichtbarkeit.
- Alert-Fatigue im internen Team: Die 12 IT-Mitarbeiter waren überlastet. Jede manuelle Prüfung von Logs bindet wertvolle Kapazität, die für strategische Projekte benötigt wird.
- Fehlende Playbooks: Es gab keine standardisierten Abläufe für die Reaktion auf Vorfälle. Jeder Incident wurde ad-hoc behandelt, was zu inkonsistenten Reaktionszeiten führte.
- Compliance-Druck: Als Tier-1-Zulieferer unterliegt der Kunde strengen Compliance-Anforderungen, die eine lückenlose Protokollierung und schnelle Reaktion erfordern.
Der Tech-Stack: Präzision statt Overhead
Um diese Herausforderungen zu lösen, haben wir einen schlanken, aber leistungsfähigen Tech-Stack konzipiert. Der Fokus lag auf der Integration bestehender Microsoft-Lizenzen, um Kosten zu minimieren und die Lernkurve für das interne Team flach zu halten.
- Microsoft Sentinel: Diente als zentrale SIEM-Plattform (Security Information and Event Management). Alle Logs aus lokalen und Cloud-Umgebungen wurden hier aggregiert.
- Azure Monitor: Verwaltete die Metriken und Health-Checks der Azure-Workloads und floss Daten direkt in Sentinel.
- Power Automate: Diente als Backbone für die automatisierten Playbooks. Hier wurden die logischen Abläufe für Eskalationen und Countermeasures definiert.
- Microsoft 365 Defender: Integriert für die Endpoint-Detection and Response (EDR) auf den lokalen Geräten und in der Cloud.
- Custom Dashboards in Power BI: Dienten der visuellen Darstellung der Sicherheitslage für das Management und die Compliance-Abteilung.
Umsetzung: Von der Inventarisierung zum 24/7-SOC
Die Implementierung erfolgte in drei klar definierten Phasen über einen Zeitraum von 12 Wochen. Wir haben bewusst nicht versucht, alles auf einmal umzusetzen, sondern haben die Stabilität der bestehenden Systeme priorisiert.
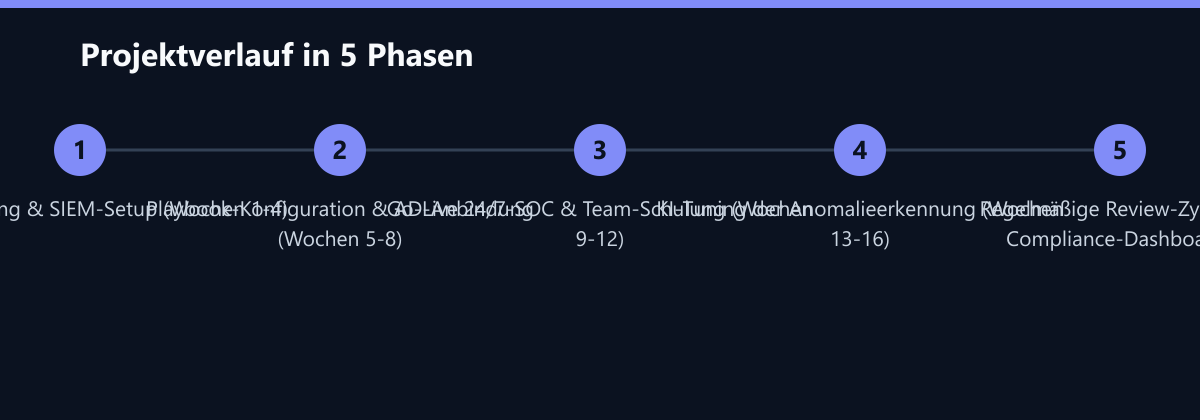
Phase 1: Fundament & Sichtbarkeit (Wochen 1-4)
Zu Beginn stand die vollständige Inventarisierung aller Endpunkte und Server im Vordergrund. Wir haben jede Komponente der hybriden Landschaft katalogisiert und die Log-Quellen identifiziert. Parallel dazu haben wir Microsoft Sentinel als zentrale SIEM-Plattform implementiert. Der Fokus lag hier nicht auf der Detektion, sondern auf der Sichtbarkeit. Wir mussten sicherstellen, dass alle relevanten Daten aus den lokalen Active Directory Domains und den Azure-Workloads in Sentinel einlaufen. Diese Phase war arbeitsintensiv, da wir Legacy-Systeme identifizieren mussten, die noch nie zentral überwacht wurden.
Phase 2: Automatisierung & Anbindung (Wochen 5-8)
Mit der vollständigen Datenerfassung konnten wir die Konfiguration der Playbooks beginnen. Hier lag der Schwerpunkt auf der Automatisierung der Eskalationspfade. Wir haben definierte Regeln erstellt, die bei kritischen Alerts automatisch das interne IT-Team und den SOC-Manager benachrichtigen. Gleichzeitig haben wir die Azure-Workloads und die lokalen Active Directory Domains tiefgreifend angebunden, um Korrelationsanalysen zwischen Cloud und On-Premise zu ermöglichen. Ziel war es, dass das System nicht nur meldet, sondern bereits eine vordefinierte Reaktion auslöst.
Phase 3: Go-Live & Schulung (Wochen 9-12)
In der finalen Phase ging das 24/7-Monitoring live. Der SOC (Security Operations Center) übernahm die primäre Verantwortung für die Überwachung. Ein entscheidender Bestandteil dieser Phase war die Schulung des internen IT-Teams. Wir haben den Mitarbeitern gezeigt, wie sie mit dem SOC zusammenarbeiten, wie sie die Dashboards interpretieren und wie sie im Falle eines echten Incidents die richtigen Schritte einleiten. Diese Kollaboration war essenziell, um die Akzeptanz der neuen Prozesse im Unternehmen zu fördern.
Wie wir die Zahlen messen
Um die Wirksamkeit der Lösung zu belegen, haben wir einen stringenten Messplan erstellt. Die Kennzahlen werden nicht nur stichprobenartig, sondern kontinuierlich erhoben und im Rahmen wöchentlicher Reviews mit dem Kunden analysiert.
- Mean Time to Detect (MTTD): Gemessen wird die Zeitspanne zwischen dem Eintritt eines simulierten oder realen Sicherheitsvorfalls und dem Moment, in dem der SOC-Alert ausgelöst wird. Wir nutzen sowohl reale Incidents als auch gezielte Red-Team-Übungen, um die MTTD zu validieren.
- Mean Time to Respond (MTTR): Hier wird die Zeit vom Alert bis zur erfolgreichen Absicherung oder Eskalation an das interne Team gemessen. Diese Metrik wird pro Incident protokolliert und monatlich aggregiert.
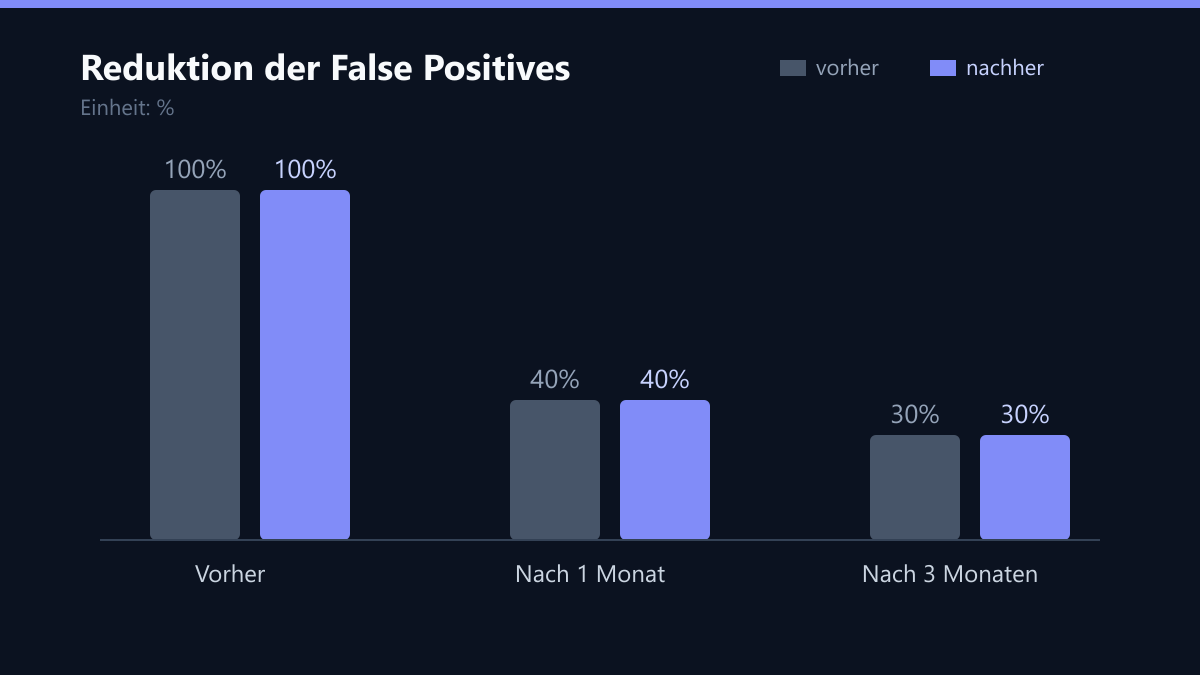
- False Positives: Wir zählen die Anzahl der Alerts, die nach einer manuellen Prüfung als harmlos eingestuft werden. Durch die Einführung der KI-gestützten Filterung wird diese Zahl monatlich im Vergleich zur Baseline vor der Implementierung gemessen.
- Dwell Time: Diese Metrik ist komplexer, da sie die Zeit misst, die ein Angreifer im System bleibt, bevor er entdeckt wird. Wir schätzen diese basierend auf der MTTD und der Häufigkeit der durchgeführten Penetrationstests.
Ergebnis: Von reaktiv zu proaktiv
Nach drei Monaten im Betrieb zeigte sich eine deutliche und messbare Verbesserung der Sicherheitslage. Die Zahlen sprechen für sich:
- Mean Time to Detect (MTTD): Reduktion von 48 Stunden auf unter 2 Stunden. Dies entspricht einer Senkung der Dwell Time um 60 %.
- Mean Time to Respond (MTTR): Senkung um 45 % durch automatische Playbooks. Das interne Team erhält nun präparierte Informationen, was die Entscheidungsfindung beschleunigt.
- False Positives: Rückgang um 70 % dank KI-gestützter Filterung. Das SOC konzentriert sich nur noch auf relevante Vorfälle.
Das interne IT-Team konnte sich wieder auf strategische Projekte konzentrieren, statt sich mit nächtlichen Alarmen zu beschäftigen. Die Compliance-Reporting-Pflichten wurden durch automatisierte Dashboards vereinfacht. Statt manuell Berichte zu erstellen, generiert das System jetzt automatisch die benötigten Auswertungen für Audits. Dies hat nicht nur Zeit gespart, sondern auch das Risiko von Fehlern in den Berichten minimiert.
Was wir heute anders machen würden
Rückblickend gibt es zwei Punkte, die wir in einem ähnlichen Projekt optimieren würden:
- Frühere Einbindung der Compliance-Abteilung: In der ersten Phase haben wir die Compliance-Anforderungen etwas zu spät einbezogen. Hätten wir die Compliance-Abteilung von Anfang an in die Definition der Alert-Regeln eingebunden, hätten wir die Dashboards noch passgenauer gestalten können.
- Stärkere Automatisierung der ersten Phasen: Die Inventarisierung in Phase 1 war manuell aufwendiger als erwartet. Heute würden wir stärker auf automatisierte Discovery-Tools setzen, um die Bestandsaufnahme schneller und präziser zu erstellen.
Learnings und Fazit
Die erfolgreiche Implementierung basierte auf einer engen Zusammenarbeit zwischen Core IT Services und dem Kunden. Die Integration bestehender Microsoft-Lizenzen in die SIEM-Lösung minimierte die zusätzlichen Kosten und beschleunigte die Akzeptanz im Unternehmen. Regelmäßige Tune-ups der Alerting-Regeln waren entscheidend, um die Relevanz der Meldungen hochzuhalten.
Für Unternehmen mit hybriden Infrastrukturen ist ein zentrales Monitoring über alle Standorte hinweg unerlässlich, um Sicherheitslücken zu schließen. Die Erfahrung zeigt, dass 24/7-Monitoring nicht nur eine Frage der Sicherheit ist, sondern auch der Effizienz. Wenn das interne Team von Routineaufgaben befreit wird, kann es sich auf die Innovationskraft des Unternehmens konzentrieren. Genau das ist der wahre Wert eines modernen MSSP-Service: Nicht nur Schutz, sondern Freiheit für das Kerngeschäft.
Passend dazu
- IT-Monitoring & Observability
- Managed Security (MSSP)
- Cloud Services & Cloud-Migration
- Berlin Fintech Reduces Audit Preparation Time by 65% Through Continuous Compliance Monitoring
- Automotive Supplier in Munich: Edge-Cloud Integration Speeds Up Data Processing by 50 Percent
- Securing a Multi-Site Manufacturing Plant in DACH with Unified Endpoint Monitoring and Support
- US Healthcare Network in New York Improves Patient Portal Availability by 60 Percent with Synthetic Monitoring
- Network vs Application Monitoring: Welche Schicht zuerst priorisieren?
- Gamification vs. Traditional Drills: Which Approach Reduces Human Error Faster
- Die 5 häufigsten Ransomware-Angriffsvektoren und wie MSSP-Schutz sie blockt