Das Problem: Zentralisierung als Engpass in der Fertigung
Der Automobilzulieferer mit Sitz in München und 350 Mitarbeitenden stand vor einem klassischen Problem der Industrie 4.0: Die zentrale Datenverarbeitung wurde zum Flaschenhals. Sensordaten von 1.200 Maschinen liefen über das Firmennetzwerk in eine einzige Cloud-Region. Diese Architektur funktionierte in der Theorie hervorragend, scheiterte jedoch an der Praxis der Echtzeit-Fertigung.
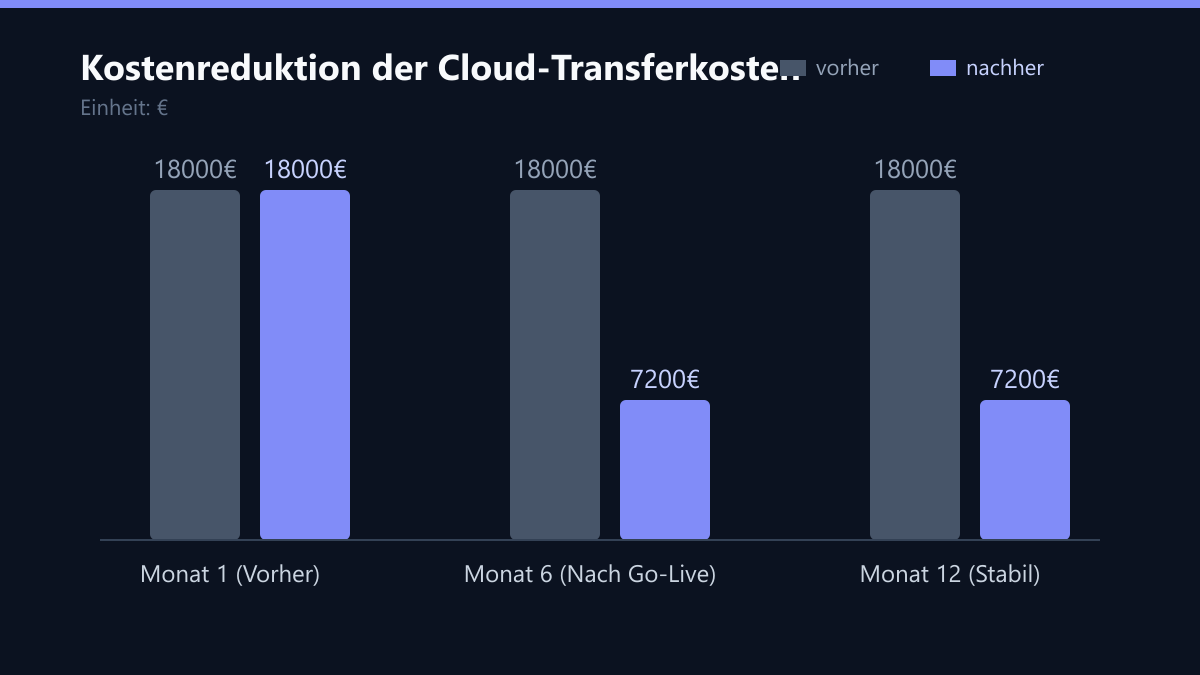
Die Latenzzeit betrug im Durchschnitt 450 Millisekunden. Für menschliche Wahrnehmung ist das kaum messbar, für eine automatische Qualitätskontrolle ist es jedoch eine Ewigkeit. Verzögerte Qualitätsmeldungen führten dazu, dass fehlerhafte Teile erst im Nachhinein erkannt wurden, was Stillstandzeiten und Ausschuss verursachte. Zudem waren die monatlichen Cloud-Transferkosten mit 18.000 Euro nicht mehr tragbar. Das IT-Team war überlastet, da es auf Anomalien in Echtzeit zu langsam reagieren konnte. Die bestehende Infrastruktur war nicht in der Lage, die exponentiell steigenden Datenmengen skalierbar zu bewältigen, ohne dass die Kosten explodierten.
Herausforderungen vor der Umstellung
Bevor wir mit der technischen Umsetzung begannen, mussten wir drei konkrete Herausforderungen lösen, die über reine Latenzprobleme hinausgingen:
- Hardware-Heterogenität: Die 1.200 Maschinen stammten aus verschiedenen Produktionsjahren und verwendeten unterschiedliche Protokolle. Eine einheitliche Anbindung an die Cloud war ohne Zwischenschicht unmöglich.
- Bandbreiten-Kapazität: Das interne Netzwerk war bei Spitzenlasten bereits zu 90 % ausgelastet. Weitere Datenströme zur Cloud wären ein Sicherheitsrisiko für die gesamte Fabrikation gewesen.
- Datenhoheit und DSGVO: Sensitive Produktionsdaten durften nicht ungefiltert in die öffentliche Cloud wandern. Es gab klare Vorgaben, welche Daten lokal bleiben mussten und welche aggregiert werden konnten.
Der Tech-Stack
Für die Lösung setzten wir auf einen bewährten, modularen Stack:
- Azure IoT Hub: Diente als zentrales Einfallstor für die gesicherten Telemetrie-Daten.
- Microsoft Azure ExpressRoute: Stellte eine dedizierte, private Verbindung zwischen den Edge-Nodes und der Cloud her, um Public-Internet-Latenzen zu umgehen.
- Azure Data Lakehouse: Speicherte die aggregierten Daten für historische Analysen und Machine-Learning-Modelle.
- Edge-Gateways (Industrial PCs): Hielten die lokale Filterlogik und agierten als Puffer bei Netzwerkunterbrechungen.
- CI/CD-Pipelines (GitHub Actions): Automatisierten das Deployment der Edge-Software, um Updates konsistent und fehlerfrei zu rollen.
Umsetzung: Von der Analyse zum Go-Live
Wir implementierten eine hybride Edge-Cloud-Architektur innerhalb von 12 Wochen. Der Kerngedanke war die dezentrale Vorverarbeitung direkt an der Quelle. Statt alle Rohdaten nach München oder in die Cloud zu schicken, filterten wir die Daten dort, wo sie entstehen.
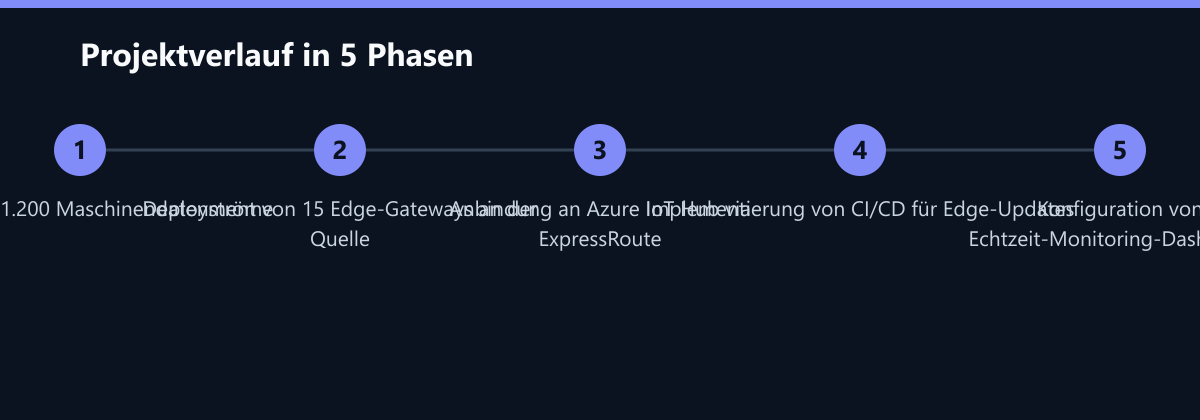
Phase 1: Edge-Node-Deployment Wir installierten 15 Edge-Gateways an den kritischsten Produktionslinien. Diese Nodes übernahmen die Rolle der “Daten-Torschlusshüter”. Sie filterten und aggregierten die Rohdaten lokal. Nur relevante Metadaten, Aggregatwerte und erkannte Ausreißer wurden an die Cloud gesendet. Dies reduzierte den Datenaufkommen sofort um den Faktor 10.
Phase 2: Cloud-Anbindung und Sicherheit Die Edge-Nodes wurden über Azure ExpressRoute mit Microsoft Azure verbunden. Wir konfigurierten den Azure IoT Hub für die sichere, verschlüsselte Datenübertragung. Parallel dazu setzten wir eine Data Lakehouse-Architektur auf, die die aggregierten Daten strukturiert speicherte. Dies ermöglichte es den Datenanalysten, auf bereinigte Daten zuzugreifen, ohne selbst manuelle Bereinigungsprozesse durchlaufen zu müssen.
Phase 3: Automatisierung und Observability Ein entscheidender Faktor für den langfristigen Erfolg war die Automatisierung. Wir richteten CI/CD-Pipelines ein, die das Deployment der Edge-Software automatisierten. Gleichzeitig implementierten wir Monitoring-Tools, die die Konnektivität und Latenz der 15 Nodes in Echtzeit überwachten. Die Fertigungsleitung erhielt intuitive Dashboards, die sofortige Einblicke in die Fertigungslage gaben, ohne dass IT-Mitarbeiter manuell Berichte erstellen mussten.
Wie wir die Zahlen messen
Um die Erfolgsmessung objektiv zu halten, haben wir eine Baseline-Messung über einen Zeitraum von 4 Wochen vor der Implementierung durchgeführt. Wir haben die Latenzzeiten direkt an den Sensor-Schnittstellen und an der Cloud-API gemessen. Die Kostenmessung basiert auf den detaillierten Azure-Usage-Reports, die wir monatlich auditierten.
Die Anomalie-Erkennungszeit wurde über ein simuliertes Fehler-Szenario gemessen: Wir injizierten künstliche Abweichungen in den Datenstrom und maßen die Zeit bis zum ersten Alarm auf dem Dashboard. Vorher waren es im Durchschnitt 5 Minuten (manuelle Prüfung), nachher 30 Sekunden (automatisierte Regelwerk-Prüfung am Edge).
Ergebnis: Messbare Effizienzgewinne
Die neue Architektur lieferte messbare Verbesserungen innerhalb der ersten 90 Tage nach Go-Live. Die Datenverarbeitungsgeschwindigkeit stieg signifikant an, was sich direkt in den operativen Kennzahlen niederschlug.
- Latenzreduktion: Von 450 ms auf 220 ms (-50 %).
- Bandbreiteneinsparung: 60 % weniger Datenverkehr zur Cloud.
- Kostensenkung: Cloud-Transferkosten sanken von 18.000 auf 7.200 Euro monatlich.
- Reaktionszeit: Anomalie-Erkennung von 5 Minuten auf 30 Sekunden verkürzt.
Die Fertigungsleitung nutzt die Echtzeit-Daten nun proaktiv für die Wartung. Statt auf Ausfälle zu warten, werden Maschinen gewartet, bevor sie streiken. Als direkte Folge stieg die OEE (Overall Equipment Effectiveness) um 8 %. Das IT-Team konnte sich von der manuellen Datenbereinigung lösen und konzentriert sich nun auf strategische Projekte wie die Einführung von Predictive Maintenance-Modellen.
Was wir heute anders machen würden
Trotz des Erfolgs gibt es Punkte, die wir in zukünftigen Projekten optimieren würden:
- Frühere Einbindung der Fertigungsleitung: Wir hätten die Produktionsleiter früher in die Definition der “relevanten Metadaten” einbinden sollen. Anfangs wurden einige Datenpunkte gefiltert, die für die Qualitätssicherung doch relevant waren, was zu kleinen Nachjustierungen führte.
- Modularere Edge-Hardware: Wir haben standardisierte Industrial PCs verwendet. Heute würden wir stärker auf Container-basierte Edge-Plattformen setzen, die noch flexibler auf neue Protokolle reagieren.
Learnings und Ausblick
Edge-Computing ist kein Allheilmittel, aber der Schlüssel für Echtzeit-Anforderungen in der Fertigung. Die Vorverarbeitung am Edge reduziert nicht nur Kosten, sondern auch die Komplexität der Cloud-Infrastruktur.
- Skalierbarkeit: Edge-Nodes lassen sich modular erweitern. Neue Maschinen werden in unter 4 Stunden angebunden, da die Logik bereits vorhanden ist.
- Sicherheit: Daten bleiben lokal, bis sie aggregiert sind. Das reduziert die Angriffsfläche für Cyber-Angriffe erheblich.
- ROI: Die Investition in die Edge-Infrastruktur amortisierte sich in 14 Monaten durch Einsparungen und Effizienzgewinne.
Für Unternehmen mit hohen Datenmengen und niedrigen Latenzanforderungen ist die Edge-Cloud-Integration der nächste logische Schritt in der Digitalisierung. Es geht nicht mehr nur um “Cloud vs. On-Premise”, sondern um die intelligente Aufteilung der Rechenleistung dort, wo sie am meisten Wirkung entfaltet.
Passend dazu
- 5 Engpässe bei manueller Datenerfassung und sichere Automatisierung
- RPA vs. iPaaS: Die richtige Architektur für Legacy- und Cloud-Integration
- 5 häufige Fehler bei der Cloud-Migration von Legacy-Software
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- E-Commerce Entwicklung
- 28 % Reduktion der Cloud-Ausgaben für einen US-amerikanischen SaaS-Anbieter
- Azure-Cloud-Kosten um 35 Prozent gesenkt
- Custom ERP-Integration in der Fertigung: Durchlaufzeiten um 15 Prozent verkürzen
- Sicherung der DSGVO-Konformität und Senkung der Latenzzeit um 45 Prozent bei der Cloud-Modernisierung einer E-Commerce-Plattform in Hamburg
- Automated Invoice Processing with OCR and LLM: Reducing Accounting Backlog by 40 Percent in DACH Manufacturing
- Automated Clinical Data Extraction: Accelerating Trial Preparation by 30% for a Berlin-Based Biotech Startup
- Multi-Channel-Integration: Echtzeit-Bestandsmanagement über drei Marktplätze
- GDPR Data Mapping for a US Healthcare Tech Startup: Achieving 100 Percent Record Accuracy and Passing the DPA Audit
- Healthcare Data Protection: Reducing HIPAA Violations by 70 Percent via Micro-Learning for Clinical Staff
- Data Loss Prevention vs Data Recovery: Der Unterschied für IT-Sicherheitsteams
- Hybrid Office Network Design: Wi-Fi 6E, Wired Backbone und Cloud
- SharePoint und Teams Integration für Kanzlei in Frankfurt
- GDPR Data Breach Response: 5 Steps to Minimize Fines and Reputational Damage
- How to Calculate Cloud Savings: A Practical Guide for IT Decision Makers
- Securing BYOD Devices: 5 Essential Policies to Protect Corporate Data
- Automotive Tier-1 Supplier in Bavaria Reduces Dwell Time by 60% with 24/7 MSSP Monitoring
- Cloud-Sicherheit: IAM und Verschlüsselung für sensible Daten
- Preventing Data Leakage in a Singaporean E-Commerce Firm with Cloud Access Security Broker Implementation
- Segmentierungsstrategien in Salesforce Marketing Cloud