Ausgangslage: Das Risiko im Tagesgeschäft
Ein spezialisierter Logistikdienstleister mit 180 Mitarbeitern in Frankfurt am Main stand vor einem kritischen operativen Risiko. Die Kernprozesse – von der Disposition bis zur Sendungsverfolgung – hingen vollständig von der Verfügbarkeit der lokalen Server ab. Bei einem Totalausfall fielen die Dispatch-Systeme aus, was zu einer Downtime von bis zu 24 Stunden führte. In einer Branche, in der Echtzeit-Transparenz und Zuverlässigkeit den Unterschied zwischen einem zufriedenen und einem verärgerten Kunden ausmachen, waren die finanziellen Folgen erheblich: Vertragsstrafen, manuelle Nacharbeit und ein Vertrauensverlust bei den Auftraggebern.
Das bestehende Backup-Konzept basierte auf einer täglichen Vollkopie auf ein Tape-Library-System. Während dies eine einfache Form der Datensicherung darstellte, war es für die Anforderungen an die Geschäftsresilienz unzureichend. Die Wiederherstellung war ein manueller, zeitaufwändiger Prozess: Medien mussten physisch geladen, Daten sequenziell gelesen und Systeme manuell zurückgesetzt werden. Oft dauerte dieser Prozess über 12 Stunden, was die Recovery Time Objective (RTO) faktisch auf 24 Stunden anhob. Die IT-Abteilung benötigte dringend eine Lösung, die die RTO drastisch verkürzt und die Abhängigkeit von manuellem Eingriff minimiert, um die operative Kontinuität sicherzustellen.
Herausforderungen
Die Umsetzung einer robusten Disaster-Recovery-Strategie war mit mehreren spezifischen Herausforderungen verbunden. Erstens stand das Thema Bandbreite im Vordergrund. Die zu sichernden Datenmengen aus den ERP- und TMS-Systemen waren so groß, dass eine reine Cloud-Replikation über die vorhandene Internetanbindung zu langsam gewesen wäre. Zweitens galt es, die Komplexität der bestehenden IT-Landschaft zu managen, ohne den laufenden Betrieb zu stören. Drittens fehlten bisherige automatisierte Testmechanismen, sodass die Integrität der Backups nur durch sporadische, manuelle Stichproben geprüft wurde.
Der Tech-Stack
Um diese Herausforderungen zu meistern, haben wir einen hybriden Ansatz gewählt, der bewährte Technologien kombiniert:
- Backup-Appliance (On-Premises): Eine dedizierte, hochperformante Appliance in der Frankfurter Zentrale dient als lokaler Cache für schnelle Restore-Vorgänge.
- Microsoft Azure (West Europe): Dient als geografisch redundanter Speicherort für die inkrementelle Synchronisation und Langzeitsicherung.
- Automatisierungs-Workflows: Custom Scripts zur Orchestrierung der Backup-Jobs und der Sandbox-Tests.
- IT-Monitoring-Plattform: Bestehendes Tool, das um Backup-Status-Metriken und proaktive Alerts erweitert wurde.
Umsetzung: Von der Analyse zur hybriden Architektur
Wir implementierten eine hybride Backup-Strategie, die die lokale Geschwindigkeit mit der Skalierbarkeit und Redundanz der Cloud kombiniert. Der Fokus lag von Anfang an auf der Automatisierung und der beschleunigten Datenwiederherstellung für die kritischsten Workloads, insbesondere das ERP-System und das Transport Management System (TMS).
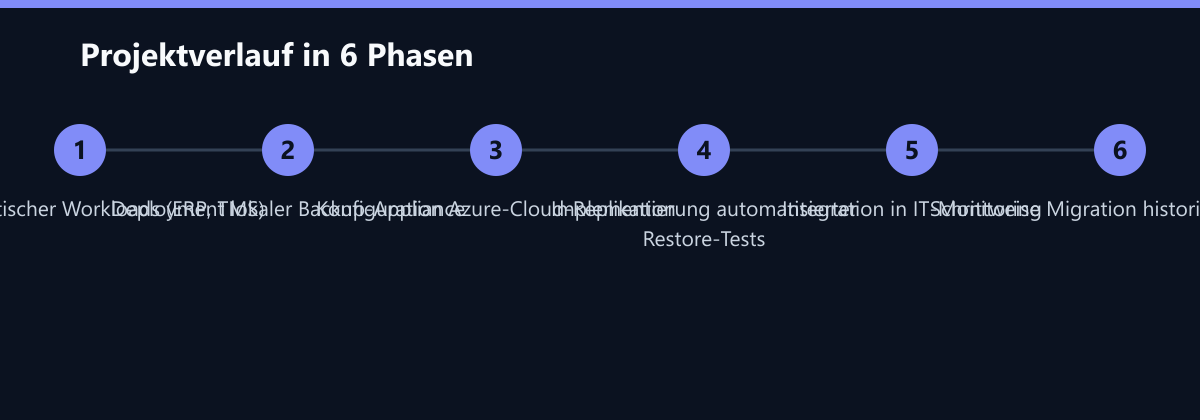
Zuerst erfolgte das Deployment einer dedizierten Backup-Appliance in der Frankfurter Zentrale. Diese Appliance fungiert als lokaler Hochgeschwindigkeits-Cache. Bei einem lokalen Ausfall können die Systeme aus diesem Cache in Minuten statt Stunden wiederhergestellt werden, da keine Wartezeit auf die Internetverbindung anfällt. Parallel dazu wurde eine automatische, inkrementelle Synchronisation nach Microsoft Azure (Region West Europe) konfiguriert. Dies gewährleistet die geografische Redundanz: Sollte das komplette Rechenzentrum in Frankfurt ausfallen, sind die Daten in der Cloud verfügbar.
Ein zentraler Baustein der neuen Strategie war die Einführung automatisierter Test-Wiederherstellungen. Wir richteten eine isolierte Sandbox-Umgebung ein, in der wöchentlich automatisierte Restore-Tests durchgeführt werden. Diese Tests validieren die Integrität der Daten und die Funktionsfähigkeit der Wiederherstellungsprozesse, ohne dass IT-Mitarbeiter manuell eingreifen müssen. Zusätzlich wurden die Backup-Statusdaten in das bestehende IT-Monitoring-System integriert. So erhalten die IT-Verantwortlichen proaktive Alerts, falls ein Backup fehlschlägt oder die RPO-Schwelle überschritten wird, lange bevor ein tatsächlicher Incident auftritt.
Die Migration der historischen Daten in die Cloud erfolgte schrittweise über drei Wochen. Diese Phasenung war entscheidend, um die Produktivität im Tagesgeschäft nicht zu beeinträchtigen und die Netzwerkauslastung zu managen.
Wie wir die Zahlen messen
Die Validierung der neuen Strategie erfolgte durch einen simulierten Disaster-Recovery-Drill. Dabei wurde der lokale Server bewusst offline genommen, um den realen Ausfall eines Datenzentrums zu simulieren. Die Messung basierte auf Zeitstempeln aus dem Monitoring-System und den Logs der Backup-Software.
Die RTO (Recovery Time Objective) wurde gemessen als die Zeit vom Moment des simulierten Ausfalls bis zur vollständigen Verfügbarkeit der kritischen Anwendungen (ERP und TMS) in der Sandbox-Umgebung. Vorher betrug dieser Wert 24 Stunden, da die manuelle Wiederherstellung von Tapes dauerte. Nach der Implementierung lag der Wert bei 4 Stunden, da der Restore aus dem lokalen Cache und die Replikation in die Sandbox automatisch abliefen.
Die RPO (Recovery Point Objective) definiert den maximal akzeptablen Datenverlust. Sie wurde gemessen als der zeitliche Abstand zwischen dem letzten erfolgreichen Backup und dem Zeitpunkt des simulierten Ausfalls. Durch die inkrementelle Synchronisation im 15-Minuten-Takt reduzierte sich dieser Wert von 24 Stunden auf 15 Minuten.
Der manuelle Aufwand wurde durch die Protokollierung der erforderlichen IT-Arbeitsstunden während des Drills erfasst. Vorher waren mehrere Stunden an Facharbeit nötig, um Tapes zu laden und Systeme zu konfigurieren. Nachher bestand der Aufwand lediglich aus der Bestätigung der automatisierten Alerts und dem Umschalten des DNS-Pointers, was den Aufwand auf ein Minimum reduzierte.
Ergebnis: Von 24 Stunden auf 4 Stunden
Nach der vollständigen Inbetriebnahme wurde das neue RTO in dem genannten Disaster-Recovery-Drill validiert. Die Ergebnisse übertrafen die internen Erwartungen deutlich. Die Reduktion der RTO auf 4 Stunden bedeutet, dass bei einem Serverausfall die operativen Prozesse innerhalb eines halben Arbeitstages wieder voll funktionsfähig sind. Dies minimiert das Risiko von Vertragsstrafen und schützt den Kundenstamm.
| Metrik | Vorher | Nachher | Veränderung |
|---|---|---|---|
| RTO (Wiederherstellungszeit) | 24 Stunden | 4 Stunden | -83 % |
| RPO (Datenverlust) | 24 Stunden | 15 Minuten | -98,9 % |
| Manueller Aufwand bei Restore | Hoch | Minimal | Automatisiert |
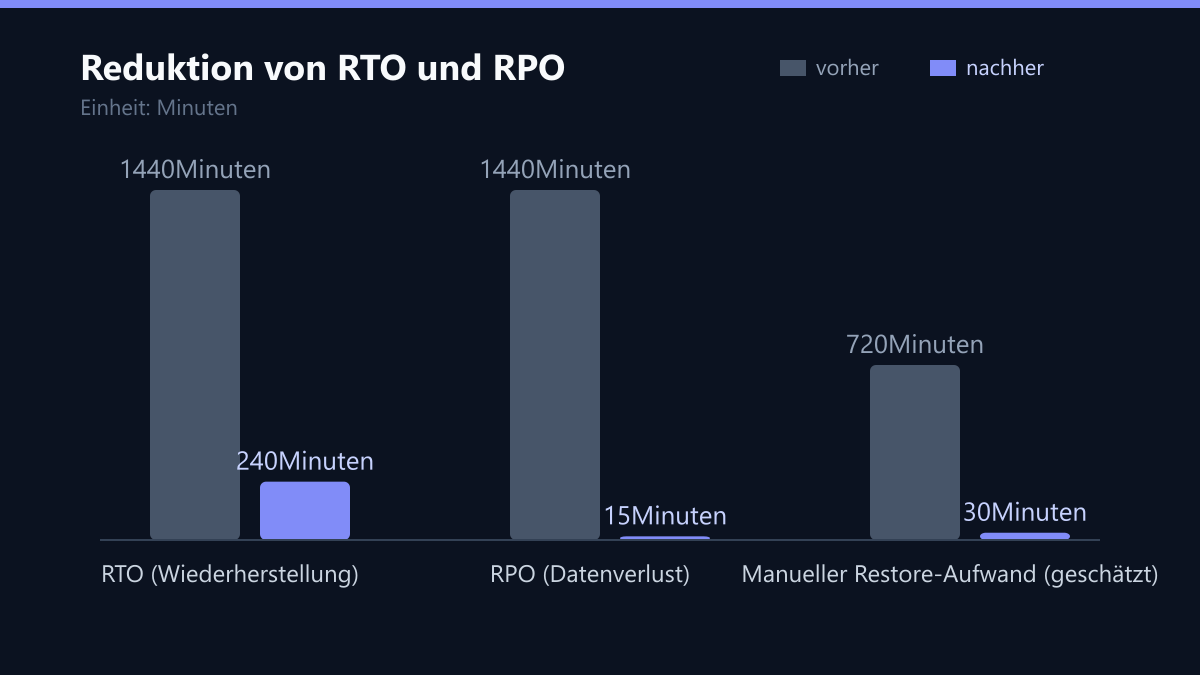
Zusätzlich zur RTO-Verbesserung wurde der RPO von 24 auf 15 Minuten verbessert. Das bedeutet, dass im Worst-Case-Szenario nur noch 15 Minuten an Transaktionsdaten verloren gehen würden, anstatt eines ganzen Tages. Für einen Logistikdienstleister, der hunderte Sendungen pro Stunde verwaltet, ist dieser Unterschied zwischen einem akzeptablen Datenverlust und einem operativen Desaster.
Was wir heute anders machen würden
Trotz des erfolgreichen Projekts gibt es zwei Punkte, die wir bei einer erneuten Umsetzung optimieren würden. Erstens hätten wir die Integration in das Monitoring bereits in der Planungsphase stärker gewichtet. In der Umsetzung zeigte sich, dass die Granularität der Alerts anfangs zu grob war, was zu einigen Fehlalarmen führte. Eine detailliertere Definition der Schwellenwerte am Anfang hätte diese Reibungsverluste vermieden.
Zweitens hätten wir die Schulung des IT-Personals früher in den Prozess eingebunden. Obwohl die Automatisierung den manuellen Aufwand stark reduziert, müssen die Mitarbeiter die Logik hinter den automatisierten Workflows verstehen, um in außergewöhnlichen Situationen korrekt zu reagieren. Eine frühere Einbindung hätte die Akzeptanz und das Vertrauen in das neue System schneller aufgebaut.
Learnings und Ausblick
Das Projekt verdeutlichte, dass Backup nicht nur Datensicherung ist, sondern ein aktiver Bestandteil der Geschäftscontingency-Planung. Drei zentrale Erkenntnisse entstanden aus der Zusammenarbeit:
- Automatisierung ist entscheidend: Manuelle Restore-Prozesse sind der größte Engpass für die RTO. Automatisierte Workflows reduzieren nicht nur die Fehlerquote, sondern befreien auch die IT-Mitarbeiter von repetitiven Aufgaben, sodass sie sich auf strategische Projekte konzentrieren können.
- Lokale Hybrid-Architektur gewinnt: Reine Cloud-Backups stoßen bei großen Datenmengen oft an Bandbreitenlimits. Die Kombination aus lokalem Cache und Cloud-Replikation bietet die beste Balance aus Speed für lokale Restores und Sicherheit durch geografische Redundanz.
- Regelmäßige Tests sind Pflicht: Ein Backup ist nur so gut wie seine letzte erfolgreiche Wiederherstellung. Die automatisierten wöchentlichen Tests sorgen für kontinuierliche Validierung ohne zusätzlichen personellen Aufwand und geben dem Management die Sicherheit, dass im Ernstfall alles funktioniert.
Für den Logistikdienstleister in Frankfurt ist die neue hybride Backup-Strategie nun ein integraler Bestandteil der IT-Resilienz. Die IT-Abteilung hat durch die Automatisierung Kapazitäten freigesetzt, die sie nun in die Optimierung der bestehenden Infrastruktur und die Planung zukünftiger Digitalisierungsprojekte stecken kann.
Passend dazu
- KI-Beratung & KI-Strategie
- Cloud Services & Cloud-Migration
- Backup & Disaster Recovery
- IT-Beratung & IT-Strategie
- Automatisierte NIS2-Readiness-Prüfung senkt Audit-Zeit für mittelständische Logistikfirma in München um 40 Prozent
- IT-Downtime um 42 Prozent senken
- Hybride Azure-DR-Strategie: RTO auf 15 Minuten gesenkt
- Firewall-Strategie: NGFW und Cloud-Firewall in hybriden Umgebungen