Die unsichtbare Last: Warum klassische Monitoring-Tools versagen
In modernen IT-Landschaften ist die Datenflut ein alltägliches Phänomen. Server, Cloud-Dienste und Netzwerkgeräte generieren täglich Terabytes an Log-Daten. Für IT-Teams im Mittelstand wird dies schnell zur unüberschaubaren Herausforderung. Manuelle Auswertungen oder starre Regelwerke stoßen hier an ihre Grenzen, da sie die wachsende Komplexität nicht mehr beherrschen können.
Das eigentliche Kernproblem liegt in der Korrelation. Ein einzelner, scheinbar harmloser Fehler im Netzwerk kann Kaskadeneffekte in der gesamten Anwendungsschicht auslösen. Ohne intelligente Mustererkennung bleibt die wahre Ursache oft verborgen, während die Symptome an der Oberfläche Alarm schlagen. Das führt zu einer Situation, in der Teams mit Informationen überflutet werden, die für die eigentliche Fehlerbehebung irrelevant sind.
Ohne den Einsatz von AIOps (Artificial Intelligence for IT Operations) kämpfen Unternehmen mit drei spezifischen Herausforderungen:
- Alert Fatigue: Die Überflutung durch zu viele Warnmeldungen führt dazu, dass kritische Vorfälle übersehen oder ignoriert werden.
- Hohe MTTR (Mean Time to Repair): Es vergeht viel Zeit, bis die Root Cause identifiziert ist, da Techniker zwischen tausenden Logs hin- und herspringen müssen.
- Skalierungsprobleme: Manuelle Prozesse brechen zusammen, sobald die Infrastruktur wächst. Was für 50 Server funktioniert, scheitert bei 500.
Von Rohdaten zu Handlungsanweisungen: Die AIOps-Mechanik
AIOps nutzt Machine Learning und KI-Technologien, um historische und Echtzeit-Daten zu analysieren. Das System lernt kontinuierlich das normale Verhalten der Infrastruktur und erkennt Abweichungen automatisch. Es geht hier nicht darum, nur Symptome zu melden, sondern kausale Zusammenhänge zu identifizieren.
Ein konkretes Beispiel: Ein CPU-Spike auf einem Server wird nicht einfach als “Hohe CPU-Auslastung” gemeldet. Die KI erkennt, dass dieser Spike durch eine spezifische, ineffiziente Datenbankabfrage ausgelöst wurde, die wiederum durch einen unerwarteten Lastspike im Frontend verursacht wurde. Diese kausale Kette ermöglicht es, direkt an der Ursache anzusetzen, statt nur die Symptome zu behandeln.
Die Kernfunktionen, die diese Transformation ermöglichen, umfassen:
- Anomalie-Erkennung: Identifiziert ungewöhnliche Muster in Echtzeit, die von der erlernten Norm abweichen.
- Event-Korrelation: Bündelt tausende Einzel-Alerts zu einem einzigen, relevanten Incident. Statt 500 Mails erhält das Team eine einzige, priorisierte Warnung.
- Prädiktive Analyse: Warnt vor potenziellen Ausfällen, bevor sie eintreten, basierend auf historischen Trends.
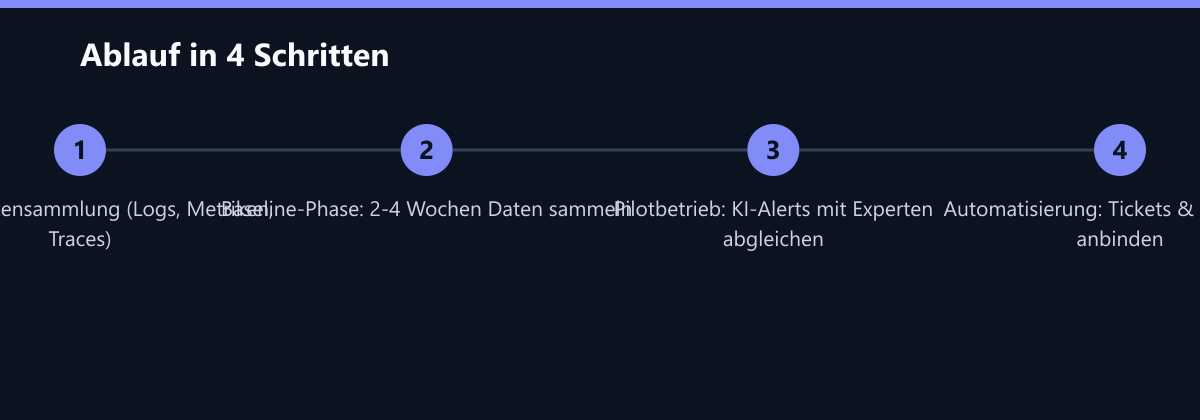
Der schrittweise Implementierungsweg in 4 Phasen
Die Einführung von AIOps erfordert keine sofortige Neuausrichtung der gesamten IT-Strategie. Im Gegenteil: Ein schrittweiser Ansatz minimiert das Risiko und maximiert den frühen Erfolg. Beginnen Sie mit den kritischsten Systemen und erweitern Sie den Umfang anschließend kontrolliert.
Phase 1: Das Datenfundament schaffen
Die Basis jeder KI-Analyse ist die Qualität und Vollständigkeit der Daten. Stellen Sie sicher, dass Logs, Metriken und Traces aus allen relevanten Quellen – sei es On-Premise, Azure oder AWS – zentral gesammelt werden. Ohne eine vollständige und strukturierte Datenbasis ist eine sinnvolle KI-Analyse unmöglich. Prüfen Sie, ob Ihre bestehenden Logging-Systeme diese Granularität bieten oder ob eine Konsolidierung nötig ist.
Phase 2: Die Baseline definieren
Die KI benötigt Zeit, um zu lernen. In der Regel sind 2–4 Wochen notwendig, um das “normale” Verhalten der Systeme zu etablieren. In dieser Phase werden keine Alarme ausgelöst. Das System sammelt nur Daten und baut sein Verständnis der saisonalen Muster, der Lastspitzen und der normalen Latenzzeiten auf. Diese Phase ist entscheidend, um spätere False Positives zu minimieren.
Phase 3: Pilotbetrieb und Kalibrierung
Lassen Sie AIOps parallel zum bestehenden Monitoring laufen. Die Alerts der KI werden nun mit den manuellen Einschätzungen der Experten abgeglichen. Hier findet die Feinabstimmung statt. Sind die Korrelationen logisch? Sind die Priorisierungen korrekt? Diese Phase dient dazu, die Genauigkeit zu kalibrieren und das Vertrauen der IT-Teams in das System aufzubauen.
Phase 4: Automatisierung und Feedback-Schleife
Nach der Validierung werden automatische Workflows gestartet. Dies kann die automatische Erstellung von Tickets in Jira oder ServiceNow umfassen, aber auch die Auslösung von Heilungs-Skripts. Wichtig ist die Feedback-Schleife: Die Teams geben Feedback an die KI, um die Modelle kontinuierlich zu verbessern. Jeder bearbeitete Incident wird zum Trainingsdatenpunkt.
Messbare Vorteile: Zahlen, die überzeugen
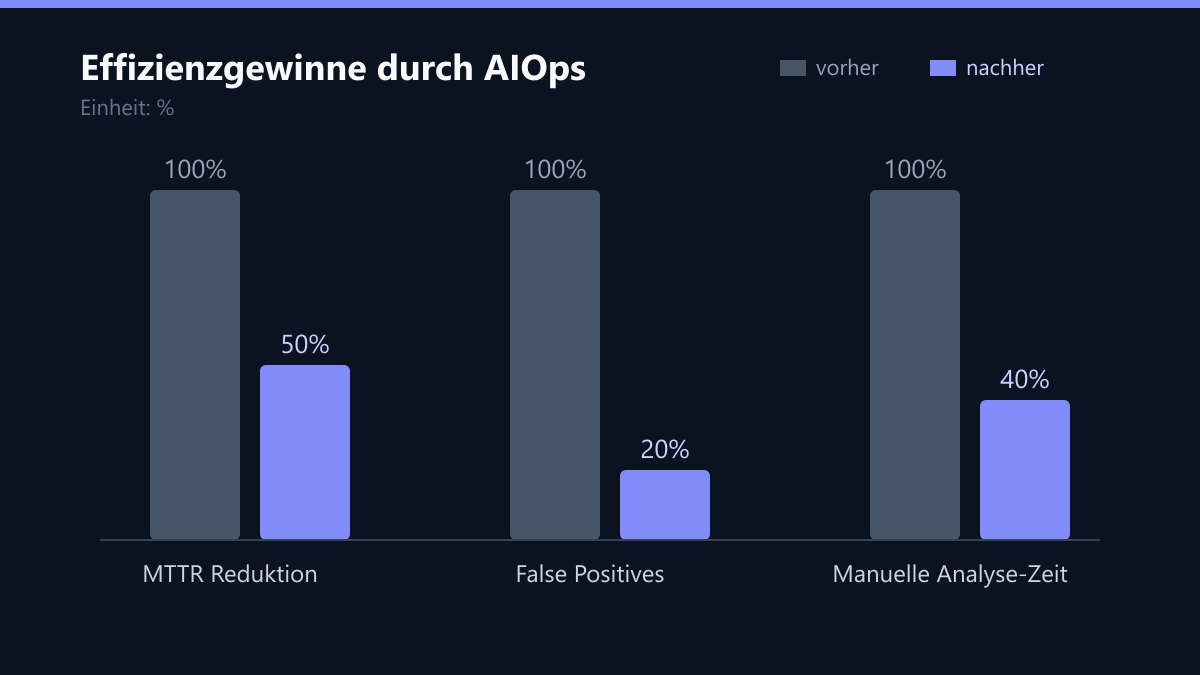
AIOps ist kein rein technisches Spielzeug, sondern ein strategischer Hebel für Effizienz und Risikominimierung. Die Wirkung lässt sich direkt in KPIs messen, die für Geschäftsführung und IT-Verantwortliche relevant sind.
Kostensenkung und Effizienzsteigerung:
- Reduktion der MTTR: Durch die gezielte Root-Cause-Analyse sinkt die durchschnittliche Wiederherstellungszeit oft um 30–50 %. Techniker müssen nicht mehr stundenlang in Logs wühlen, sondern bekommen direkt den Fingerzeig auf das Problem.
- Weniger False Positives: Die Alert-Lautstärke wird um bis zu 80 % reduziert. Das entlastet die NOC-Teams erheblich und senkt das Risiko, dass ein echter Alarm übersehen wird.
- Proaktive Wartung: Vorhersagen von Hardware- oder Softwareausfällen ermöglichen gezielte Wartung außerhalb der Stoßzeiten, was ungeplante Ausfälle verhindert.
Risikomanagement und Compliance:
- Schnellere Compliance-Reports: Zentrale Log-Aufbewahrung und Analyse erleichtern die Nachweise für DSGVO oder ISO 27001 erheblich.
- Erhöhte Resilienz: Das System erkennt Schwachstellen, die bei manuellen Checks übersehen werden könnten, und stärkt die Gesamtstabilität der IT.
Typische Fehler bei der Einführung vermeiden
Viele Projekte scheitern nicht an der Technologie selbst, sondern an der Strategie der Einführung. Drei Fehler sollten Sie aktiv vermeiden, um den vollen Nutzen zu erzielen.
1. Der „Big Bang“-Ansatz
Versuchen Sie nicht, sofort alle Systeme im Unternehmen zu überwachen. Das führt zu Datenchaos und überforderten Teams. Starten Sie mit einer kleinen, aber kritischen Umgebung, wie der E-Commerce-Plattform oder dem ERP-System. Ein messbarer Erfolg in dieser Nische schafft das Vertrauen und die politische Unterstützung für die weitere Ausrollung auf die gesamte Infrastruktur.
2. Fehlende Datenqualität
KI ist nur so gut wie ihre Eingabedaten. Unstrukturierte Logs, fehlende Metriken oder inkonsistente Zeitstempel führen zu ungenauen Ergebnissen und Fehlmeldungen. Investieren Sie zuerst in eine saubere Datenerfassung und -strukturierung. Wenn die Basis schmutzig ist, wird auch die KI “schmutzige” Insights liefern.
3. Vernachlässigung des Change Managements
IT-Teams müssen die neuen Alerts verstehen und ihnen vertrauen. Wenn die KI als “schwarzer Kasten” wahrgenommen wird, der falsche Alarme macht, wird sie ignoriert. Schulungen und klare Prozesse sind essenziell, damit die KI als Unterstützung und nicht als Bedrohung der eigenen Expertise wahrgenommen wird. Kommunizieren Sie transparent, wie die KI zu ihren Schlüssen kommt.
So messen Sie den Erfolg: KPIs und Methode
Um den ROI von AIOps zu belegen, sollten Sie vor der Einführung klare Baseline-Werte festhalten und diese nach 3 Monaten erneut messen. Fokussieren Sie sich auf drei zentrale Kennzahlen:
- MTTR (Mean Time to Repair): Messen Sie die durchschnittliche Zeit von der Erkennung des Incidents bis zur Wiederherstellung des Dienstes. Ziel: Reduktion um mindestens 30 %.
- Alert-Volume: Zählen Sie die Anzahl der pro Tag generierten Alerts, die manuell bearbeitet werden müssen. Ziel: Reduktion um 50–80 % durch Beseitigung von False Positives.
- Incident-Korrelationsrate: Wie oft wurde ein komplexes Incident korrekt von der KI als ein zusammenhängendes Problem erkannt, statt als mehrere isolierte Fehler? Eine hohe Korrelationsrate zeigt, dass das System die kausalen Zusammenhänge versteht.
Dokumentieren Sie diese Werte in einem monatlichen Report für das Management. So wird AIOps von einem technischen Projekt zu einem nachweisbaren Business-Enabler.
Checkliste für den Start
- Datenquellen auditieren: Sind Logs, Metriken und Traces zentral verfügbar?
- Pilot-Umgebung definieren: Welches kritische System wird zuerst überwacht?
- Baseline-Phase planen: Reservieren Sie 2–4 Wochen für das Lernen der KI.
- Workflows definieren: Welche automatischen Aktionen sollen bei Alerts ausgelöst werden?
- Teams schulen: Klären Sie Rollen und Verantwortlichkeiten im neuen Prozess.
Passend dazu
- IT-Beratung & IT-Strategie
- KI-Beratung & KI-Strategie
- Künstliche Intelligenz im Kundenservice: 60 % schnellere Antwortzeiten im britischen Einzelhandel
- Automatisierung der Kreditprüfung im Mittelstand: 40 Prozent weniger Bearbeitungszeit durch LLM-Workflows
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- E-Commerce Entwicklung
- AIOps im Mittelstand: Automatisierte Root-Cause-Analyse ohne Data-Science-Team
- API-Integration für den Mittelstand: ERP, CRM und E-Commerce verbinden
- Azure und AWS im Vergleich: Kosten, Sicherheit und Migration
- Custom Software vs. Off-the-Shelf: Wirtschaftlichkeit im Mittelstand
- Automatisiertes Kunden-Onboarding für B2B SaaS im Mittelstand
- KI im Mittelstand: 5 konkrete Use-Cases für Prozessoptimierung
- Fünf KPIs für die Security-Kultur im Mittelstand
- MSP vs. In-House IT: Entscheidungsfähigkeit im Mittelstand