Ausgangslage: Manuelle Engpässe in der Kreditprüfung
Der Kunde, ein spezialisierter B2B-Softwareanbieter mit 85 Mitarbeitern in der DACH-Region, stand vor einem klassischen Skalierungsproblem. Mit wachsendem Kundenstimm wuchs auch das Volumen der Kreditanfragen, die monatlich über 500 Stück erreichten. Bislang wurde jeder dieser Vorgänge vollständig manuell abgewickelt. Finanzexperten verbrachten im Schnitt bis zu 45 Minuten pro Anfrage damit, unstrukturierte Dokumente wie Bilanzen, Gewinn- und Verlustrechnungen sowie Korrespondenz per E-Mail zu sichten, Daten abzutippen und gegen interne Richtlinien zu prüfen.
Diese manuelle Belastung führte zu drei zentralen Problemen. Erstens war der personelle Aufwand extrem hoch, da wiederkehrende, einfache Datenabgleiche aus PDFs und E-Mails den Tagesablauf der Experten dominierten. Zweitens litt die Qualität der Bewertungen unter Inkonsistenzen, da unterschiedliche Prüfer unterschiedliche Gewichtungskriterien anlegten oder Details übersehen konnten. Drittens war die Reaktionszeit auf Kundenanfragen viel zu langsam. Im Durchschnitt warteten Interessenten drei Tage auf eine Rückmeldung, was im kompetitiven B2B-Umfeld zu Abwanderung an schneller agierende Wettbewerber führte.
Herausforderungen bei der Automatisierung
Die Entscheidung für eine KI-gestützte Lösung war nicht ohne Grund, da die Kreditprüfung ein sensibles Feld ist. Wir identifizierten vier konkrete Herausforderungen, die es zu lösen galt.
- Heterogene Dokumentenformate: Die eingehenden Unterlagen waren in keiner einheitlichen Struktur. Bilanzen kamen als gescannte PDFs, als Excel-Dateien oder als strukturierte PDFs in unterschiedlichen Layouts an. Eine einfache OCR-Lösung reichte hier nicht aus, da das Verständnis von Kontext und Zusammenhängen fehlte.
- Regelkomplexität: Die internen Kreditrichtlinien waren komplex und enthielten viele „Wenn-dann“-Abhängigkeiten, die schwer in starre If-Else-Logik zu übersetzen waren. Die KI musste diese nuancierten Regeln interpretieren können.
- Vertrauen der Experten: Das Finance-Team war skeptisch gegenüber einer Black-Box-Lösung. Sie befürchteten, dass die KI Fehler machen würde, die sie nicht nachvollziehen konnten, und weigerten sich zunächst, die Verantwortung zu delegieren.
- Integration in bestehende Prozesse: Die Lösung durfte keine Insellösung sein. Sie musste nahtlos in das bestehende ERP-System greifen, um Daten zu lesen und Entscheidungen zurückzuschreiben, ohne den Workflow der Mitarbeiter zu stören.
Der Tech-Stack
Um diese Herausforderungen zu meistern, haben wir einen schlanken, modularen Tech-Stack entwickelt:
- Large Language Model (LLM): Als Kern der Intelligenz nutzen wir ein Fine-Tuned LLM, das speziell für die Interpretation von Finanzdokumenten und die Anwendung von Kreditrichtlinien trainiert wurde. Es extrahiert strukturierte Daten aus unstrukturierten Texten.
- Document Parsing Engine: Eine spezialisierte Vorverarbeitungsschicht, die PDFs und E-Mails bereinigt, Seiten zusammenführt und relevante Abschnitte für das LLM vorbereitet.
- Workflow Orchestration: Ein Orchestrierungs-Framework, das die Abläufe steuert: vom Empfang der Anfrage über die KI-Analyse bis zur Eskalation oder Automatisierung.
- ERP-Integration Layer: Eine REST-API-Schnittstelle, die sicher mit dem bestehenden ERP-System des Kunden kommuniziert, um Stammdaten abzurufen und Prüfergebnisse zu speichern.
- Monitoring & Logging: Ein Dashboard, das jede KI-Entscheidung mit dem zugrunde liegenden Prompt und den extrahierten Daten protokolliert, um Transparenz und Nachvollziehbarkeit zu gewährleisten.
Umsetzung: Von der Analyse zum Pilot
Die Implementierung folgte einem agilen Ansatz mit klaren Meilensteinen. In der ersten Phase führten wir eine detaillierte Prozessanalyse durch. Wir sammelten 200 historische Kreditanfragen und klassifizierte diese manuell, um die Häufigkeit von Dokumententypen und die Komplexität der Entscheidungen zu verstehen. Dies diente als Basis für das Training und die Validierung des Modells.
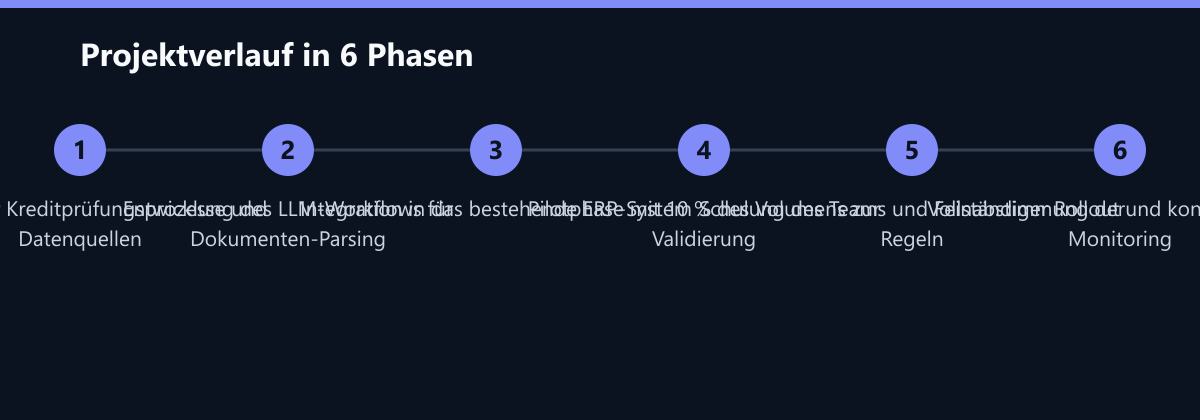
Anschließend entwickelten wir den LLM-Workflow. Der Fokus lag auf der strukturierten Auswertung unstrukturierter Dokumente. Das System lernte, Umsatz, Schuldenstand und Bonitätskennzahlen aus Bilanzen zu extrahieren und diese mit den im ERP hinterlegten Kundenstammdaten abzugleichen. Parallel dazu implementierten wir die regelbasierte Logik: Das LLM prüft die extrahierten Daten gegen die internen Kreditrichtlinien. Hier war entscheidend, dass die KI nicht nur ja oder nein sagt, sondern eine Begründung liefert. Für jeden Prüfpunkt wird ein Konfidenzwert berechnet.
Das Herzstück der Lösung ist der Human-in-the-Loop-Ansatz. Wir definierten klare Schwellenwerte: Liegt der Konfidenzwert der KI über 95 % und sind alle Pflichtfelder vollständig, wird der Vorgang automatisch abgeschlossen. Liegt er darunter oder fehlen Daten, wird der Fall an einen menschlichen Experten eskaliert, der die Vorschläge der KI sieht und final entscheidet. Diese Transparenz war der Schlüssel zur Akzeptanz im Team.
Die technische Integration in das ERP-System erfolgte über eine Middleware, die sicherstellt, dass keine Daten verloren gehen und dass der Status der Kreditanfrage in Echtzeit im ERP aktualisiert wird. Nach der Entwicklung begannen wir mit einer Pilotphase. Wir nahmen 10 % des monatlichen Volumens in den neuen Workflow. Diese Phase dauerte drei Wochen. In dieser Zeit begleiteten wir das Team täglich, um Feedback einzuholen und die Prompts sowie die Schwellenwerte zu optimieren. Die letzten drei Wochen der 10-wöchigen Gesamtlaufzeit dienten der Schulung der Experten und dem schrittweisen Rollout auf 100 % des Volumens.
Wie wir die Zahlen messen
Um den Erfolg objektiv zu belegen, haben wir vor der Implementierung einen Baseline-Wert ermittelt. Wir haben für zwei Wochen manuell protokolliert, wie lange die Experten für die einzelnen Schritte (Sichtung, Datenerfassung, Bewertung, Freigabe) benötigt haben. Diese Daten dienten als Vergleichswert.
Nach dem Rollout messen wir die Kennzahlen über das ERP-System und die Workflow-Orchestrierung. Die Bearbeitungszeit wird durch Zeitstempel am Start und Ende des Vorgangs ermittelt. Der Automatisierungsgrad wird berechnet, indem wir die Anzahl der automatisch abgeschlossenen Vorgänge durch die Gesamtzahl der eingehenden Anfragen teilen. Die Personalkosten-Ersparnis wird basierend auf der gesparten Arbeitszeit und dem internen Stundensatz der Finanzexperten berechnet. Zusätzlich führen wir monatlich eine Qualitätsprüfung durch, bei der wir 5 % der automatisch abgeschlossenen Fälle stichprobenartig durch einen Senior-Experten überprüfen, um die Fehlerquote zu validieren.
Ergebnis: Effizienz und Geschwindigkeit im Gleichgewicht
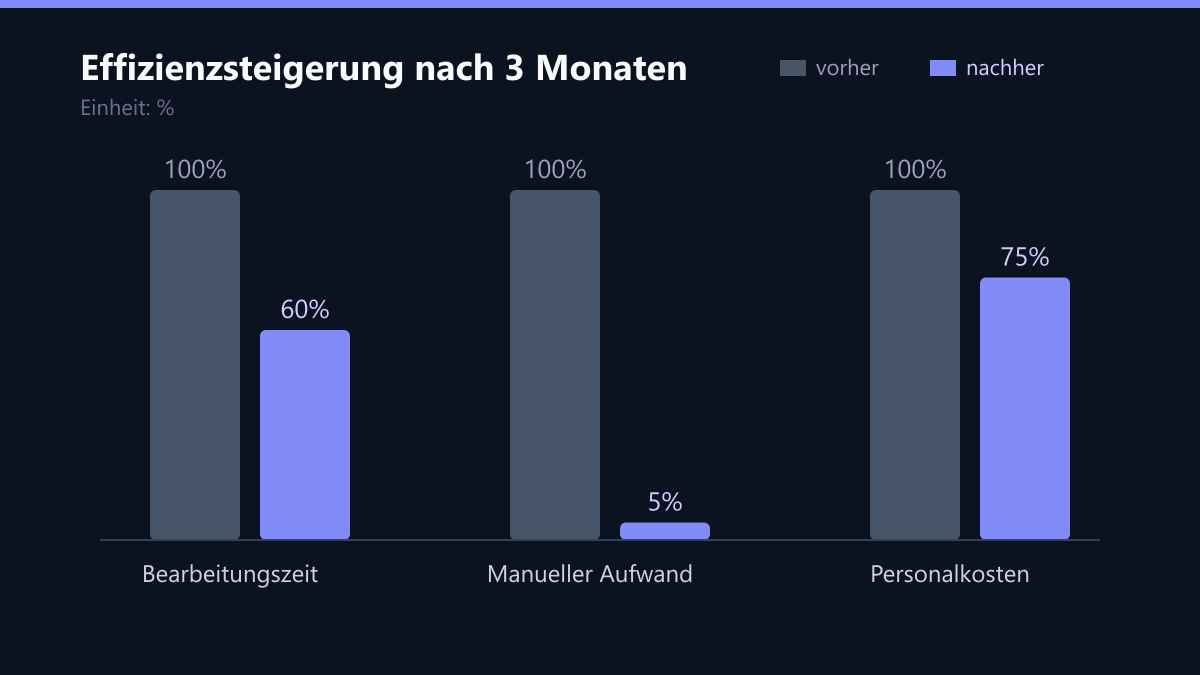
Nach drei Monaten im vollen Betrieb zeigte sich ein deutlicher Wandel im Finanzprozess. Die manuelle Last wurde drastisch reduziert, und das Team konnte sich auf die wirklich komplexen Fälle konzentrieren. Die wichtigsten KPIs nach drei Monaten:
- 40 % weniger Bearbeitungszeit: Die durchschnittliche Zeit pro Vorgang sank von 45 auf 27 Minuten. Die Experten nutzten die gewonnene Zeit für die kritischen 5 % der Fälle und für strategische Aufgaben.
- 2x schnellere Kundenantwort: Die durchschnittliche Reaktionszeit auf Kreditanfragen sank von drei Tagen auf 36 Stunden. Dies verbesserte die Kundenzufriedenheit messbar und reduzierte Absagen durch zu lange Wartezeiten.
- 95 % Automatisierungsgrad: 95 % der eingehenden Anfragen wurden ohne manuelles Eingreifen abgeschlossen. Nur noch 5 % der Fälle erforderten eine menschliche Intervention, was die Kapazität des Teams erheblich entlastete.
- Kostensenkung: Durch die Reduktion der manuellen Arbeitszeit sanken die Personalkosten für die Kreditprüfung um 25 %. Diese Ersparnis deckt die laufenden Kosten für die KI-Infrastruktur und das Monitoring mehr als ab.
Learnings und Was wir heute anders machen würden
Der Erfolg dieses Projekts basierte auf einer klaren Trennung zwischen automatisierbaren Routineaufgaben und kritischen Entscheidungsprozessen. Vertrauen in die KI-Entscheidung entsteht nicht durch blindes Vertrauen, sondern durch transparente Nachvollziehbarkeit. Die Experten mussten sehen können, warum die KI eine bestimmte Entscheidung getroffen hat. Ohne diese „Glass-Box“-Transparenz wäre die Akzeptanz im Team nie erreicht worden.
Ein wesentlicher Learning war die Bedeutung der Datenqualität. Saubere, vollständige Eingabedaten verbessern die Genauigkeit des LLMs massiv. In der Pilotphase haben wir festgestellt, dass fehlende Daten in den PDFs zu vielen Eskalationen führten. Wir haben daher eine Vorab-Prüfung eingefügt, die unvollständige Anfragen sofort zurückweist, bevor die KI gestartet wird.
Auch das schrittweise Vorgehen war entscheidend. Der Pilot mit nur 10 % des Volumens reduzierte das Risiko erheblich. Er baute Akzeptanz auf und erlaubte es, Fehler in einem kontrollierten Umfeld zu finden und zu beheben, bevor der volle Betrieb begann.
Was wir heute anders machen würden? Erstens würden wir die Schulung der Experten früher einplanen. In diesem Projekt wurden die Schulungen erst in den letzten drei Wochen durchgeführt. Heute würden wir das Team von Tag 1 an einbinden, um Feedback in die Prompt-Entwicklung einzuspeisen und Widerstände früher zu adressieren.
Zweitens würden wir stärker in die Standardisierung der Eingabedaten investieren. Statt nur die KI an die unstrukturierten Daten anzupassen, hätten wir die Kunden stärker dazu motivieren sollen, Daten in einem standardisierten Format zu liefern. Dies hätte die Fehlerquote der KI weiter gesenkt und den Automatisierungsgrad wahrscheinlich über 95 % gesteigert.
Drittens würden wir das Monitoring-System von Anfang an als Produkt betrachten. In diesem Projekt war das Dashboard primär für die Entwickler gedacht. Heute würden wir es von Beginn an für die Fachabteilung designen, um Self-Service-Analysen und eigenständige Optimierung der Schwellenwerte zu ermöglichen.
Passend dazu
- IT-Beratung & IT-Strategie
- IT-Automatisierung & Prozessautomatisierung
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- Automatisierte NIS2-Readiness-Prüfung senkt Audit-Zeit für mittelständische Logistikfirma in München um 40 Prozent
- B2B-Portal-Entwicklung für UK-Industriekunden: 30 Prozent geringerer Support-Aufwand durch Self-Service-Checkout
- Conversion-Rate um 18 Prozent steigern durch KI-Produktempfehlungen im B2B-Industriehandel
- Produktivitätssteigerung um 15 Prozent im US-Pharmasektor durch optimierten IT-Support
- Produktionsmonitoring für Maschinenbauer: 40 % weniger Stillstand
- Backup-Automatisierung: Wie Sie manuelle Prozesse durch KI-gestützte Orchestrierung ersetzen
- DSGVO-Audit im Mittelstand: Risikominimierung durch automatisierte Datenklassifizierung
- ROI-Berechnung für KI-Projekte: So messen Sie den wirtschaftlichen Erfolg Ihrer Automatisierung
- Netzwerk-Segmentierung im Mittelstand: Lateral Movement stoppen
- SIEM vs. Observability: Abgrenzung der Tools für IT-Sicherheit und Betrieb im Mittelstand
- Cybersecurity im Mittelstand: Von reaktivem Monitoring zu proaktivem Threat-Hunting
- DSGVO vs. NIS2: Pflichten für den Mittelstand
- Custom ERP-Integration in der Fertigung: Durchlaufzeiten um 15 Prozent verkürzen
- IT-Portfoliomanagement: Kostenoptimierung durch SaaS-Konsolidierung
- KI-gestützte Rechnungsprüfung im Mittelstand
- Helpdesk-KPIs im Mittelstand: Reaktionszeit und Zufriedenheit messbar verbessern
- Prozessautomatisierung in der Finanzabteilung: Effizienzsteigerung durch KI und Automatisierung
- IT-Automatisierung im Support: So RPA die First-Response-Zeit senkt
- Vendor Lock-in vermeiden: Strategien für portierbare IT-Lösungen im Mittelstand
- IPv6-Readiness Check: Netzwerk-Infrastruktur auf den IPv4-Aus vorbereiten
- First-Level-Support intern oder extern: Wirtschaftlichkeitsrechnung für den Mittelstand
- Finanzdienstleister in Frankfurt: SIEM-Automatisierung reduziert False Positives um 65 Prozent
- API-Integration für den Mittelstand: ERP, CRM und E-Commerce verbinden
- Logistik-Unternehmen senkt Ausfallzeiten durch predictive Monitoring um 40 Prozent
- Kostensenkung um 28 Prozent durch Azure Migration
- Ladezeit um 60 Prozent gesenkt durch Magento-Optimierung
- KI im Helpdesk: So automatisieren Sie Routineanfragen und reduzieren die Ticket-Last um 40 Prozent
- Verringerung der Ticket-Last im Helpdesk um 40 Prozent bei einem Maschinenbauer in Deutschland durch Root-Cause-Analyse statt reaktiver Störungsbeseitigung
- Grafana vs. New Relic: Observability-Entscheidung im Mittelstand
- IT-Outsourcing vs. In-House: Wirtschaftlichkeitsrechner für den Mittelstand
- Workflow-Automatisierung in der Buchhaltung: 5 Prozesse, die sich sofort automatisieren lassen
- Shopify-B2B-Implementierung für einen Industrievertrieb in Singapur: 40 Prozent schnellere Katalogsynchronisation via API
- 3DS-Prüfung für Backups: Warum regelmäßige Wiederherstellungstests Pflicht sind
- DSGVO und IT-Sicherheit: 7 technische Maßnahmen für die Prüfung
- React-Native-App für die Baubranche: 25 % weniger Planungsfehler durch Echtzeit-Sync
- KI-Beratung im Mittelstand: Von der Idee zur messbaren ROI in 90 Tagen
- Produktionsunternehmen in Singapur: 30 % weniger Ausfallzeit durch proaktive Hardware-Checks
- Von Logs zu Insights: AIOps für schnellere Incident-Aufklärung im Mittelstand
- Custom Booking Engine für Fitness-Studios: 25 Prozent Umsatzsteigerung
- Automatisiertes Kunden-Onboarding für B2B SaaS im Mittelstand
- Automatisierung von IT-Compliance-Audits: Manuellen Aufwand um 60 Prozent senken
- KI im Mittelstand: 5 konkrete Use-Cases für Prozessoptimierung
- Private KI-Wissensdatenbank: Unternehmensdaten durch On-Premise-LLM sichern
- ROI von KI-Automatisierung: So berechnen Sie die Amortisationszeit
- RPA für Order Fulfillment: 60 % weniger Fehler im DACH-Handel
- 18 Prozent Energieeinsparung im R&D-Zentrum durch Smart Power Management
- ROI Calculator für IT-Automatisierung: Den Business Case in 3 Schritten belegen
- Versicherungsbroker in Österreich digitalisiert Schadensmeldungen mit OCR und reduziert Bearbeitungszeit von 3 auf 0,5 Stunden
- RPA vs. KI-Automatisierung: Wirtschaftliche Entscheidungshilfe
- 5 Engpässe bei manueller Datenerfassung und sichere Automatisierung
- 85 Prozent weniger Passwortwiederverwendung nach Policy-Training
- Pharma-Inventory-Optimierung: 30 % weniger Abfall durch KI-gestütztes Demand Planning
- MSP vs. In-House IT: Entscheidungsfähigkeit im Mittelstand
- Maschinenbau in Stuttgart: 40 % weniger Downtime durch prädiktive IT-Strategie