Ausgangslage: Skalierung stößt an Grenzen
Der Kunde, ein schnell wachsender Fintech-Anbieter in London mit 85 Mitarbeitenden, stand vor einer klassischen, aber kritischen Skalierungsproblematik. Während die Kundenzahlen stiegen, blieb der Onboarding-Prozess manuell und fragmentiert. Neue B2B-Kunden durchliefen eine lange Hürde: Im Schnitt dauerte die Einrichtung bis zur ersten Transaktion 14 Werktage. Für ein Unternehmen, das von Geschwindigkeit und Liquidität lebt, war diese Latenz nicht nur ein Ärgernis, sondern ein strategisches Risiko.
Die Kernschmerzen lagen tief im System. Die Datenhaltung war auf drei verschiedene Legacy-Systeme verteilt, die untereinander kaum kommunizierten. Jede neue Bankverbindung oder KYC-Prüfung (Know Your Customer) erforderte manuelle Eingriffe und Abgleiche durch hochqualifizierte Mitarbeiter. Diese Fachkräfte wurden in repetitive, fehleranfällige Datenabgleich-Aufgaben gebunden, die sie eigentlich für strategische Aufgaben freizuschauffen galt. Die Folge war eine hohe Churn-Rate bei neuen Kunden: Wer länger als zwei Wochen auf die erste Transaktion wartete, wechselte oft zum Wettbewerber, der schneller lieferte. Die IT-Abteilung war am Anschlag und konnte kaum Kapazitäten für Innovationen freigeben.
Herausforderungen: Mehr als nur Technik
Die Umsetzung einer KI-gestützten Lösung war kein rein technisches Projekt, sondern eine organisatorische und datentechnische Herausforderung. Wir identifizierte vier zentrale Hürden, die es zu überwinden galt:
- Fragmentierte Datenquellen: Die Kundendaten lagen verstreut in drei Legacy-Systemen ohne einheitliches Datenmodell. Ohne eine zentrale Quelle der Wahrheit war jede Automatisierung zum Scheitern verurteilt.
- Regulatorische Komplexität: Als Fintech unterliegt der Kunde strengen Compliance-Vorschriften. KI-Entscheidungen dürfen nicht „in der Blackbox“ fallen; sie müssen nachvollziehbar und auditierbar sein. Jede Ausnahme musste einen klaren, dokumentierten Freigabepfad haben.
- Akzeptanz im Team: Das Onboarding-Team hatte Angst vor Jobverlusten durch Automatisierung. Es galt, die Mitarbeiter als „Overseer“ der KI-Systeme zu positionieren, nicht als ersetzbar.
- Legacy-Integration: Die bestehenden Systemen waren nicht API-freundlich. Eine nahtlose Anbindung ohne Störung des laufenden Betriebs war technisch anspruchsvoll.
Der Tech-Stack
Um diese Herausforderungen zu meistern, haben wir auf einen bewährten, skalierbaren Stack gesetzt, der sich nahtlos in die bestehende Microsoft-Ökosystem-Infrastruktur einfügt:
- Microsoft Azure Data Lake: Zentrale, sichere Lagerstätte für alle aggregierten Kundendaten in Echtzeit. Er dient als Single Source of Truth.
- Azure OpenAI Service: Bereitstellung des LLM-Modells für die Dokumentenprüfung und Plausibilitätsprüfung, gehostet in der sicheren Azure-Cloud.
- Power Automate: Das Orchestrierungswerkzeug, das die Workflows zwischen Datenlaken, KI-Modellen und Legacy-Systemen steuert und automatisiert.
- Microsoft 365 Copilot: Integration in die tägliche Arbeitsumgebung der Mitarbeiter, um Ausnahmen und Freigaben direkt im gewohnten Interface zu bearbeiten.
Umsetzung: 12 Wochen zum automatisierten Onboarding
Wir entwickelten eine KI-gestützte Onboarding-Pipeline, die den manuellen Aufwand drastisch reduzierte. Das Projekt lief über 12 Wochen in drei klar definierten Phasen: Analyse, Prototyping und Rollout. Der Fokus lag nicht nur auf der Technologie, sondern auf der Prozessarchitektur, die die Technologie trägt.
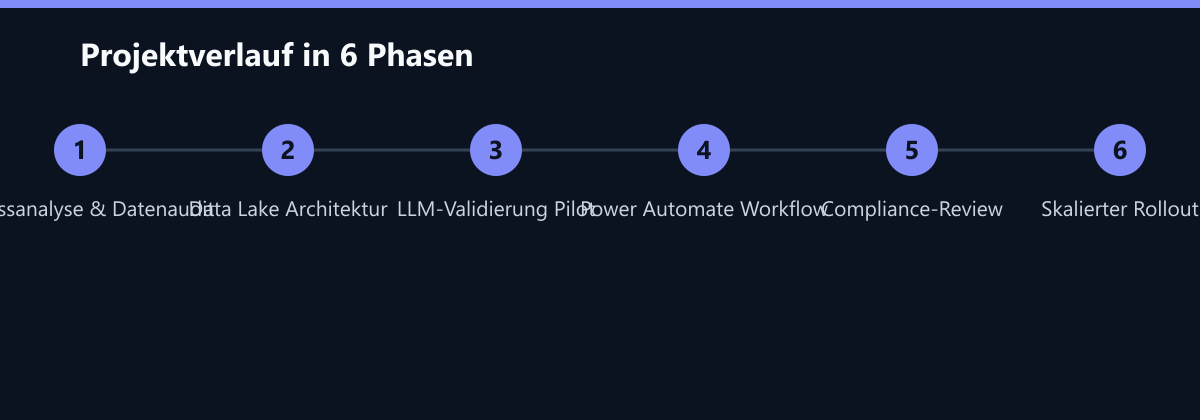
Phase 1: Datenkonsolidierung und Bereinigung (Wochen 1–4) Bevor auch nur eine Zeile Code für die KI geschrieben wurde, haben wir uns den Daten angenommen. Wir erstellten ein zentrales Data Lake auf Basis von Azure, das alle Kundendaten aus den drei Legacy-Systemen in Echtzeit aggregiert. Dabei haben wir historische Daten bereinigt, Formate standardisiert und ein einheitliches Datenmodell definiert. Ohne diesen Schritt wäre die KI mit „Müll“ gefüttert worden – das Ergebnis wäre unbrauchbar gewesen. Wir definierten auch die Datenqualität-Metriken, die als Basis für das spätere Monitoring dienten.
Phase 2: KI-Validierung und Prototyping (Wochen 5–8) Im zweiten Schritt implementierten wir die intelligente Schicht. Ein LLM-Modell, gehostet im Azure OpenAI Service, prüft automatisch die Plausibilität der hochgeladenen Dokumente (z. B. Handelsregisterauszüge, ID-Dokumente). Das Modell gleicht diese Informationen mit den Registereinträgen im Data Lake ab. Wichtig war hier die Konfiguration der „Human-in-the-Loop“-Logik: Bei einer Konfidenz unter 95 % oder bei Abweichungen wird der Fall automatisch an ein menschliches Teammitglied eskaliert. So bleibt die Compliance-Vorgabe gewahrt.
Phase 3: Automatisierte Workflows und Rollout (Wochen 9–12) Nach erfolgreicher Validierung übernimmt Power Automate die restlichen Schritte. Die Systeme des Kunden werden automatisch konfiguriert, API-Schlüssel generiert und die Bankverbindung verknüpft. Die Integration erfolgte nahtlos in die bestehende Microsoft 365-Umgebung. Das Onboarding-Team erhielt neue Dashboards, auf denen sie nur noch die Ausfälle und kritischen Fälle sehen. Keine neuen Client-Tools mussten installiert werden; die Arbeit passierte dort, wo die Mitarbeiter bereits arbeiteten.
Wie wir die Zahlen messen
Um die Erfolge objektiv zu belegen, haben wir ein Monitoring-Setup installiert, das drei Kern-KPIs kontinuierlich trackt:
- Durchlaufzeit (Lead Time): Gemessen vom Moment der Kundenanmeldung bis zur erfolgreichen ersten API-Aufruf. Diese Metrik wird direkt aus den Log-Daten der Power-Automate-Workflows extrahiert.
- Manueller Aufwand (Touch Time): Wir haben die Zeit gemessen, die Mitarbeiter pro Onboarding-Fall im Durchschnitt in den alten Systemen verbracht haben, verglichen mit der Zeit im neuen System, die sie für manuelle Eingriffe (nur bei Eskalationen) benötigen. Die Basisdaten wurden aus den Zeiterfassungs-Systemen und den Prozess-Logs gezogen.
- Fehlerrate (Error Rate): Definiert als Anzahl der korrigierten Dateninkonsistenzen pro 100 Onboardings. Vorher wurden diese manuell in Spreadsheets erfasst; jetzt werden sie automatisch im Data Lake protokolliert, wenn ein Downstream-System eine Validierungsfehler meldet.
Ergebnis: Deutliche Effizienzgewinne
Die neuen Prozesse wurden nach einer 2-wöchigen Testphase, in der Parallelbetrieb mit dem alten Prozess stattfand, auf alle neuen Kunden skaliert. Die Ergebnisse übertrafen die internen Erwartungen deutlich. Die Zahlen sprechen für sich:
- Onboarding-Zeit: Reduktion von 14 auf 6 Werktage (-57 %).
- Manueller Aufwand: Senkung der benötigten Arbeitsstunden um 65 %.
- Fehlerrate: Verringerung der Dateninkonsistenzen um 90 %.
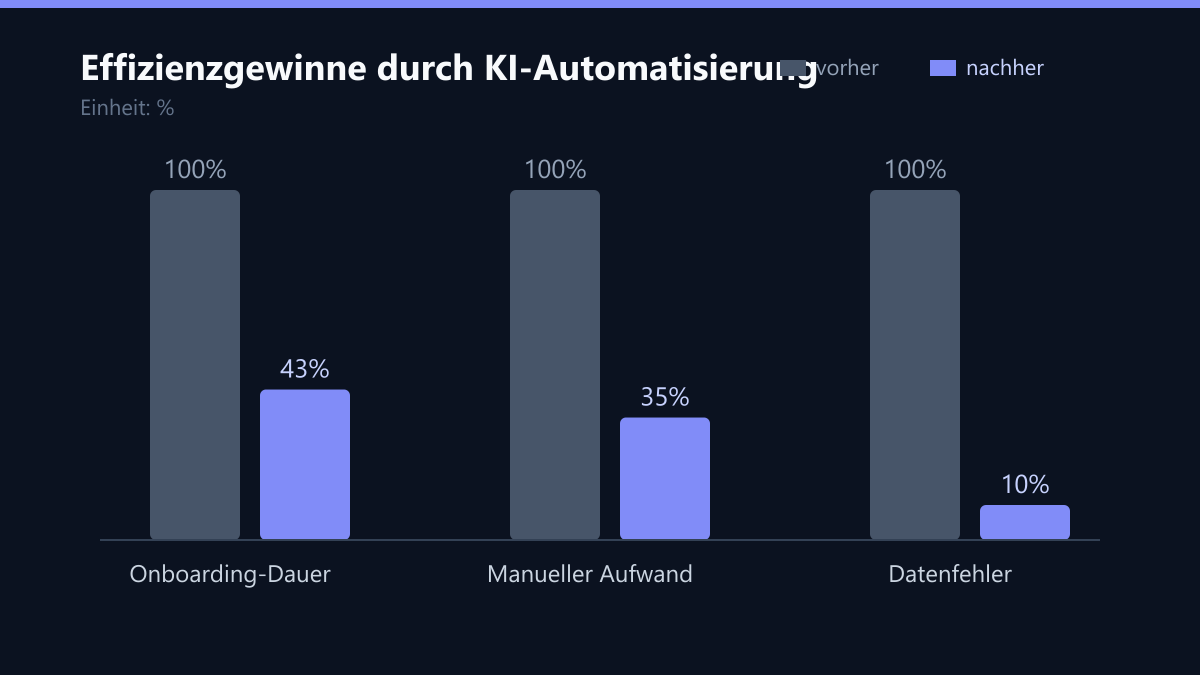
Die IT-Abteilung konnte sich wieder auf strategische Projekte konzentrieren, während das Onboarding-Team die frei gewordene Kapazität nutzte, um die wachsende Kundenbasis proaktiv zu betreuen. Die Churn-Rate bei neuen Kunden sank im ersten Quartal nach dem Rollout um ein Drittel, da die Zeit bis zur ersten Transaktion nun akzeptabel war.
Learnings: Was bleibt?
Rückblickend haben wir wertvolle Erkenntnisse gewonnen, die über dieses spezifische Projekt hinausgehen. Der größte Hebel lag nicht in der KI selbst, sondern in der vorherigen Datenbereinigung. Viele Unternehmen unterschätzen diesen Schritt. Ohne saubere, konsolidierte Eingabedaten wäre die Automatisierung gescheitert oder hätte mehr Fehler produziert als der manuelle Prozess. Datenqualität ist die Basis jeder KI-Strategie.
Zweitens ist eine enge, frühe Zusammenarbeit zwischen IT und Compliance entscheidend. Wir haben die Compliance-Abteilung von Tag 1 an in die Entwicklung der KI-Regeln eingebunden. Die KI-Entscheidungen wurden so konfiguriert, dass jede Ausnahme manuell freigegeben werden muss und dokumentiert wird. Dies gewährleistet die DSGVO-Konformität und schafft Vertrauen – sowohl bei den Regulatoren als auch bei den Kunden. Transparenz ist kein Hindernis, sondern ein Feature.
Drittens ist für Skalierbarkeit eine modulare Architektur essenziell. Wir haben die Pipeline so gebaut, dass neue Validierungsregeln oder neue Datenquellen einfach als Module hinzugefügt werden können. So kann sich die Lösung an neue regulatorische Anforderungen anpassen, ohne dass der gesamte Stack umgebaut werden muss.
Was wir heute anders machen würden
Ehrlich gesagt: Wir hätten die Pilotphase länger gestalten sollen. Ursprünglich war der Rollout nach 10 Wochen geplant, wir haben ihn auf 12 Wochen verschoben. Diese zusätzlichen zwei Wochen haben sich gelohnt, da wir so mehr Edge-Cases im Testbetrieb identifizieren und die Prompt-Strategien des LLMs feinjustieren konnten. Ein früherer Rollout hätte zu mehr Eskalationen und Frustration im Team geführt.
Zweitens hätten wir die Schulung der Mitarbeiter intensiver gestalten können. Zwar war die technische Akzeptanz hoch, aber die Fähigkeit der Mitarbeiter, die KI-Ergebnisse kritisch zu hinterfragen und Ausfälle korrekt zu klassifizieren, hätte durch gezielte Trainings früher gefördert werden können. Dies würde die Zeit bis zur vollen Effizienz (Time-to-Value) weiter verkürzen.
Drittens hätten wir von Anfang an ein stärkeres Feedback-Loop-System implementieren sollen. Die kontinuierliche Verbesserung des Modells basierte stark auf manuellen Auswertungen. Ein automatisierter Feedback-Mechanismus, bei dem Mitarbeiter mit einem Klick bestätigen oder korrigieren, hätte das Modell noch schneller lernen lassen.
Fazit
Dieses Projekt zeigt, dass KI-Automatisierung im Fintech kein Hype, sondern ein notwendiges Instrument für Skalierbarkeit ist. Der Schlüssel liegt nicht in der Magie der KI, sondern in der sauberen Architektur, der Datenqualität und der menschlichen Kontrolle. Wer diese drei Säulen beachtet, kann Prozesse wie das Onboarding drastisch beschleunigen und gleichzeitig die Compliance-Vorgaben erfüllen. Für das Fintech war es der erste Schritt in eine neue Ära der operativen Exzellenz.
Passend dazu
- IT-Beratung & IT-Strategie
- KI-Beratung & KI-Strategie
- Backup-Automatisierung: Wie Sie manuelle Prozesse durch KI-gestützte Orchestrierung ersetzen
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- IT- & Daten-Wiederherstellung (Disaster Recovery)
- KI-gestützte Rechnungsprüfung im Mittelstand
- Reduktion der Chargeback-Quote um 25 % durch KI-gestützte Fraud-Prävention
- Automatisierte NIS2-Readiness-Prüfung senkt Audit-Zeit für mittelständische Logistikfirma in München um 40 Prozent
- Berlin Fintech Reduces Audit Preparation Time by 65% Through Continuous Compliance Monitoring
- KI-gestützte Bedienertrainings für reale Cyberrisiken
- Headless Shopify-Setup für britische Modehandelskette
- Skalierung einer UK-Fintech-Plattform von 5.000 auf 50.000 Nutzer mit Managed AWS
- Kollaborations-Setup für Kanzlei in London: Compliance-orientierte SharePoint-Architektur