Ausgangslage: Der wachsende Berg an Papier und Pixeln
Der Kunde, ein dynamisches Software-Unternehmen mit 350 Mitarbeitern und Sitz in Kalifornien, stand vor einem klassischen Skalierungsproblem. Mit dem rasanten Wachstum des Geschäfts wuchs auch die Last an administrativen Aufgaben, insbesondere in der Buchhaltung. Monatlich mussten über 4.000 Belege, Rechnungen und Kontoauszüge händisch erfasst, kategorisiert und abgeglichen werden. Dieser Prozess war nicht nur zeitaufwendig, sondern auch fehleranfällig.
Das Buchhaltungsteam arbeitete unter hohem Zeitdruck. Der Monatsabschluss benötigte im Durchschnitt fünf ganze Tage, eine Dauer, die die Finanzabteilung in ihrer operativen Flexibilität stark einschränkte. Zudem war die Qualität der Daten ein kritischer Punkt: 15 % der manuellen Eingaben erforderten Korrekturen, was zu zusätzlichen Abstimmungsschleifen und Frustration im Team führte. Da das Unternehmen geplant hatte, in drei weiteren US-Bundesstaaten zu expandieren, wurde die Skalierbarkeit der bestehenden Prozesse zum strategischen Hindernis. Eine lineare Erweiterung des Personals war wirtschaftlich nicht vertretbar und hätte die Prozesse nur marginal beschleunigt.
Herausforderungen: Warum einfache Tools nicht reichten
Bevor wir mit der technischen Umsetzung begannen, identifizierten wir vier zentrale Herausforderungen, die eine einfache Einführung von Standard-OCR-Software unmöglich gemacht hätten:
- Heterogene Belegformate: Die Eingangsbelege stammten aus verschiedenen Quellen – von PDF-Rechnungen großer Zulieferer bis hin zu gescannten Papierbelegen kleiner Dienstleister. Die Layouts variierten stark, was eine statische Regelbasierte Verarbeitung unzuverlässig machte.
- Kontenmapping-Komplexität: Die Zuordnung der extrahierten Daten zu den richtigen Konten in der ERP-Landschaft war nicht trivial. Sie erforderte kontextuelles Verständnis der Geschäftslogik, das über einfache Texterkennung hinausgeht.
- Integrität der ERP-Integration: Die bestehende ERP-Infrastruktur war stabil, aber nicht für hochfrequente, automatisierte API-Aufrufe optimiert. Eine unsachgemäße Integration hätte zu Performance-Einbußen im Kernsystem führen können.
- Akzeptanz im Fachbereich: Die Buchhalter befürchteten, dass eine KI ihre Kontrolle über die Daten verliert. Es musste ein Prozess geschaffen werden, der die KI als Assistenten und nicht als Ersatz positionierte.
Der Tech-Stack
Um diese Herausforderungen zu meistern, setzten wir auf einen schlanken, aber leistungsstarken Stack:
- Microsoft Azure AI Document Intelligence: Diente als Kern der Extraktion. Das Modell wurde für die spezifischen Belegtypen des Kunden feinjustiert, um hohe Genauigkeit bei variablen Layouts zu gewährleisten.
- Python (Custom Scripts): Verarbeitete die logische Validierung. Python-Skripte prüften die Plausibilität der Daten (z. B. Summenchecks, Lieferantenreferenzen) und bereiteten die Daten für das ERP vor.
- ERP-API Middleware: Eine leichtgewichtige Middleware, die die Last der automatisierten Buchungen pufferte und sicher in die bestehende ERP-Struktur einspeiste, ohne das System zu überlasten.
- Azure DevOps & CI/CD Pipelines: Stellten sicher, dass Updates an den Validierungsregeln oder dem OCR-Modell schnell und sicher ausgerollt werden konnten.
Umsetzung: Vom Piloten zum Rollout
Die Implementierung erfolgte in einem agilen Prozess über acht Wochen. Der Fokus lag darauf, die KI direkt in die bestehende Workflow-Landschaft zu integrieren, ohne den Tagesbetrieb der Buchhaltung zu stören.
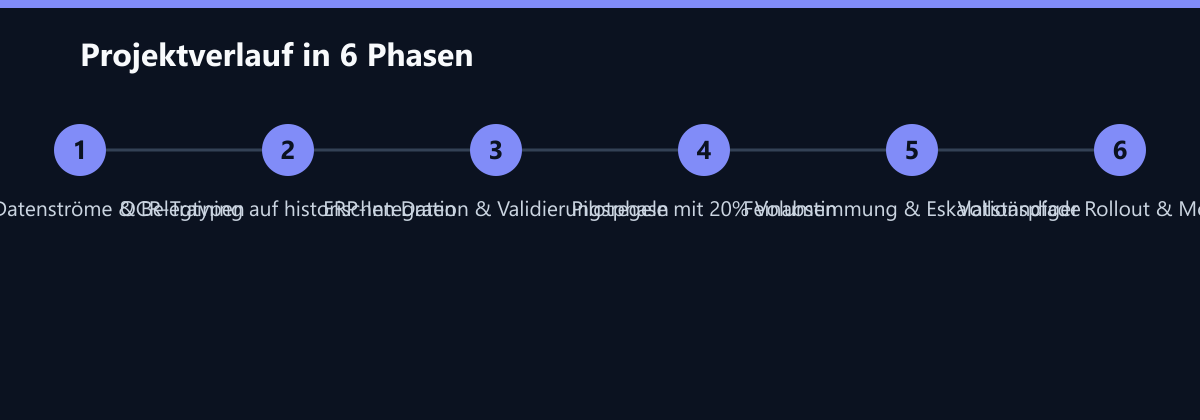
In den ersten zwei Wochen analysierten wir die Datenströme im Detail. Wir definierten die relevanten Belegtypen und ermittelten die häufigsten Fehlerquellen in der manuellen Erfassung. Parallel dazu begannen wir mit dem Training des OCR-Modells. Wir nutzten einen historischen Datenbestand von über 12 Monaten, um das Modell mit den spezifischen Mustern des Kunden vertraut zu machen. Diese Phase war entscheidend, da die Qualität der Trainingsdaten die spätere Genauigkeit direkt beeinflusste.
Von Woche 3 bis 6 konzentrierten wir uns auf die Integration. Die Python-Skripte wurden entwickelt, um die extrahierten Daten zu validieren und das Mapping auf die Kontenstruktur vorzunehmen. Die Middleware zur ERP-Anbindung wurde getestet, um sicherzustellen, dass die Datenkonsistenz gewahrt bleibt. In dieser Phase arbeiteten unsere Entwickler eng mit den IT-Spezialisten des Kunden zusammen, um sicherzustellen, dass die API-Limits des ERP-Systems nicht überschritten wurden.
Woche 7 und 8 bildeten die Pilotphase. Wir leiteten zunächst nur 20 % des Belegvolumens durch die neue Pipeline. Diese kontrollierte Umgebung erlaubte es uns, die Validierungsregeln zu feinabzustimmen und die Eskalationspfade für Ausnahmefälle zu testen. Die Buchhalter prüften die automatisch gebuchten Belege gegen die Originaldokumente und gaben direktes Feedback. Basierend auf diesen Rückmeldungen optimierten wir die Konfidenzscores, ab denen ein Beleg automatisch gebucht wurde.
Wie wir die Zahlen messen
Um die Wirksamkeit der Lösung objektiv zu belegen, haben wir einen klaren Messrahmen definiert, der vor, während und nach der Implementierung galt. Die manuelle Arbeitszeit wurde durch das Tracking der Zeitaufwände in der Buchhaltungssoftware und durch Stichproben-Interviews mit den Mitarbeitern erfasst. Wir verglichen die durchschnittliche Erfassungszeit pro Beleg im manuellen Modus mit der Zeit, die die KI für die gleiche Menge an Belegen benötigte, inklusive der Zeit für die manuelle Prüfung der Ausnahmefälle.
Die Fehlerquote wurde durch die Anzahl der Korrekturen gemessen, die nach der Buchung in der ERP-Software erforderlich waren. Wir definierten eine „Korrektur“ als jede Änderung an Kontierung, Betrag oder Datum nach der initialen Erfassung. Diese Daten wurden aus den Audit-Trails des ERP-Systems gezogen. Die Durchlaufzeit des Monatsabschlusses wurde chronologisch gemessen, von der letzten Buchung eines Monats bis zur Freigabe des Abschlussberichts durch die Finanzleitung. Diese Kennzahlen wurden monatlich aggregiert und im Rahmen von SteerCo-Meetings mit dem Kunden überprüft.
Ergebnis: Messbare Effizienz und Skalierbarkeit
Nach dem vollständigen Rollout der Lösung zeigte sich ein deutlicher Wandel in der Effizienz der Buchhaltungsprozesse. Die Automatisierung hat nicht nur Zeit gespart, sondern auch die Qualität der Daten erheblich verbessert. Die Durchlaufzeit für den Monatsabschluss sank von fünf auf nur noch zwei Tage. Dies bedeutet, dass das Team drei Tage früher in die analytische Arbeit und die Planung für den nächsten Monat einsteigen konnte.
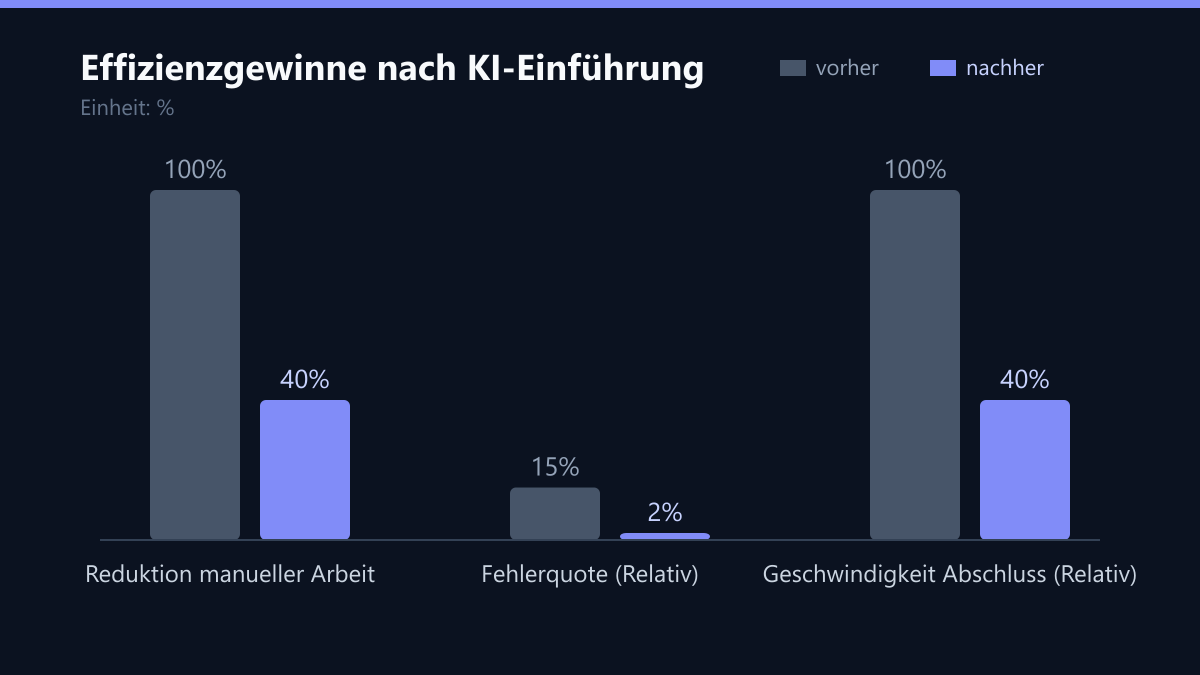
Die konkreten Kennzahlen bestätigen den Erfolg der Initiative: Die manuelle Arbeitszeit für die Belegerfassung wurde um 60 % reduziert. Die Fehlerquote, die zuvor bei 15 % lag, sank auf unter 2 %. Dies ist auf die strengen automatischen Validierungsregeln zurückzuführen, die Inkonsistenzen bereits vor der Buchung identifizieren. Zudem wurde die Skalierbarkeit gesichert: Die neuen Standorte in den drei weiteren Bundesstaaten konnten ohne zusätzliche Personalressourcen angebunden werden, da die KI-Pipeline das erhöhte Belegvolumen problemlos verarbeitet.
Die Investition in die Technologie amortisierte sich innerhalb von vier Monaten. Die Einsparungen entstanden primär durch die Reduktion der externen Zeitarbeit, die zuvor zur Abdeckung der Spitzenlasten im Monatsabschluss eingesetzt wurde, sowie durch den entfallenen internen Aufwand für Korrekturen und Abstimmungen.
Learnings: Was wir aus dem Projekt mitnehmen
Der Erfolg dieses Projekts basierte nicht nur auf der Technologie, sondern vor allem auf der Prozessgestaltung und der Zusammenarbeit. Ein zentrales Learning war die frühzeitige Einbindung der Fachbereiche. Die Buchhalter waren anfangs skeptisch, aber durch die enge Zusammenarbeit in der Analyse- und Pilotphase wurden sie zu Botschaftern der Lösung. Ihre Feedbackschleifen waren entscheidend, um die Validierungsregeln so zu kalibrieren, dass sie praxistauglich und nicht zu restriktiv waren.
Ein weiterer wichtiger Punkt war die Qualität der Trainingsdaten. Wir haben gelernt, dass ein OCR-Modell nur so gut ist wie die Daten, auf denen es trainiert wird. Die Investition in die Bereinigung und Strukturierung der historischen Daten in Woche 1 und 2 war der Schlüssel zur hohen Genauigkeit. Ohne diese Vorarbeit hätten wir mit einer deutlich höheren Fehlerquote und einem höheren manuellen Aufwand in der Pilotphase gerechnet.
Schließlich haben wir die Bedeutung von klar definierten Eskalationspfaden unterschätzt. In der Planung hatten wir angenommen, dass die KI die meisten Fälle lösen würde. Die Realität zeigte, dass es immer Ausnahmefälle gibt. Die klare Definition, was passiert, wenn die KI unsicher ist (manuelle Weiterleitung), war entscheidend für das Vertrauen der Buchhalter. Das kontinuierliche Monitoring der Modellgenauigkeit nach der Implementierung stellt sicher, dass sich die Leistung nicht verschlechtert, wenn sich die Belegformate der Lieferanten ändern.
Was wir heute anders machen würden
Rückblickend gibt es zwei Punkte, die wir in einem ähnlichen Projekt heute anders angehen würden. Erstens würden wir die Analysephase noch stärker auf die „Schattenprozesse“ fokussieren. Oft gibt es in der Buchhaltung informelle Workarounds oder manuelle Excel-Listen, die in der offiziellen Prozessdokumentation nicht auftauchen. Diese hätten wir noch früher identifizieren und in die Validierungslogik einbeziehen können, um Reibungsverluste zu minimieren.
Zweitens würden wir den Piloten etwas länger gestalten. Die acht Wochen waren ambitioniert. Eine Verlängerung der Pilotphase um eine Woche hätte es erlaubt, weitere Randfälle zu testen und die Eskalationsprozesse noch reifer zu machen, bevor der volle Rollout erfolgte. Dies hätte den Druck auf das Team in den ersten Wochen nach dem Go-Live reduziert und die Akzeptanz noch schneller gesteigert.
Passend dazu
- Web & Software Entwicklung
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- Automatisierte NIS2-Readiness-Prüfung senkt Audit-Zeit für mittelständische Logistikfirma in München um 40 Prozent
- Verringerung der Ticket-Last im Helpdesk um 40 Prozent bei einem Maschinenbauer in Deutschland durch Root-Cause-Analyse statt reaktiver Störungsbeseitigung
- Logistik-Unternehmen senkt Ausfallzeiten durch predictive Monitoring um 40 Prozent
- 99,99 Prozent Uptime: Redundante Server-Infrastruktur für einen US-Maschinenbauer
- GDPR-Audit-Kosten senken: Automatisierte Datenkartierung spart 30 Prozent
- DSGVO vs. CCPA: Praxisratgeber für Unternehmen in EU und Kalifornien
- IT-Governance und Compliance: Umsetzung der NIS2-Richtlinie für ein FinTech-Unternehmen in Frankfurt am Main in nur 6 Monaten mit 30 Prozent geringeren Auditkosten
- Headless-Migration für Schweizer Uhrenhandel zur Beschleunigung der Ladegeschwindigkeit
- Stop Shadow IT: 5 Practical Steps to Secure Employee-Driven Software Adoption
- SOC 2 Type II Vorbereitung: Praxisleitfaden für SaaS-Unternehmen