Ausgangslage: Das Risiko im Einzel-Rechenzentrum
Der Kunde, ein mittelständischer Maschinenbauer mit 450 Mitarbeitern im US-Bundesstaat Texas, spezialisiert sich auf die Fertigung hochpräziser Komponenten für die Automobilindustrie. Die IT-Landschaft war jedoch ein Flaschenhals: Das gesamte operative Kernsystem, einschließlich ERP und MES (Manufacturing Execution System), lief auf einer veralteten On-Premise-Infrastruktur in einem einzigen Rechenzentrum. Diese Single-Point-of-Failure-Architektur war nicht nur technisch veraltet, sondern auch strategisch riskant.
Das zentrale Problem war die fehlende Resilienz. Ein Stromausfall, ein Hardware-Fehler oder sogar ein lokales Naturereignis im Südwesten der USA hätte zu einem kompletten Produktionsstopp geführt. Die finanziellen Auswirkungen waren drastisch: Jede Stunde Stillstand kostete den Kunden rund 85.000 USD an entgangenen Umsätzen. Zudem fehlte eine georedundante Backup-Strategie, was das Risiko bei Katastrophen unkalkulierbar machte. Die IT-Abteilung kämpfte täglich mit manuellen Prozessen und fehlendem proaktivem Monitoring, was zu reaktiver Störungsbeseitigung und langen Reaktionszeiten führte.
Herausforderungen: Komplexität und Compliance im Fokus
Die Migration war kein einfaches Lift-and-Shift, sondern erforderte tiefgreifende architektonische Änderungen. Drei Hauptprobleme mussten gelöst werden:
- Produktionskontinuität: Die Fertigungslinien dürfen nicht stoppen. Eine klassische Big-Bang-Migration war daher ausgeschlossen. Es bedurfte einer phasierten Strategie, die den Betrieb aufrechterhält, während die Infrastruktur unter dem Teppich ausgetauscht wird.
- NIS2 & NIST Compliance: Der Kunde unterliegt strengen Sicherheitsanforderungen. Die neue Cloud-Infrastruktur musste nicht nur hochverfügbar, sondern auch nachweislich sicher sein. Dies erforderte eine vollständige Überarbeitung der Zugriffskontrollen und Netzwerksegmentierung.
- Legacy-Integration: Viele Anwendungen waren eng an das lokale Netzwerk gekoppelt. Die Loslösung von dieser Abhängigkeit ohne Funktionsverlust war die technisch größte Hürde.
Der Tech-Stack
Um die Ziele zu erreichen, haben wir einen modernen, skalierbaren Stack konzipiert:
- Microsoft Azure: Als primäre Cloud-Plattform für Compute, Storage und Networking.
- Docker & Kubernetes: Für die Containerisierung der Legacy-Anwendungen und Orchestrierung der Workloads.
- Azure Monitor & Application Insights: Für end-to-end-Monitoring, SLA-Watching und automatisches Alerting.
- Terraform: Für Infrastructure-as-Code (IaC), um die Umgebung reproduzierbar und versionierbar zu halten.
- Azure Key Vault: Für das sichere Management von Secrets und Zertifikaten.
- Just-in-Time (JIT) Access: Ein Security-Tool, das temporäre Administratorrechte erteilt, um die Angriffsfläche zu minimieren.
Umsetzung: Phasierte Migration in 12 Wochen
Die Migration erfolgte in vier klar definierten Phasen über einen Zeitraum von 12 Wochen. Unser Ziel war es, die kritischen Arbeitslasten in eine aktive-aktive Architektur über zwei Azure-Regionen (Texas und Virginia) zu überführen. Diese Georedundanz stellt sicher, dass bei einem regionalen Ausfall die Produktion nahtlos in der anderen Region fortgesetzt wird.
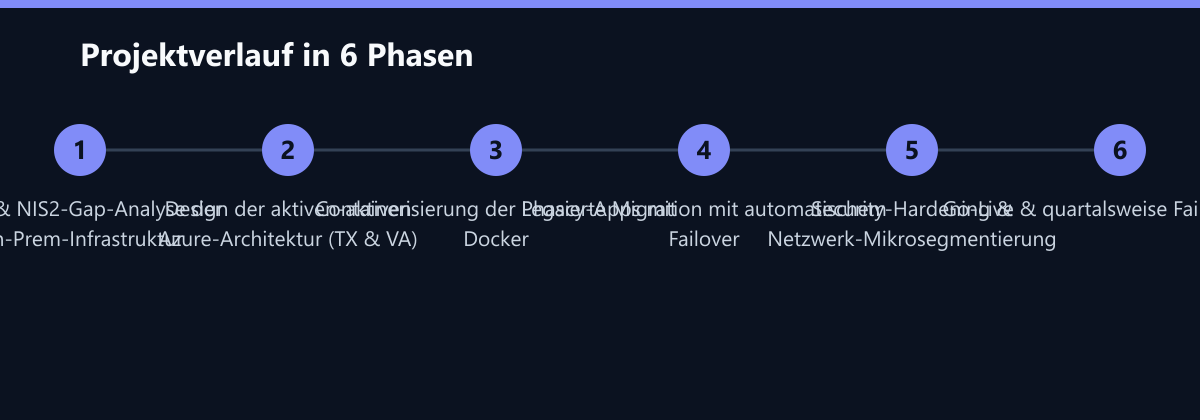
In der ersten Phase haben wir die Netzwerk-Grundstruktur und die Sicherheitsrichtlinien in Azure aufgebaut. Hier lag der Fokus auf der Mikrosegmentierung, um die neuen Workloads strikt von den restlichen Ressourcen zu isolieren. Parallel dazu haben wir die Legacy-Anwendungen in Docker-Container verpackt. Diese Containerisierung war entscheidend, da sie die Portabilität der Apps erhöhte und eine konsistente Laufzeitumgebung in beiden Regionen garantierte.
Die eigentliche Migration der Daten und der Anwendungslogik geschah in Phase zwei und drei. Wir nutzten Azure Database Migration Service (DMS) für die Datenbank-Synchronisierung, um Datenverluste zu vermeiden. Die aktive-aktive Logik wurde so konfiguriert, dass Lese- und Schreiboperationen intelligent zwischen den Regionen verteilt wurden. Phase vier diente dem Stress-Testing und der Feinjustierung der Failover-Logik. Jede Phase wurde mit einem detaillierten Rollback-Plan gesichert, um das Risiko für den laufenden Betrieb auf ein Minimum zu reduzieren.
Besonderes Augenmerk lag auf der Security-Hardening. Wir implementierten Just-in-Time-Zugriffe, bei denen Administratoren nur für den Zeitraum ihrer Wartungsarbeiten volle Rechte erhalten. Dies entspricht den NIST-Standards und reduziert die Gefahr von Insider-Bedrohungen oder kompromittierten Credentials erheblich.
Wie wir die Zahlen messen
Die Erfassung der KPIs erfolgte über ein automatisiertes Monitoring-Framework. Die Uptime wurde über Azure Monitor berechnet, der die Erreichbarkeit der Kern-Endpunkte alle 30 Sekunden prüft. Die Latenzmessung basierte auf Application Insights, die die Antwortzeiten der ERP-APIs in Millisekunden protokollierten. Vor der Migration diente ein Baseline-Wert von 100 % als Referenz. Die Kostenanalyse wurde über den Azure Cost Management Service durchgeführt, der die Ausgaben nach Ressourcenkategorien aufschlüsselte und mit den historischen On-Premise-Kosten (Lizenz, Strom, Personal) verglich. Der Failover-Test wurde manuell unter simulierten Bedingungen durchgeführt, wobei die Umschaltzeit mit hochauflösenden Zeitstempeln protokolliert wurde.
Ergebnis: Stabilität und Effizienz im Gleichgewicht
Seit dem Go-Live hat sich die Stabilität der IT-Infrastruktur fundamental verändert. Die Produktion läuft nun nahezu durchgehend ohne Unterbrechungen durch IT-Fehler. Die anfängliche Sorge, dass Redundanz zu höheren Kosten führen würde, hat sich als unbegründet erwiesen. Durch die effizientere Ressourcennutzung in der Cloud und die Konsolidierung von Lizenzen sanken die IT-Gesamtkosten sogar.
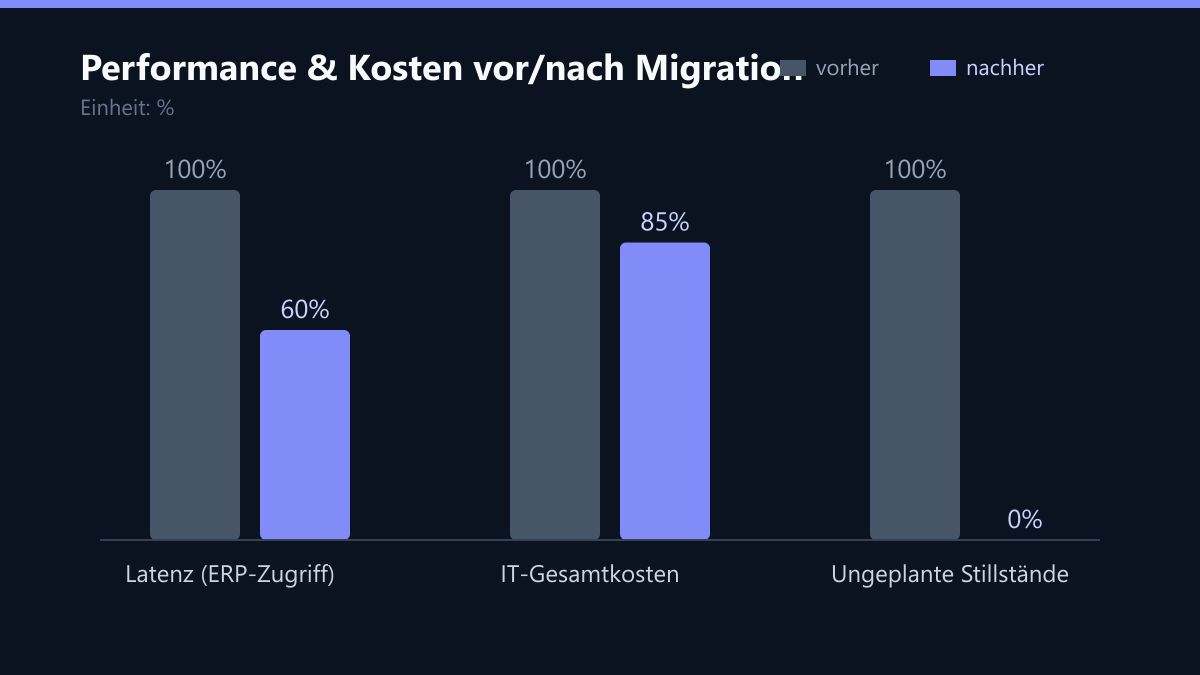
Die wichtigsten KPIs nach 6 Monaten zeigen einen klaren Erfolg:
- Uptime: Erreichte 99,99 % Verfügbarkeit der Kernsysteme. Das entspricht einer maximalen Ausfallzeit von wenigen Minuten pro Jahr.
- Reaktionszeit: Die Latenz für ERP-Zugriffe sank um 40 %. Die Containerisierung und die optimierte Netzwerklatenz in der Cloud beschleunigten die Transaktionen erheblich.
- Kosten: Trotz Redundanz sanken die IT-Gesamtkosten um 15 % durch effizientere Ressourcennutzung und geringere Wartungsaufwände.
- Resilienz: Der Failover-Test zeigte eine Umschaltzeit von unter 30 Sekunden. Das System erkennt einen Region-Ausfall und übernimmt die Last automatisch, bevor die Produktion betroffen ist.
Learnings: Was wir aus dem Projekt mitnehmen
Redundanz ist mehr als nur ein zweiter Server. Sie erfordert eine durchdachte Netzwerk-Architektur und klare Kommunikationsprozesse im Fehlerfall. Ein häufiger Fehler ist die Annahme, dass ein automatisiertes Failover ohne menschliche Eingriffe perfekt läuft. In der Praxis müssen die Prozesse im Team klar definiert sein, um Paniksituationen zu vermeiden.
Kern-Erkenntnisse für den Mittelstand:
- Automatisierung ist Pflicht: Manuelle Failover-Prozesse sind zu langsam für moderne Produktionen. Jeder zusätzliche Klick kostet Geld. Automatisierung reduziert nicht nur das Risiko, sondern auch den Stress im IT-Team.
- Kontinuierliche Tests: Failover-Übungen müssen quartalsweise real getestet werden, nicht nur auf dem Papier. Die Umgebung ändert sich ständig, und nur regelmäßige Tests garantieren, dass die Notfallpläne aktuell sind.
- Kosten-Nutzen-Abwägung: Die Investition in High Availability zahlt sich bereits nach einem einzigen vermiedenen Produktionsstopp aus. Bei einem Stundenverlust von 85.000 USD amortisiert sich die Cloud-Migration innerhalb weniger Wochen.
Was wir heute anders machen würden
Trotz des Erfolgs gibt es Punkte, die wir in zukünftigen Projekten optimieren würden. Erstens hätten wir die Containerisierung früher im Prozess angesetzt. Die Analyse der Abhängigkeiten der Legacy-Apps hätte in der Audit-Phase tiefer gehen können, um potenzielle Kompatibilitätsprobleme früher zu identifizieren. Zweitens hätten wir das Monitoring-Setup noch detaillierter auf die spezifischen Produktions-KPIs abgestimmt. Aktuell monitoren wir primär IT-Metriken, aber eine engere Kopplung an die MES-Daten hätte frühzeitige Warnungen vor Produktionsengpässen ermöglicht, die nicht direkt IT-bezogen sind.
Dieses Projekt zeigt, dass Cloud-Migration im Maschinenbau kein Luxus, sondern eine Notwendigkeit für Resilienz und Kosteneffizienz ist. Durch die Kombination aus aktiver-aktiver Architektur, Containerisierung und striktem Security-Hardening haben wir eine Infrastruktur geschaffen, die den Anforderungen der modernen Fertigung gerecht wird und gleichzeitig den finanziellen Druck auf das Unternehmen reduziert.
Passend dazu
- Server-Konsolidierung im Mittelstand: So reduzieren Sie Lizenzkosten und Stromverbrauch um 30 Prozent
- 5 Critical Security Measures for Your Managed Server Infrastructure
- Managed Hosting & Server-Hosting
- Netzwerk & Netzwerk-Infrastruktur
- Cloud Services & Cloud-Migration
- IT-Infrastruktur Konsolidierung im Maschinenbau
- B2B-Shop-Relaunch auf Magento 2 für einen Maschinenbauer
- Verringerung der Ticket-Last im Helpdesk um 40 Prozent bei einem Maschinenbauer in Deutschland durch Root-Cause-Analyse statt reaktiver Störungsbeseitigung
- Reduktion der Support-Arbeit um 40 Prozent: KI-Triage im E-Commerce für einen deutschen Magento-Händler
- Data Loss Vorfälle um 40 Prozent reduziert mit eDiscovery und DLP
- WooCommerce Performance: 7 Optimierungen für 50 Prozent schnellere Ladezeiten
- Multi-Tenant Office Umgebungen: Best Practices für geteilte Infrastruktur
- Globale DR-Synchronisierung für einen US-amerikanischen Maschinenbauer
- Warum Ihre Website langsam ist: Datenbank- und Server-Bottlenecks in 10 Minuten diagnostizieren
- Netzwerk-Infrastruktur auf KI-Workloads vorbereiten
- Serverless Architecture für Startups: Skalierung ohne Infrastruktur
- 85 Prozent weniger Passwortwiederverwendung nach Policy-Training
- Phishing-Reduktion um 78 Prozent: Security-Awareness-Programm für einen 400-köpfigen Maschinenbauer
- Warum Ihr IT-Helpdesk einen Cybersecurity-Fokus braucht
- Cyber-Resilience Act Vorbereitung: Gap-Analyse und Remediation Roadmap für einen Hamburger Maschinenbauer