Die wachsende Kostenfalle in der Cloud
Der Einstieg in die Cloud verspricht Flexibilität und Skalierbarkeit, doch für viele mittelständische Unternehmen wird sie schnell zur unkontrollierten Kostenfalle. Genau in dieser Situation befand sich ein mittelständischer Logistikdienstleister mit 250 Mitarbeitern im DACH-Raum. Die gesamte IT-Landschaft, von der Sendungsverfolgung bis zu internen Admin-Tools, lief in Microsoft Azure. Was als moderner Schritt gedacht war, entwickelte sich im Vorjahr zu einem finanziellen Druckpunkt: Die monatlichen Cloud-Ausgaben waren um 40 Prozent gestiegen, ohne dass eine gleichwertige Leistungszunahme oder ein neues Produktlaunch dies rechtfertigte hätte.
Die IT-Abteilung stand unter Druck. Das Management forderte spürbare Einsparungen, doch die Angst vor Ausfällen der kritischen Sendungsverfolgungs-Systeme war groß. Eine erste, grobe Analyse durch das interne Team ergab, dass ein erheblicher Teil der Ressourcen ungenutzt oder ineffizient bezogen wurde. Doch die genaue Tiefe des Problems war unklar. Wo lagen die Engpässe? Welche Workloads waren wirklich kritisch, und welche konnten flexibilisiert werden? Genau hier setzten wir an.
Herausforderungen: Zwischen Stabilität und Sparsamkeit
Die Optimierung einer produktiven Azure-Infrastruktur im laufenden Betrieb ist kein einfaches Unterfangen. Wir stießen auf drei zentrale Herausforderungen, die eine naive Herangehensweise unmöglich gemacht hätten.
Erstens die Abhängigkeit von statischen Ressourcen. Viele der Server waren seit Jahren auf einem hohen Leistungsniveau konfiguriert, um historische Spitzenlasten abzufedern. Diese „Reserven“ waren jedoch überdimensioniert und führten zu unnötigen Kosten. Zweitens die Komplexität der Abrechnungsmodelle. Azure bietet zahlreiche Optionen, aber die Kombination aus Reserved Instances, Spot-Instances und Pay-As-You-Go war im Vorfeld nicht optimal gewählt. Drittens die Furcht vor Instabilität. Der Kunde hatte in der Vergangenheit bereits mit kurzen Downtimes zu kämpfen, die den operativen Betrieb im Lager stören konnten. Jede Änderung musste daher absolut risikofrei und rückholbar sein.
Wie wir die Zahlen messen
Bevor wir auch nur eine Instanz skaliert haben, haben wir ein robustes Messkonzept etabliert. Wir haben Azure Cost Management Tools konfiguriert, um die Kosten pro Ressource und pro Tag zu tracken. Parallel dazu haben wir mit Azure Monitor die CPU-Auslastung, Speicher-Verbrauch und Netzwerk-I/Os der kritischen Workloads über einen Zeitraum von vier Wochen erfasst. Diese Daten bildeten die Grundlage für unser „Lastprofil“. Wir konnten so exakt bestimmen, wann und wie viel Leistung tatsächlich benötigt wurde. Ohne diese datenbasierte Ausgangslage wäre jede Skalierungsentscheidung ein Blindflug gewesen. Die Messung der API-Antwortzeiten erfolgte über ein synthetisches Monitoring-Tool, das die Latenz der Sendungsverfolgung im Sekundenintervall prüfte.
Der Tech-Stack
Für die Analyse und Umsetzung nutzten wir einen fokussierten Stack, der sich auf die Azure-Ökosystem-Tools konzentrierte:
- Azure Cost Management: Zur detaillierten Kostenanalyse und Identifikation von Sparpotenzialen.
- Azure Monitor: Zur Erfassung der Performance-Metriken und Lastprofile der VMs.
- Azure Automation: Zur Implementierung der Autoscale-Richtlinien und Scheduled Tasks.
- Terraform: Zur versionierten und wiederholbaren Verwaltung der Infrastruktur-Änderungen.
Umsetzung: In drei Phasen zur effizienten Infrastruktur
Nach der vierwöchigen Analysephase starteten wir mit der konkreten Umsetzung. Unser Ziel war es, die monatlichen Ausgaben zu senken, ohne die Verfügbarkeit der Kernsysteme zu beeinträchtigen. Wir teilten das Projekt in drei klar definierte Phasen auf, die über einen Zeitraum von sechs Wochen liefen. Jede Phase wurde in einer Parallelumgebung getestet, um sicherzustellen, dass keine Ausfallzeiten im Produktivbetrieb entstehen.
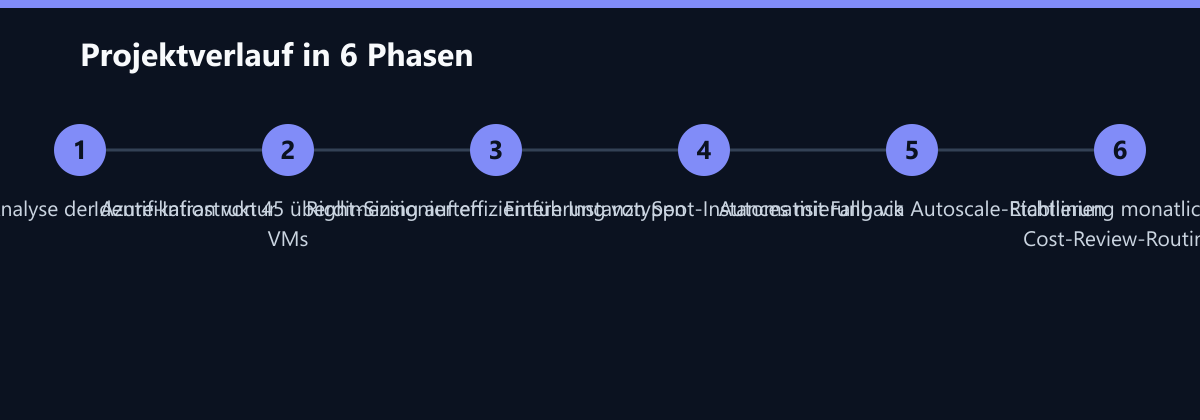
Die erste Phase konzentrierte sich auf das Right-Sizing. Wir haben 45 Virtual Machines identifiziert, die deutlich überdimensioniert waren. Statt große, teure Instanzen weiter zu betreiben, haben wir diese auf kleinere Instanztypen heruntergeskalisiert, die den tatsächlichen Lastprofilen entsprachen. Dies geschah schrittweise, beginnend mit den am wenigsten kritischen Systemen. Wir haben die Performance nach jeder Änderung beobachtet und erst dann zum nächsten Schritt übergegangen.
In der zweiten Phase haben wir Spot-Instances eingeführt. Für nicht-kritische Workloads wie Batch-Prozesse, die nächtlich ausgeführt werden, und Testumgebungen haben wir auf Azure Spot-Instances umgestellt. Diese bieten bis zu 90 Prozent Rabatt, sind aber volatil, da sie bei Preissprüngen oder Kapazitätsengpässen ausfallen können. Um dieses Risiko zu managen, haben wir automatisierte Fallback-Mechanismen implementiert. Sollte eine Spot-Instance entfernt werden, startet das System automatisch eine Standard-Instance, um die Aufgabe fortzusetzen. Dies hat die Kosten für diese Lasten drastisch gesenkt.
Die dritte Phase umfasste die Automatisierung. Wir haben Azure Autoscale-Richtlinien implementiert, die Ressourcen außerhalb der Kernarbeitszeiten herunterfahren oder skalieren. So wurden Testumgebungen nachts automatisch gestoppt, und die Batch-Prozesse starteten erst dann, wenn die Ressourcen verfügbar waren. Diese Maßnahmen haben nicht nur Kosten gespart, sondern auch die Komplexität des Betriebs reduziert, da weniger manuelles Eingreifen nötig war.
Ergebnis: 35 Prozent weniger Kosten bei besserer Performance
Das Ergebnis des Projekts war eindrucksvoll. Die monatlichen Azure-Kosten sanken von zuvor 42.000 Euro auf 27.300 Euro. Dies entspricht einer Senkung von 35 Prozent auf Basis der Vorjahreswerte. Was jedoch noch beeindruckender war: Die Leistungsfähigkeit der Kernsysteme blieb nicht nur erhalten, sondern verbesserte sich sogar.
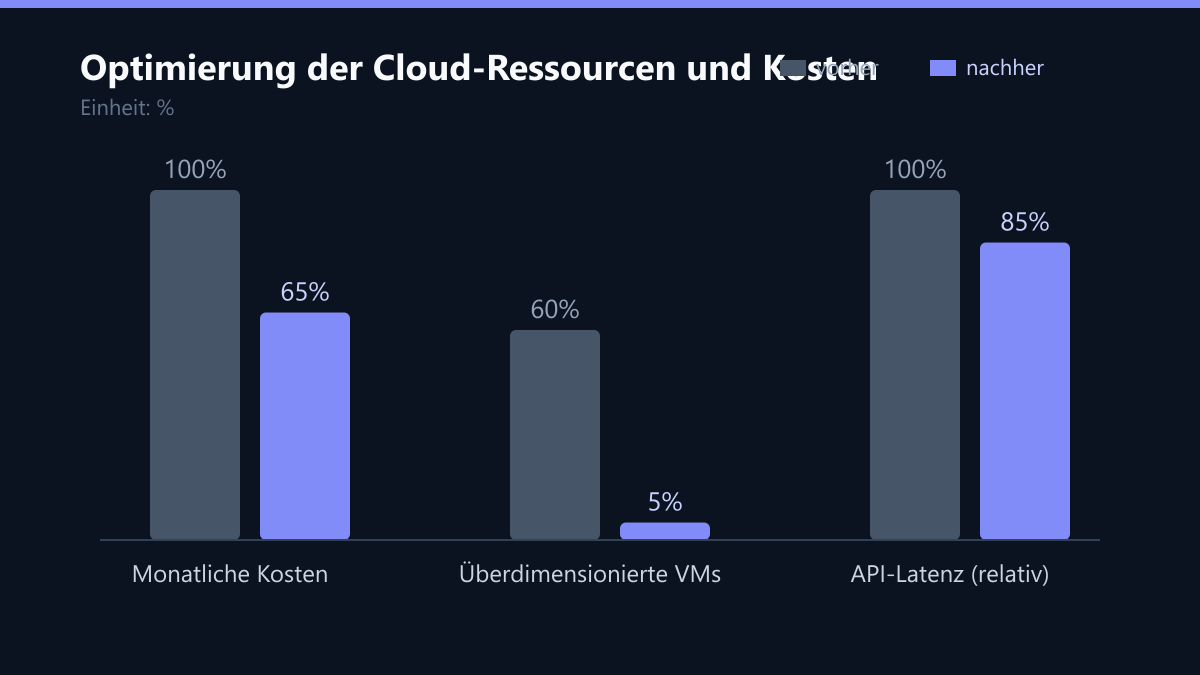
Die Antwortzeiten der Sendungsverfolgungs-API verbesserten sich um 15 Prozent. Dies lag daran, dass die überdimensionierten Instanzen durch effizientere, modernere Hardware ersetzt wurden, die weniger Latenz verursachte. Die Batch-Prozesse, die zuvor vier Stunden dauerten, wurden durch die optimierte Parallelisierung und die effizienteren Instanzen auf 3,5 Stunden reduziert. Der Anteil der überdimensionierten VMs sank von 60 Prozent auf nur noch 5 Prozent, was die Infrastruktur deutlich schlanker und wartbarer machte.
Learnings: Nachhaltigkeit durch Routine
Aus diesem Projekt haben wir mehrere wichtige Erkenntnisse mitgenommen, die über die reine Kostensenkung hinausgehen. Erstens: Regelmäßige Kostenanalysen sind für Cloud-Infrastrukturen ebenso wichtig wie Performance-Monitoring. Was einmal passt, muss nicht ewig passen. Lastprofile ändern sich, besonders in der Logistik mit ihren saisonalen Spitzen. Statische Reserven sind teuer; dynamische Skalierung ist effizient.
Zweitens: Spot-Instances sind riskant, aber lohnenswert. Der Schlüssel liegt in der Automatisierung. Mit robusten Fallback-Mechanismen lässt sich das Risiko minimal halten, während der finanzielle Nutzen enorm ist. Drittens: Kommunikation ist entscheidend. Die enge Zusammenarbeit zwischen IT und Fachbereich ermöglichte es, nicht-kritische Workloads sicher zu identifizieren. Ohne das Wissen der Fachabteilung, welche Prozesse wirklich kritisch sind, wäre die Umstellung auf Spot-Instances nicht möglich gewesen.
Was wir heute anders machen würden
Trotz des erfolgreichen Ergebnisses gibt es Punkte, die wir in Zukunft anders angehen würden. Erstens hätten wir die Analysephase noch etwas enger mit dem Fachbereich verzahnt. Einige der identifizierten „nicht-kritischen“ Workloads hatten unerwartete Abhängigkeiten, die erst in der Testphase auffielen. Eine frühere Einbindung der Business-Analysten hätte diese Risiken noch früher minimiert.
Zweitens hätten wir die Dokumentation der neuen Autoscale-Regeln noch detaillierter erstellt. Während die technische Umsetzung reibungslos lief, gab es anfangs Unklarheiten im Support-Team, wie die neuen Regeln zu interpretieren sind. Eine bessere Übergabe-Dokumentation hätte die Einarbeitungszeit verkürzt.
Drittens hätten wir von Anfang an ein Dashboard für die Fachabteilung bereitgestellt, das die Einsparungen in Echtzeit zeigt. Dies hätte die Motivation für die Zusammenarbeit gesteigert und die Akzeptanz der Änderungen im Unternehmen erhöht.
Durch die Implementierung einer monatlichen Cost-Review-Routine stellt der Kunde nun sicher, dass die Optimierungen nachhaltig bleiben und neue Ineffizienzen früh erkannt werden. Die Cloud-Infrastruktur ist nicht nur günstiger, sondern auch agiler und besser auf die Zukunft vorbereitet.
Passend dazu
- IT-Beratung & IT-Strategie
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- E-Commerce Entwicklung
- Hybride Azure-DR-Strategie: RTO auf 15 Minuten gesenkt
- Logistikunternehmen in Singapur: Optimierung der API-Latenz in einem hybriden Azure-AWS-Umfeld mit OpenTelemetry
- Reduktion der Support-Arbeit um 40 Prozent: KI-Triage im E-Commerce für einen deutschen Magento-Händler
- Legacy-ERP in der Cloud: Deployment-Zeit von Tagen auf Minuten reduziert
- Logistik-Unternehmen senkt Ausfallzeiten durch predictive Monitoring um 40 Prozent
- Ladezeit um 60 Prozent gesenkt durch Magento-Optimierung
- MTTR-Reduktion um 65 Prozent im Logistik-IT-Betrieb
- Custom Booking Engine für Fitness-Studios: 25 Prozent Umsatzsteigerung
- Cloud Security Kosten um 40 Prozent senken durch automatische Azure Policy Enforcement