Die unsichtbare Bremse in der hybriden Cloud
Für einen international tätigen Logistikdienstleister mit 850 Mitarbeitern in Singapur war die Zuverlässigkeit seiner digitalen Schnittstellen überlebenswichtig. Kunden erwarteten in Echtzeit den Status ihrer Fracht, doch die Realität sah anders aus: Sporadisch dauerte die Abfrage von Tracking-Statusen über 4 Sekunden. In einer Branche, in der Sekunden über die Kundenzufriedenheit entscheiden, war das ein kritischer Flaschenhals. Die Architektur bestand aus einem hybriden Cloud-Umfeld, das die Skalierbarkeit in Singapur und Europa gewährleisten sollte. Die Frontend-Komponenten liefen in Microsoft Azure, während die zentrale Datenbank in Amazon Web Services (AWS) residierte. Diese Trennung bot zwar geografische Redundanz, führte aber zu komplexen Netzwerkpfaden, die niemand vollständig durchschaute.
Das eigentliche Problem war jedoch nicht die Latenz an sich, sondern die fehlende Transparenz. Ohne zentrale Tracing-Tools war es für das DevOps-Team unmöglich zu lokalisieren, wo genau die Verzögerung entstand. Lag es am Netzwerk zwischen den Cloud-Anbietern? An der Datenbankabfrage in AWS? Oder an ineffizientem Application Code in den Microservices? Diese Unsicherheit führte zu einem weiteren, finanziellen Problem: Durch fehlende Lastverteilung und ineffiziente Timeout-Settings entstanden unnötige Cloud-Kosten in Höhe von ca. 12.000 SGD monatlich. Ressourcen wurden blockiert, während Requests warte, und die Infrastruktur lief nicht auf ihrer effizientesten Stufe.
Konkrete Herausforderungen
Die Komplexität des bestehenden Setups zeigte sich in mehreren spezifischen Punkten, die eine einfache „Tuning“-Maßnahme ausschlossen:
- Blindflug im Netzwerk: Die Kommunikation zwischen Azure und AWS lief teilweise über öffentliche Internet-Routen. Dies führte zu variabler Latenz und erhöhte die Sicherheitsrisiken bei grenzüberschreitenden Datenflüssen.
- Fehlende Standardisierung: Die Microservices waren in Node.js und Python entwickelt, nutzten aber unterschiedliche, proprietäre Monitoring-Lösungen. Es gab keine einheitliche Datenbasis, um Korrelationen zwischen Logs, Metriken und Traces zu ziehen.
- Datenbank-Überlastung: Die AWS-RDS-Instanz wurde durch redundante Leseanfragen für statische Tracking-Status überlastet, was die Antwortzeiten für neue Transaktionen verschlechterte.
Der Tech-Stack
Um die hybride Landschaft zu beherrschen, haben wir auf einen modernen, vendor-agnostischen Stack gesetzt:
- OpenTelemetry: Für die standardisierte Erfassung von Traces, Metriken und Logs in allen Services.
- Azure Log Analytics: Als zentrale Sammlung für die Telemetriedaten und für die Visualisierung in Dashboards.
- Azure Cache for Redis: Als In-Memory-Cache-Layer, um häufige Lesezugriffe auf die Datenbank zu vermeiden.
- Private Endpoints: Zur sicheren, direkten Verbindung zwischen Azure-Subnetzen und AWS-RDS-Instanzen.
- Node.js & Python SDKs: Zur nativen Instrumentierung der bestehenden Microservices.
Wie wir die Zahlen messen
Bevor wir optimierten, mussten wir messen. Wir definierten drei Kern-Kennzahlen, die den Erfolg des Projekts objektiv belegten. Die p95-Latenz (die Zeit, in der 95 % der Requests beantwortet wurden) diente als primärer Performance-Indikator, da sie Ausreißer besser abbildet als der Durchschnitt. Die Fehlerrate (Anteil der 5xx- und 4xx-Responses) maß die Stabilität der API. Schließlich trackten wir die monatlichen Cloud-Kosten, um den wirtschaftlichen Nutzen der architektonischen Änderungen zu quantifizieren. Alle Daten wurden über das Azure Monitor Dashboard in Echtzeit überwacht und mit den historischen Werten der letzten sechs Monate abgeglichen.
Umsetzung: Vom Chaos zur Transparenz
Wir starteten ein 10-wöchiges Projekt, das sich in drei Phasen gliederte. Zuerst schufen wir die Grundlage für Transparenz, dann optimierten wir den Datenpfad und zuletzt entlasteten wir die Datenbank.
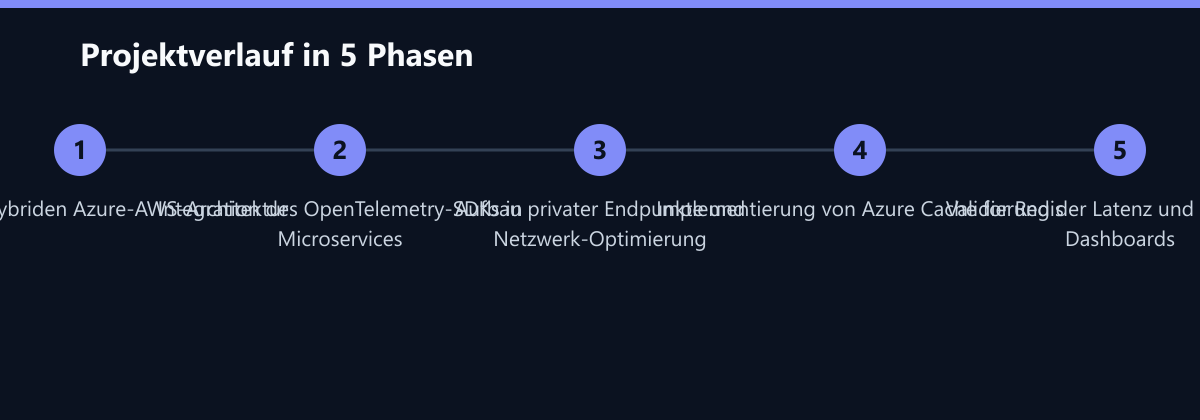
Phase 1: Instrumentierung mit OpenTelemetry
Der erste Schritt war die Einführung des OpenTelemetry SDKs in alle aktiven Microservices. Wir konfigurierten einheitliche Traces, Metriken und Logs, die an einen zentralen Collector in Azure Log Analytics exportiert wurden. Dies erlaubte es uns, einen einzelnen Request über den gesamten hybriden Pfad hinweg zu verfolgen – vom Eingang in Azure bis zur Antwort aus der AWS-Datenbank. Plötzlich konnten wir sehen, dass 70 % der Verzögerungen nicht im Code, sondern in der Netzwerkübertragung lagen.
Phase 2: Netzwerk-Optimierung und Sicherheit
Basierend auf den Tracing-Daten richteten wir einen privaten Endpunkt zwischen den Azure-Regionen und den AWS-RDS-Instanzen ein. Dadurch konnten wir die öffentlichen Internet-Routen um 90 % reduzieren. Dies senkte nicht nur die Latenz, da die Daten jetzt über ein privates, optimiertes Netzwerk flossen, sondern verkleinerte auch die Angriffsfläche erheblich. Zusätzlich implementierten wir Connection Pooling für die Datenbankabfragen, um die Überhead-Zeiten bei der Verbindungsaufnahme zu minimieren.
Phase 3: Intelligente Caching-Strategie
Um den Druck auf die AWS-Datenbank weiter zu senken, führten wir Azure Cache for Redis ein. Da sich Tracking-Statusdaten nur selten ändern, konfigurierten wir eine Cache-TTL (Time-to-Live) von 30 Sekunden. Das Ergebnis: Die meisten Abfragen wurden aus dem schnellen In-Memory-Cache beantwortet, bevor sie die Datenbank überhaupt erreichten. Dies entlastete die RDS-Instanz massiv und reduzierte die Abhängigkeit von der Netzwerklatenz zwischen den Clouds.
Ergebnis: Messbarer Erfolg
Nach dem Go-Live der optimierten Architektur zeigten die Dashboards in Azure Monitor eine deutliche Verbesserung. Die p95-Latenz sank von 3,2 Sekunden auf 1,0 Sekunden, was einer Reduktion von 68 % entspricht. Die Fehlerrate fiel von 4,5 % auf 0,2 %, was einer Verbesserung von 95 % gleichkommt. Gleichzeitig sanken die monatlichen Cloud-Kosten von 12.000 SGD auf 7.400 SGD, eine Einsparung von 38 %.
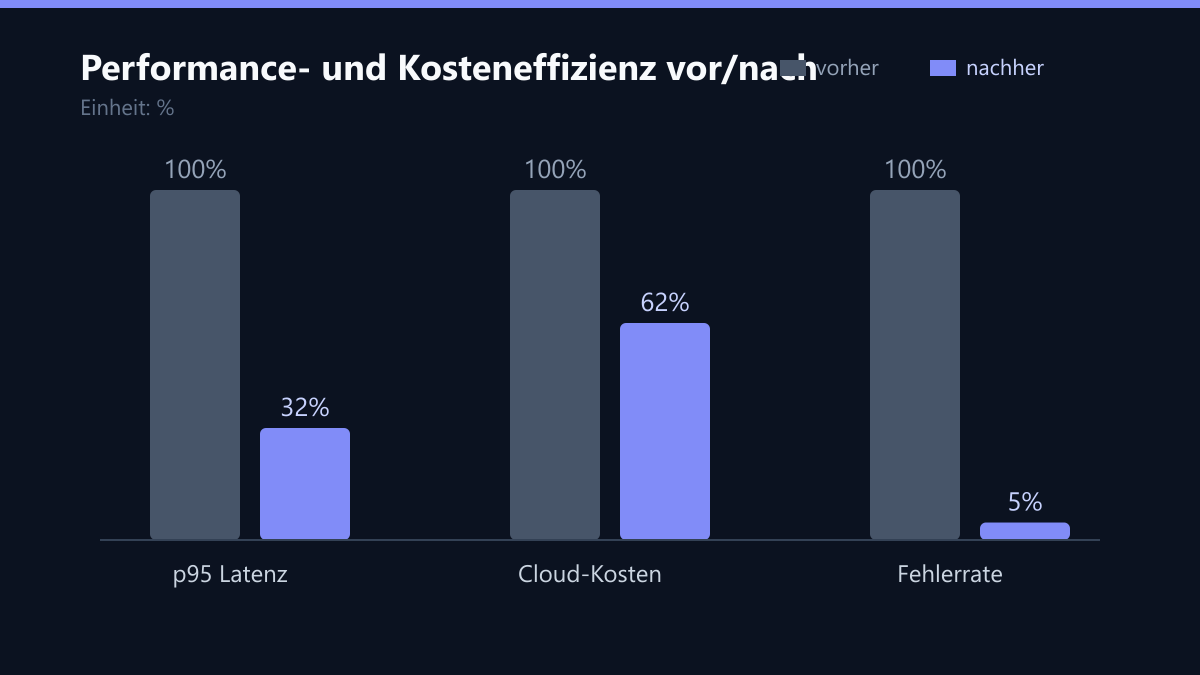
Weitere positive Effekte waren die schnellere Fehlerbehebung und die erhöhte Skalierbarkeit. Die Mean Time to Resolution (MTTR) sank von 4 Stunden auf 25 Minuten, da Entwickler den genauen Slowdown-Punkt im Trace-Graphen sehen konnten. Die API hält nun Spitzenlasten von 50.000 Requests pro Minute ohne Drosselung. Zudem wurde durch die privaten Endpunkte die Datenübertragung verschlüsselt und DSGVO-konform gehalten, auch bei grenzüberschreitenden Datenflüssen.
Was wir heute anders machen würden
Rückblickend hätten wir die Caching-Strategie früher in den Projektplan aufnehmen sollen. Die Analyse der Traces zeigte, dass das Caching das größte Potenzial hatte, aber die Implementierung erst in der dritten Phase stattfand. Ein früheres Testen hätte die Latenzreduktion bereits in Woche 4 sichtbar gemacht.
Zweitens hätten wir die Kosten-Tracking-Metriken noch granularer aufgeschlüsseln sollen. Wir haben die Gesamtkosten betrachtet, aber die spezifischen Kosten der Netzwerk-Transfers zwischen den Clouds wären ein noch stärkerer Motivator für die Umstellung auf private Endpunkte gewesen.
Drittens würden wir die Schulung des Entwicklungsteams in OpenTelemetry-Praktiken intensiver gestalten. Die Adoption der neuen Instrumentierung lief gut, aber ein tieferes Verständnis der Tracing-Daten hätte die Eigenverantwortung der Entwickler bei der Fehleranalyse noch weiter erhöht.
Learnings und Empfehlung
Die Einführung von OpenTelemetry war der entscheidende Hebel, um blinde Flecken in der hybriden Architektur zu beseitigen. Ohne die granulare Tracing-Daten hätte die Optimierung des Netzwerk-Pfads zwischen Azure und AWS nicht priorisiert werden können.
Für ähnliche Projekte empfehlen wir:
- Standardisierung: Vermeiden Sie proprietäre Monitoring-Lösungen, wenn Sie mehrere Cloud-Anbieter nutzen. OpenTelemetry ist der de-facto-Standard für Cloud-native Observability und ermöglicht den Wechsel der Backend-Anbieter ohne Code-Änderungen.
- Caching als First-Class-Citizen: Bei logistischen Daten, die sich nur selten ändern, ist ein Caching-Layer oft effektiver als reine Datenbank-Optimierung. Testen Sie früh, ob sich Daten cachen lassen.
- Kosten-Nutzen-Analyse: Die Investition in Observability-Tools amortisiert sich schnell, da sie direkte Einsparungen bei den Cloud-Infrastrukturkosten ermöglicht und die Produktivität der Entwickler steigert. Beobachtbarkeit ist kein Kostenfaktor, sondern ein Investition in Effizienz.