Ausgangslage: Die unsichtbare Kaskade
Der Kunde, ein spezialisierter Logistikdienstleister mit 350 Mitarbeitern im DACH-Raum, stand vor einem strukturellen Problem in seiner IT-Infrastruktur. Die zentrale Transportmanagementsystem (TMS)-Plattform war das Herzstück des operativen Geschäfts, doch sie litt unter wiederkehrenden, schwer einordenbaren Störungen. Die Mean Time to Recovery (MTTR) lag bei einem alarmierenden Durchschnitt von 4,2 Stunden pro Vorfall. In einer Branche, in der jede Stunde Stillstand im Lager direkt in versendete Frachtkosten, Strafen und steigende Kundenbeschwerden umschlägt, war das ein nicht mehr tragbares Risiko.
Das Kernproblem war jedoch nicht die Hardware oder die Software selbst, sondern die fehlende Korrelation der Daten. Die IT-Teams operierten in einer Silo-Struktur. Alerts aus der Netzwerkebene, den Server-Health-Metriken und den Applikationslogs trafen unkoordiniert und in hoher Frequenz ein. Wenn das TMS ausfiel, meldete das Monitoring-Tool gleichzeitig 50 verschiedene Warnungen: Paketverluste im WAN, hohe CPU-Last auf dem App-Server und Timeouts in der Datenbank. Die Technik verbrachte bis zu 60 % der gesamten Diagnosezeit damit, diese Symptome zu sortieren und die eigentliche Root Cause zu isolieren. Oft handelte es sich um dieselbe Ursache, die unterschiedliche Symptome auslöste – ein klassischer Kaskadeneffekt, der ohne korrelatives Monitoring unsichtbar bleibt.
Die Geschäftsleitung forderte daher eine drastische Reduktion der Downtime. Es ging nicht nur um technische Stabilität, sondern um die Wiederherstellung der operativen Zuverlässigkeit gegenüber den Kunden. Die IT-Abteilung stand unter Druck, von einer reaktiven “Brand-Behebung” zu einem proaktiven Betrieb zu wechseln, ohne das bestehende Personal zu erweitern.
Herausforderungen im Detail
Bevor mit der Implementierung begonnen wurde, mussten wir vier konkrete Hindernisse identifizieren, die eine einfache Einführung von Standard-Monitoring unwirksam gemacht hätten:
- Alert-Fatigue: Das bestehende System produzierte über 1.200 Notifications pro Tag. Die Techniker waren so überflutet, dass kritische Alerts in der Masse untergingen. Die Akzeptanz der Tool-Empfehlungen war auf ein Minimum gesunken.
- Fehlende Topologie-Verknüpfung: Es gab keine automatische Abbildung der Abhängigkeiten zwischen Netzwerk, Servern und Applikationen. Ein Netzwerk-Problem auf Layer 3 führte zu einem Applikations-Alert auf Layer 7, ohne dass das System den Zusammenhang herstellte.
- Heterogene Datenquellen: Die TMS-Plattform lieferte Logs in einem proprietären Format, während die Netzwerk-Switches SNMP-Metriken nutzten. Eine manuelle Korrelation war in Echtzeit unmöglich.
- Prozess-Integration: Das bestehende Ticketing-System war nicht auf die neuen Datenströme ausgelegt. Ohne eine nahtlose Integration in den Incident-Workflow wäre das neue Tool ein isoliertes “Dashboard-Bildschirm” geblieben, das niemand nutzte.
Die Umsetzung: Korrelation statt Volumen
Wir implementierten ein korrelatives APM-System (Application Performance Management), das alle IT-Schichten in einer einzigen, dynamischen Topologie verknüpft. Der strategische Fokus lag nicht auf der Erfassung aller möglichen Metriken, sondern auf der automatischen Zusammenführung und Filterung von Alerts. Ziel war es, aus 1.200 rohen Alerts nur noch die primäre Ursache zu melden.
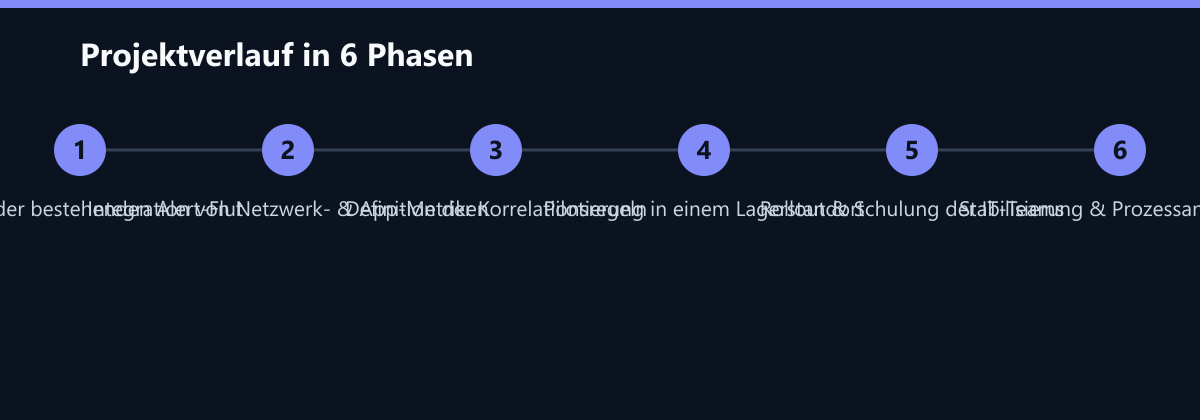
Die technische Umsetzung erfolgte in drei klar definierten Phasen über einen Zeitraum von sechs Wochen:
Phase 1: Integration & Sichtbarkeit (Woche 1-2) In dieser Phase wurde die Datenbasis geschaffen. Wir integrierten die Netzwerk-Metriken (SNMP, NetFlow), die Server-Health-Daten (CPU, RAM, Disk I/O) und die TMS-Applikationslogs in eine zentrale Plattform. Dabei nutzten wir eine agentenlose Überwachung für die Netzwerkebene, um die bestehende Infrastruktur nicht zu belasten. Für die Applikationsebene wurden Lightweight-Agents installiert, die Traces und Logs erfassen. Ein kritischer Aspekt war die Minimierung der Performance-Einbußen: Durch die Auswahl der Agenten und die Optimierung der Sampling-Raten hielten wir den Overhead im laufenden Betrieb auf unter 1 %.
Phase 2: Korrelationslogik & Filterung (Woche 3-4) Dies war die intellektuelle Kernphase. Wir konfigurierten Korrelationsregeln, die basierend auf der Topologie und zeitlichen Kausalitäten Alerts bündeln. Wenn ein Switch-Port ausfällt, wird der zugehörige Server-Alert als “abgeleitet” markiert und nicht separat eskaliert. Redundante Alerts wurden gefiltert. Das Ziel war es, die tägliche Notification-Last zu senken, ohne kritische Ereignisse zu übersehen. Wir definierten „Noise Reduction Rules“, die 80 % der irrelevanten Signale unterdrückten.
Phase 3: Workflow-Integration & Schulung (Woche 5-6) Die neue Datenquelle wurde in das bestehende Ticketing-System eingebunden. Incident-Workflows wurden angepasst, sodass ein korrelierter Alert automatisch einen Ticket mit vorgeschlagener Root Cause und betroffenen Services erzeugt. Parallel dazu schulten wir die IT-Belegschaft. Die Techniker lernten, die neue Topologie-Ansicht zu nutzen und die veränderten Alert-Strukturen zu interpretieren. Die Akzeptanz war entscheidend, da die Mitarbeiter zuvor an die „Alert-Flut“ gewöhnt waren und zunächst Skepsis gegenüber der Reduktion der Meldungen zeigten.
Der Tech-Stack
Folgende Komponenten bildeten das Fundament der Lösung:
- Korrelations-Engine: Eine regelbasierte Engine, die Topologie- und Zeitdaten vergleicht, um Kausalitäten zu bestimmen.
- Agentenlose Netzwerk-Monitoring: Erfassung von SNMP und NetFlow-Daten ohne Installation auf Endgeräten.
- Lightweight APM-Agents: Minimal-invasive Agenten für die TMS-Server, die Traces und Logs in Echtzeit senden.
- Zentrale Topologie-DB: Eine dynamische Datenbank, die die Abhängigkeiten zwischen Komponenten automatisch aktualisiert.
- API-Integrationsschicht: Verbindet das APM-System mit dem bestehenden Ticketing-Tool für automatische Ticket-Erstellung.
Wie wir die Zahlen messen
Um die Effektivität der Maßnahme objektiv zu belegen, definierten wir vor Projektstart klare Metriken und Messmethoden:
- MTTR (Mean Time to Recovery): Gemessen über das Ticketing-System. Die Zeitspanne vom “Incident Start” bis zum “Resolution” wurde für alle P1- und P2-Incidents im Zeitraum von 6 Monaten vor und nach der Implementierung verglichen. Wir schlossen rein geplante Wartungsfenster aus.
- Alert-Volume: Die Anzahl der an die IT-Teams gerichteten Notifications pro Tag. Dies wurde direkt aus dem Monitoring-Backend extrahiert. Wir unterschieden zwischen “Raw Alerts” (vor Filterung) und “Actionable Alerts” (nach Korrelation), um den Filter-Effekt zu isolieren.
- Diagnosezeit: Gemessen als die Zeit vom Eingang des ersten Alerts bis zur Bestätigung der Root Cause durch den Techniker im Ticket. Diese Daten wurden in einer Stichprobe von 50 Incidents manuell validiert, um die Genauigkeit der automatischen Logs zu prüfen.
- Uptime: Die Verfügbarkeit der TMS-Plattform wurde über Heartbeat-Monitoring gemessen. Die Ausfallzeiten wurden in Minuten pro Monat aggregiert und in Prozentpunkte umgerechnet.
Ergebnis: Von der Reaktion zur Prävention
Nach der vollständigen Implementierung und einer Stabilisierungsphase von vier Wochen zeigte sich ein deutlicher, messbarer Effekt auf die Reaktionszeiten und die Arbeitslast der IT-Abteilung. Die Zahlen nach 6 Monaten Betriebszeit unterstreichen den Erfolg des Ansatzes:
- MTTR: Senkung von 4,2 auf 1,47 Stunden (-65 %). Die Techniker konnten dank der korrelierten Alerts sofort die Ursache identifizieren, statt Symptome zu jagen.
- Alert-Volume: Reduktion der täglichen Notifications um 78 % (von 1.200 auf 264) durch Deduplizierung und Korrelation. Die Alert-Fatigue wurde eliminiert.
- Diagnosezeit: Verkürzung der durchschnittlichen Root-Cause-Analyse von 90 auf 15 Minuten. Die Topologie-Ansicht zeigte sofort, welche Komponente der Auslöser war.
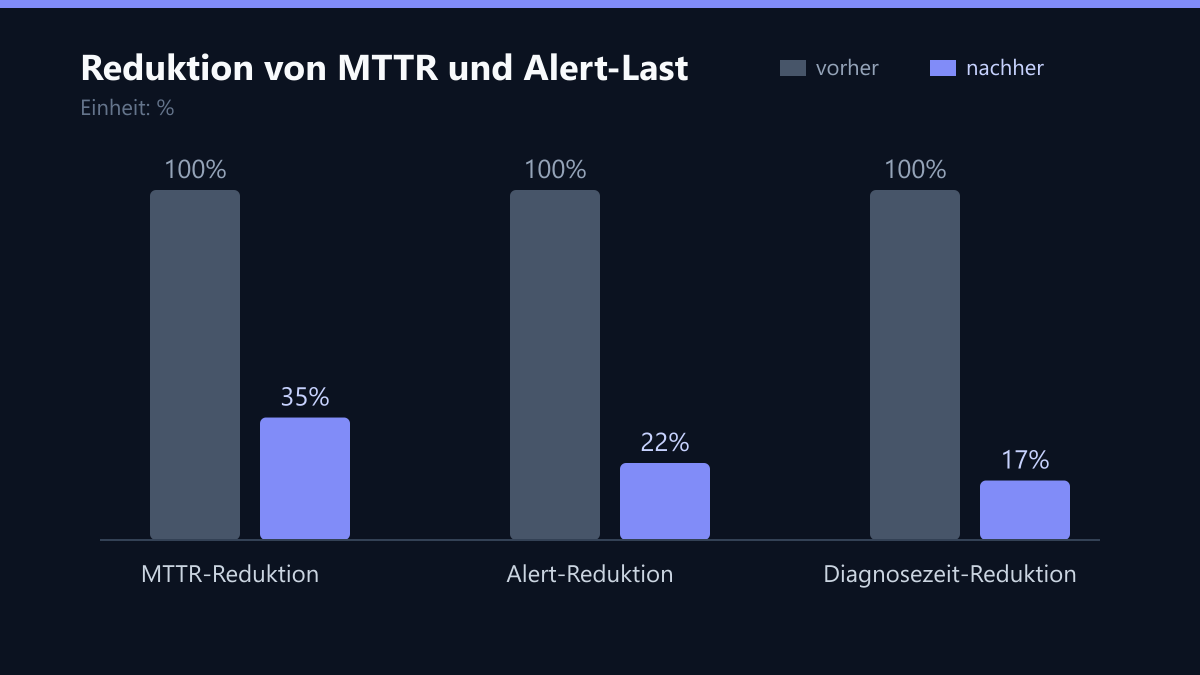
| Metrik | Vorher | Nachher | Änderung |
|---|---|---|---|
| MTTR | 4,2 h | 1,47 h | -65 % |
| Alerts/Tag | 1.200 | 264 | -78 % |
| Uptime TMS | 99,2 % | 99,95 % | +0,75 % |
Die IT-Abteilung konnte die freigewordene Kapazität für proaktive Wartung und die Optimierung der Infrastruktur nutzen. Die reaktive Brand-Behebung wurde deutlich effizienter, was zu einer spürbaren Entspannung im Tagesgeschäft führte. Die Geschäftsleitung registrierte eine signifikante Abnahme der Kundenbeschwerden bezüglich Systemausfälle.
Learnings und Erkenntnisse
Der größte Hebel in diesem Projekt war nicht die Technologie selbst, sondern die saubere Definition der Korrelationslogik. Ohne klare Regeln bleibt APM nur ein weiteres, komplexes Dashboard, das die Übersichtlichkeit verschlechtert, statt sie zu verbessern.
Drei zentrale Erkenntnisse aus dem Projekt sind für andere Unternehmen relevant:
- Weniger ist mehr: Das Filtern von 80 % der irrelevanten Alerts ist wichtiger als die Erfassung von 100 % der Daten. Qualität der Signale schlägt Quantität der Metriken.
- Prozesse vor Tools: Die Integration in den bestehenden Incident-Workflow war entscheidend für die Akzeptanz bei den Technikern. Ein Tool, das den Arbeitsfluss stört, wird nicht genutzt. Die Automatisierung der Ticket-Erstellung war der Schlüssel zum Erfolg.
- Korrelation statt Volumen: Entscheidend ist die Verknüpfung von Netzwerk- und Applikationsdaten, um Kaskadeneffekte sofort zu erkennen. Isolierte Monitoring-Tools liefern nur Symptome, korrelatives Monitoring liefert Ursachen.
Für Unternehmen mit komplexen IT-Landschaften ist korrelatives Monitoring kein Nice-to-have, sondern eine Voraussetzung für stabile Betriebsabläufe und eine effiziente IT-Abteilung.
Was wir heute anders machen würden
Trotz des Erfolgs gibt es Punkte, die wir bei einer erneuten Umsetzung optimieren würden, basierend auf den Erfahrungen aus diesem Projekt:
- Frühere Einbindung der Betriebsteams: Wir hätten die Techniker bereits in der Phase 1 (Integration) stärker in die Auswahl der Metriken einbinden sollen. So hätten wir von Anfang an nur die Daten erfasst, die für die Diagnose tatsächlich relevant sind, und die Datenlast in der Phase 2 weiter reduziert.
- Standardisierung der Log-Formate: Die Heterogenität der Log-Formate der TMS-Plattform erschwerte die Parsing-Regeln. Heute würden wir vor der Implementierung eine kurze Beratungsebene einziehen, um die Log-Struktur der Applikation leicht anzupassen, um die Korrelationsgenauigkeit zu erhöhen.
- Automatisierte Remediation: Wir hätten in Phase 3 bereits einfache Automatisierungs-Skripte (z. B. Neustart von Diensten) an die korrelierten Alerts gekoppeln können. Dies hätte die MTTR noch weiter gesenkt, da menschliche Eingriffe bei bekannten, harmlosen Fehlern entfallen wären.