Warum manuelle DR-Tests im Mittelstand scheitern
Manuelle Disaster-Recovery-Tests sind im Mittelstand oft ein Albtraum: Sie erfordern wochenlange Planung, koordinieren mehrere Abteilungen und verursachen erhebliche Produktivitätsverluste. Viele Unternehmen führen Tests daher nur einmal jährlich durch – oder gar nicht. Das Ergebnis ist besorgniserregend: Die IT-Abteilung weiß nicht, wie lange eine Wiederherstellung tatsächlich dauert (RTO) und wie viel Datenverlust (RPO) im Ernstfall hingenommen werden muss.
Diese Unkenntnis ist ein enormes Risiko. Wenn ein kritischer Server ausfällt, beginnt die Uhr sofort zu laufen. Ohne validierte Pläne herrscht Chaos. Automatisierte Failover-Tests lösen dieses Problem, indem sie die Validierung in eine nicht-invasive Simulation verwandeln. Statt produktive Systeme herunterzufahren, werden Snapshots oder Replikate in einer isolierten Testumgebung gestartet. So bleibt der Live-Betrieb unberührt, während die technische Integrität des DR-Plans geprüft wird.
Technische Funktionsweise der automatisierten Validierung
Die Automatisierung basiert auf dem Prinzip des Non-Disruptive Failover. Das System erstellt periodische Snapshots der kritischen Workloads – Server, Datenbanken und Applikationen. Diese Daten werden in einer separaten, vernetzten Sandbox-Umgebung rehydratiert. Diese Umgebung befindet sich oft in der Cloud oder in einem dedizierten DR-Rechenzentrum, ist aber strikt vom Produktivnetzwerk getrennt.
In dieser Sandbox laufen die Anwendungen exakt so, wie es im Produktivbetrieb der Fall wäre. Der Testprozess umfasst vier Kernbereiche:
- Boot-Sequenz-Prüfung: Starten die OS- und Anwendungsservices korrekt? Gibt es fehlende Treiber oder Konfigurationsfehler?
- Datenkonsistenz-Check: Sind Datenbank-Transaktionen vollständig und konsistent? Werden Logs korrekt geschrieben?
- Performance-Benchmark: Erreichen die Systeme die definierten Latenz- und Durchsatzziele? Ist die Antwortzeit innerhalb der SLAs?
- Anwendungslogik-Test: Funktionieren Login-Prozesse, API-Endpunkte und Geschäftslogiken wie erwartet?
Typische Fehler bei der Einführung
Viele Unternehmen scheitern nicht an der Technologie, sondern an der fehlerhaften Implementierung. Hier sind die häufigsten Stolpersteine, die Sie vermeiden sollten:
- Fehlende Netzwerkisolation: Wenn die Testumgebung nicht strikt vom Produktivnetzwerk getrennt ist, kann ein kompromittiertes Testsystem als Sprungbrett für Angreifer dienen. Achten Sie auf separate VLANs oder Cloud-Subnets ohne Route zur Produktion.
- Ignorieren von Abhängigkeiten: Oft werden nur einzelne Server getestet, nicht aber die Abhängigkeiten zu Datenbanken oder Middleware. Fehlt die Datenbank in der Sandbox, scheitert der Test an der Applikation, nicht am Backup.
- Fehlende Immutable Backups: Ohne schreibgeschützte Backups (Immutable) ist der Test gegen Ransomware-Angriffe wertlos. Wenn Angreifer die Backups löschen können, ist die Wiederherstellung im Ernstfall unmöglich.
- Kein Reporting-Workflow: Ein Test, dessen Ergebnisse niemand auswertet, ist Zeitverschwendung. Ohne automatisierte Berichte und Abweichungsanalysen wird der DR-Plan nicht verbessert.
Vorteile für Geschäftsführung und IT-Verantwortliche
Für IT-Entscheider und Geschäftsführer sind die messbaren Vorteile entscheidend. Automatisierte Tests liefern objektive Daten statt subjektiver Einschätzungen. Sie reduzieren das Risiko von Compliance-Verstößen, da nachweislich regelmäßig getestet wird. Dies ist relevant für Normen wie ISO 27001 und Gesetze wie NIS2, die regelmäßige Validierung von Sicherheitsmaßnahmen fordern.
Die wichtigsten Vorteile im Überblick:
- Kontinuierliche Validierung: Tests können wöchentlich oder täglich laufen, ohne dass IT-Mitarbeiter manuell eingreifen müssen. Die IT wird vom Routine-Aufwand befreit.
- Präzise RTO-/RPO-Messung: Sie erhalten exakte Zeitstempel für den Wiederherstellungsprozess. Statt “ungefähr 4 Stunden” wissen Sie, dass es 2:34 Stunden dauert.
- Ressourceneffizienz: Keine Notwendigkeit, teure physische Hardware für Tests zu mieten oder Personal für stundenlange Tests einzuplanen.
- Frühzeitige Fehlererkennung: Abhängigkeiten zwischen Systemen, die im Alltag unsichtbar sind, werden bei jedem Test sichtbar. Kleine Konfigurationsfehler werden behoben, bevor sie zu einem Ausfall führen.
Umsetzung in der Praxis: Schritt-für-Schritt
Die Einführung automatisierter Failover-Tests folgt einem klaren Prozess. Zuerst definieren Sie die kritischen Workloads und deren Priorisierung. Anschließend integrieren Sie ein Monitoring-Tool, das die Snapshots verwaltet und die Testumgebung orchestriert.
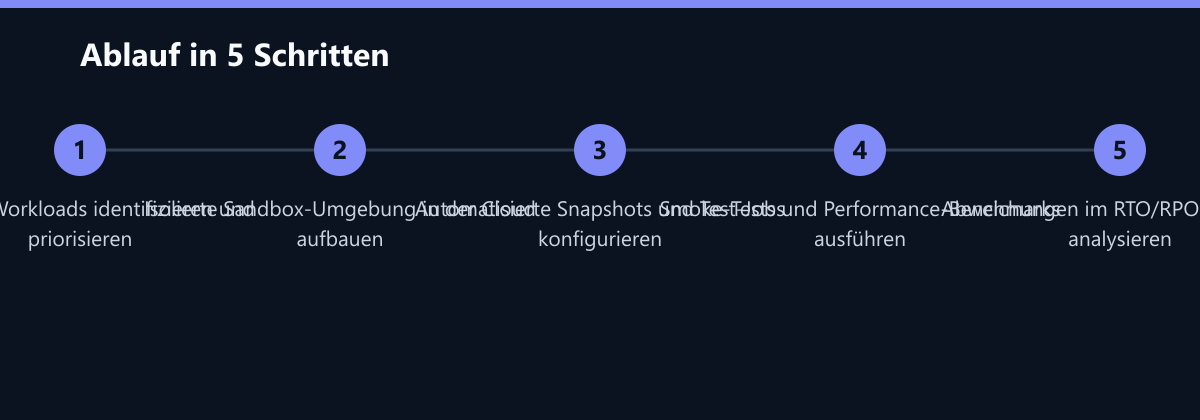
Schritt 1: Inventarisierung und Priorisierung Identifizieren Sie die Top 20 Prozent der Systeme, die 80 Prozent des Geschäftswerts ausmachen (Pareto-Prinzip). Definieren Sie für jede Anwendung den maximal tolerierbaren RTO und RPO. Beispielsweise: ERP-System RTO 4h, RPO 1h; CRM-System RTO 8h, RPO 4h.
Schritt 2: Testumgebung konfigurieren Richten Sie eine isolierte Netzwerkzelle ein. Diese muss die IP-Adressen und DNS-Einträge der Produktivumgebung simulieren können, ohne Konflikte zu erzeugen. Nutzen Sie hier am besten eine Cloud-Instanz, die auf Abruf gestartet wird.
Schritt 3: Automatisierung der Testläufe Konfigurieren Sie geplante Jobs, die Snapshots ziehen, die Umgebung starten und Smoke-Tests ausführen. Integrieren Sie diese Tests in Ihr bestehendes IT-Monitoring (z. B. via API-Webhooks), um Alerts bei Fehlern zu erhalten.
Schritt 4: Reporting und Abweichungsanalyse Generieren Sie Berichte, die Abweichungen vom definierten SLA hervorheben. Diese Berichte sind die Grundlage für die kontinuierliche Verbesserung des DR-Plans. Sie zeigen, ob der RTO eingehalten wurde und welche Komponenten am langsamsten waren.
Kosten-Nutzen-Analyse und ROI
Viele Mittelständler befürchten hohe Lizenzkosten. Die Investition in Automatisierung amortisiert sich jedoch schnell durch die Vermeidung von Ausfallkosten. Ein ungeplanter Ausfall eines ERP-Systems kann im Mittelstand schnell fünfstellige Beträge pro Stunde verursachen. Bei einer Ausfallzeit von 8 Stunden sind das schnell 80.000 € oder mehr an entgangenen Umsätzen und Produktivitätsverlusten.
Im Vergleich zu manuellen Tests:
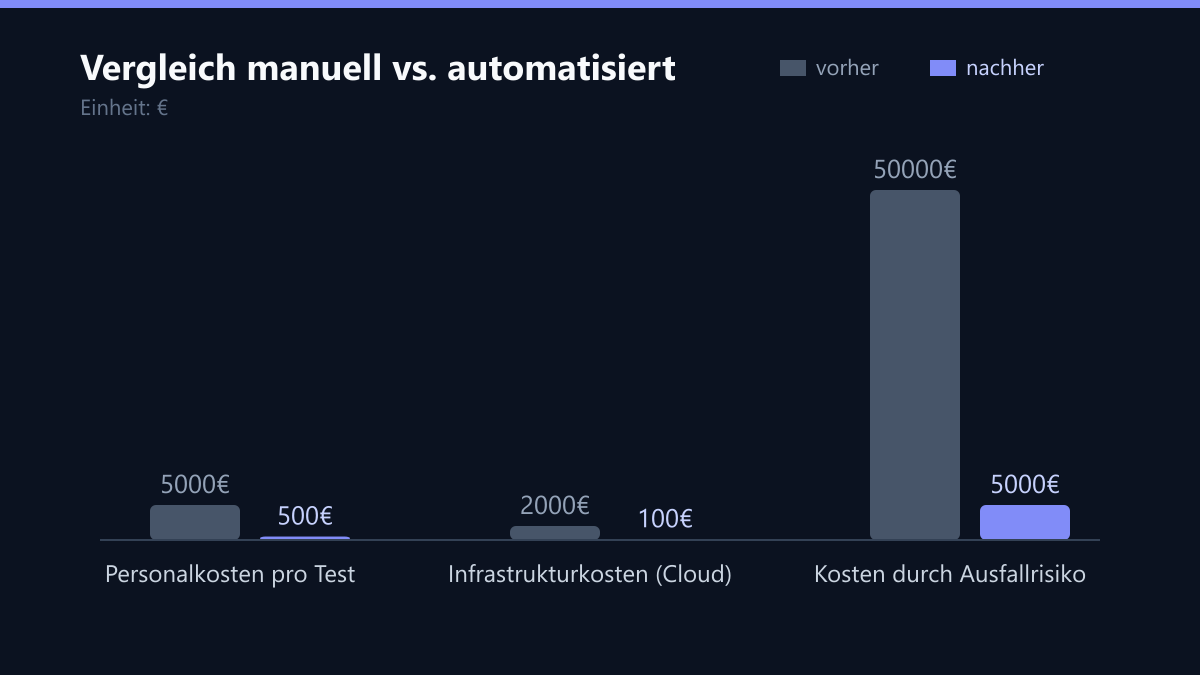
- Manuell: Hohe Personalkosten (ca. 5.000 € pro Test durch IT-Aufwand), geringe Testfrequenz (1x/Jahr), hohes Risiko von Fehlern durch menschliches Versagen.
- Automatisiert: Geringe Personalkosten (Setup einmalig, ca. 500 € pro Test für Monitoring), hohe Testfrequenz (täglich), hohe Zuverlässigkeit durch standardisierte Abläufe.
Die Cloud-basierte Ausführung der Testumgebung erlaubt zudem ein Pay-per-Use-Modell. Sie zahlen nur für die Zeit, in der die Testumgebung aktiv ist (z. B. 2 Stunden), was die Infrastrukturkosten minimiert. Statt ein zweites, dauerhaft laufendes Rechenzentrum (Hot Site) zu betreiben, zahlen Sie nur für die Testdauer.
So messen Sie den Erfolg
Ohne Metriken ist Automatisierung nur eine Spielerei. Definieren Sie klare Kennzahlen, um den Erfolg Ihrer Failover-Tests zu messen:
- RTO-Erreichungsrate: Anteil der Tests, bei denen die Wiederherstellungszeit unter dem definierten RTO lag. Ziel: 100 %. Messung: Zeitstempel von Start des Restore bis zur erfolgreichen Antwort der Applikation.
- RPO-Abweichung: Durchschnittliche Datenverlustzeit im Vergleich zum Ziel-RPO. Ziel: < 10 % des Zielwerts. Messung: Vergleich der letzten Transaktions-ID im Backup mit der aktuellen Zeit.
- Test-Fehlerrate: Anzahl der gescheiterten Tests pro Monat. Ziel: 0. Messung: Anzahl der Alerts im Monitoring-Tool, die auf einen fehlgeschlagenen Boot oder einen fehlenden Service hinweisen.
- Kosten pro Test: Gesamtkosten (Lizenz + Cloud-Infrastruktur + IT-Aufwand) geteilt durch die Anzahl der Tests. Ziel: Steigende Effizienz durch sinkende Kosten pro Test.
Checkliste für den Start
- Kritische Workloads identifiziert und RTO/RPO definiert?
- Isolierte Netzwerkumgebung (Sandbox) in der Cloud eingerichtet?
- Automatisierter Snapshot-Job konfiguriert?
- Smoke-Tests (Boot, Login, API) implementiert?
- Reporting-Workflow an IT-Monitoring angebunden?
- Immutable Backups für die Testumgebung aktiviert?
Integration in die IT-Sicherheitsstrategie
Failover-Tests sind kein isoliertes Thema, sondern ein Kernbestandteil der IT-Sicherheit. Cyberangriffe wie Ransomware zielen oft darauf ab, Backups zu löschen oder zu verschlüsseln. Automatisierte Tests können hier eine zusätzliche Schicht der Sicherheit bieten, indem sie die Integrität der Backups verifizieren. Wenn ein Backup nicht wiederhergestellt werden kann, ist es unbrauchbar – egal wie sicher es gespeichert ist.
Achten Sie darauf, dass die Testumgebung strikt vom Produktivnetzwerk getrennt ist. Dies verhindert, dass ein kompromittiertes Testsystem als Sprungbrett für Angreifer dient. Implementieren Sie zudem Immutable Backups, die nicht gelöscht oder verändert werden können, um die Resilienz gegen Ransomware-Angriffe zu erhöhen. So stellen Sie sicher, dass Sie auch nach einem Angriff einen sauberen Wiederherstellungspunkt haben.
Passend dazu
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- IT- & Daten-Wiederherstellung (Disaster Recovery)
- Backup-Integrität prüfen: 5 automatisierte Tests ohne Produktivitätsverlust
- AIOps im Mittelstand: Automatisierte Root-Cause-Analyse ohne Data-Science-Team
- Backup-Strategie für OT-Systeme: Schutz der Fertigung vor Ransomware ohne Produktionsstopp
- Backup-Verifikation: 5 Schritte für die Datenintegrität ohne Produktionsausfall
- Phishing-Simulationen: Echte Risikoanalyse ohne IT-Aufwand