Die stille Gefahr: Warum Ihr SIEM allein nicht schützt
Viele mittelständische Unternehmen haben in den letzten Jahren massiv in IT-Sicherheit investiert. SIEM-Systeme (Security Information and Event Management) und moderne Endpoint-Protection-Lösungen sind Standard. Das Problem ist jedoch die zugrunde liegende Denkweise: Diese Tools sind reaktiv. Sie warten auf Signaturen, die bereits bekannt sind, und schlagen Alarm, wenn ein Muster erkannt wird.
In der Realität operieren moderne Angreifer jedoch anders. Sie nutzen Zero-Day-Exploits, bei denen noch keine Signatur existiert, oder setzen auf Social Engineering, um sich legitime Zugänge zu verschaffen. Solange ein Angreifer sich im Netz bewegt, ohne bekannte Malware-Signaturen zu hinterlassen, bleibt er für reaktive Systeme unsichtbar. Das führt zu einer gefährlichen Lücke: Zwischen der tatsächlichen Kompromittierung und der ersten Erkennung durch ein automatisiertes Tool können Wochen vergehen. In dieser „Dwell Time“ haben Angreifer ausreichend Zeit, um sich lateral zu bewegen, Privilegien zu eskalieren und Daten zu exfiltrieren, bevor überhaupt ein Alarm ausgelöst wird.
Proaktiv statt reaktiv: Der Kern des Threat-Huntings
Threat-Hunting ist die antithetische Antwort auf dieses Problem. Es handelt sich nicht um ein Tool, sondern um eine methodische Herangehensweise. Ein Security-Analyst geht mit einer spezifischen Hypothese in die Daten. Statt zu fragen „Was hat mein SIEM gemeldet?“, fragt er: „Was würde ein Angreifer tun, wenn er bereits in unserem Netzwerk wäre?“.
Dieser Ansatz ist hypothese-getrieben. Der Analyst sucht aktiv nach Anomalien, die auf eine kompromittierte Umgebung hindeuten, aber nicht zwangsläufig als „Virus“ klassifiziert werden. Beispiele dafür sind ungewöhnliche Login-Zeiten, seltene Protokoll-Nutzung oder inkompatible Verbindungen zwischen Servern. Durch die manuelle Analyse und das Einbeziehen von Kontextwissen – das ein Algorithmus oft nicht hat – können Subtilitäten erkannt werden, die automatisierte Scans übersehen.
Warum der Mittelstand im Fokus der Angreifer steht
Es ist ein hartnäckiges Gerücht, dass Kriminelle nur große Konzerne angreifen. Die Realität ist das Gegenteil: Der Mittelstand ist ein bevorzugtes Ziel, oft aus zwei Gründen. Erstens gilt er fälschlicherweise als weniger gesichert als große Unternehmen mit dedizierten SOC-Teams. Zweitens ist der Mittelstand oft der eigentliche Lieferant der Großkonzerne. Ein Angriff auf den Mittelständler kann die Wertschöpfungskette des Konzerns unterbrechen – ein Hebel, der für Angreifer hochinteressant ist.
Typische Schwachstellen, die Angreifer im Mittelstand ausnutzen, sind:
- Fehlende Netzwerksegmentierung: Ein kompromittierter Endpunkt kann oft ungehindert auf sensible Server zugreifen.
- Legacy-Systeme: Alte, ungepatchte Systeme, die aus Abhängigkeitsgründen nicht abgeschaltet werden können.
- Mangelnde Schulung: Mitarbeiter, die Phishing-Mails nicht als solche erkennen.
- Log-Blindheit: Protokolle, die zwar existieren, aber nie zentral analysiert werden.
Der strukturierte Workflow: Von der Hypothese zur Reaktion
Threat-Hunting ist kein chaotisches Durchsuchen von Logs. Es folgt einem strikten, wiederholbaren Prozess, um Effizienz zu gewährleisten und Ressourcen nicht zu verschwenden. Ein strukturierter Workflow ist entscheidend, um aus der Masse an Daten sinnvolle Erkenntnisse zu destillieren.
| Phase | Aktivität | Zielsetzung |
|---|---|---|
| 1. Vorbereitung | Definition der Hypothese und Auswahl der relevanten Datenquellen (z. B. „Suche nach anomalen SMB-Verbindungen“). | Fokus setzen und Ressourcen sparen. |
| 2. Datenerhebung | Aggregation und Normalisierung von Logs aus Endpoint, Netzwerk und Cloud-Umgebungen. | Ein vollständiges, korreliertes Bild der Umgebung. |
| 3. Analyse | Korrelation von Ereignissen und Identifikation von statistischen Ausreißern oder Mustern. | Verdachtsmomente und potenzielle Indikatoren of Compromise (IoC) finden. |
| 4. Validierung | Manuelle Prüfung der Funde, um False Positives (falsch-positiv) auszuschließen. | Sicherstellen, dass es sich um eine echte Bedrohung handelt. |
| 5. Reaktion | Isolierung betroffener Systeme, Deaktivierung von Accounts und Dokumentation des Vorfalls. | Schaden begrenzen und Beweislage sichern. |
Dieser Prozess erfordert spezialisierte Tools zur Datenaufbereitung und, vor allem, geschultes Personal. Ein Analyst muss die eigene IT-Landschaft verstehen, um zu wissen, was „normal“ ist. Nur so kann er erkennen, was „abnormal“ ist.
Messbarer Erfolg: MTTD und Compliance
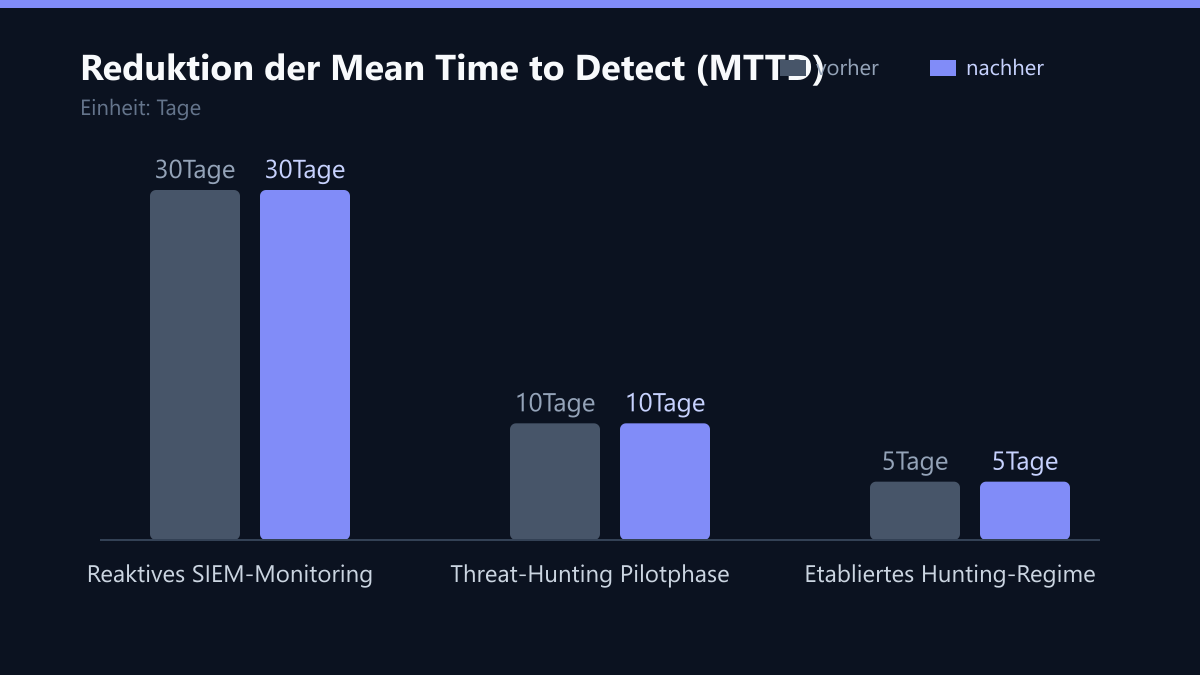
Der Umstieg von rein reaktivem Monitoring zu proaktivem Hunting bietet messbare Vorteile, die sich direkt in der Risikolage niederschlagen. Der wichtigste KPI ist die Mean Time to Detect (MTTD). Bei reaktivem Monitoring liegt diese im Mittelstand oft bei mehreren Wochen. Durch proaktives Hunting kann diese Zeit drastisch verkürzt werden, oft auf Tage oder sogar Stunden. Das bedeutet, dass der potenzielle Schaden (Datenverlust, Betriebsunterbrechung) signifikant reduziert wird.
Darüber hinaus spielt die Compliance eine immer größere Rolle. Regulierungen wie NIS2 oder ISO 27001 verlangen nicht nur, dass man „sicher ist“, sondern dass man nachweisbar sicherheitsrelevante Aktivitäten durchführt. Regelmäßige Threat-Hunting-Reports sind ein starkes Argument gegenüber Auditoren und Geschäftspartnern, dass Sie Ihre Pflichten proaktiv erfüllen. Zudem entsteht durch den Prozess ein wertvoller Wissenstransfer: Ihr IT-Team lernt, die eigene Infrastruktur tiefer zu verstehen und Schwachstellen zu priorisieren, die in der Routinearbeit oft untergehen.
Typische Fehler bei der Umsetzung
Viele Unternehmen scheitern nicht an der Technik, sondern an der Strategie. Hier sind die häufigsten Stolperfallen:
- Zu breite Hypothesen: „Suche nach allem“ führt zu Alert Fatigue. Hypothesen müssen spezifisch sein (z. B. „Suche nach anomalen Datenbank-Queries aus dem DMZ-Bereich“).
- Fehlende Datenqualität: Wenn Logs nicht zentral gesammelt oder Zeitstempel nicht synchronisiert sind, ist Korrelation unmöglich. Die Datenbasis muss vor dem Hunting gesichert sein.
- Ignorieren des Kontexts: Ein technischer Fund ohne geschäftlichen Kontext ist wertlos. Der Analyst muss wissen, welche Daten kritisch sind und welche Prozesse legitim sind.
- Einmaliger Scan statt Kontinuität: Threat-Hunting ist kein Projekt mit Ende, sondern ein kontinuierlicher Betrieb. Ein einzelner Scan liefert nur einen Momentaufnahme, keine langlebige Sicherheit.
So messen Sie den Erfolg konkret
Um den ROI von Threat-Hunting zu belegen, sollten Sie folgende Kennzahlen tracken:
- MTTD (Mean Time to Detect): Die durchschnittliche Zeit von der Kompromittierung bis zur Erkennung. Ziel: Reduktion von Wochen auf Tage.
- Anzahl der identifizierten IoCs (Indicators of Compromise): Wie viele konkrete Hinweise auf Einbrüche wurden gefunden, die vom SIEM nicht gemeldet wurden?
- False Positive Rate: Wie viele Alarme waren unnötig? Ein sinkender Wert zeigt, dass die Hypothesen besser kalibriert sind.
- Abgedeckte Asset-Klasse: Wie viele Prozent der kritischen Assets werden regelmäßig gehuntet?
Checkliste für den Einstieg
Wenn Sie Ihr Unternehmen auf proaktive Sicherheit umstellen wollen, folgen Sie dieser Checkliste:
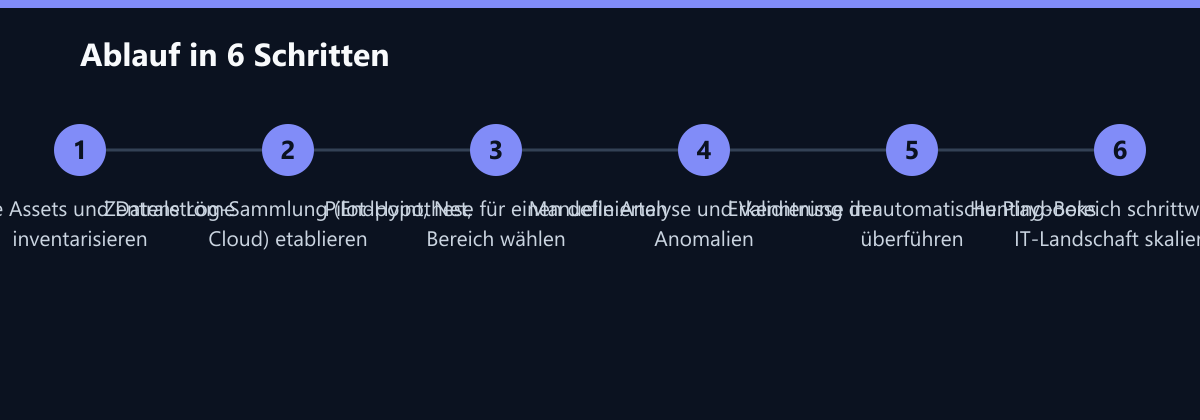
- Bestandsaufnahme: Identifizieren Sie Ihre kritischen Assets (Kronjuwelen) und die dazugehörigen Datenströme.
- Log-Infrastruktur: Stellen Sie sicher, dass alle relevanten Logs (Endpoint, Firewall, AD, Cloud) zentral und in einem nutzbaren Format verfügbar sind.
- Pilotprojekt starten: Wählen Sie einen definierten Bereich (z. B. Server-Infrastruktur) und eine klare, testbare Hypothese.
- Hypothese testen: Führen Sie die Analyse durch, validieren Sie die Funde und dokumentieren Sie den Prozess.
- Erkenntnisse automatisieren: Überführen Sie erfolgreiche Suchmuster in automatische SIEM-Regeln oder Playbooks, um die Last zu reduzieren.
- Skalierung: Erweitern Sie das Hunting schrittweise auf weitere Bereiche, basierend auf den gewonnenen Erkenntnissen und dem Risikoprofil.
Fazit: Vorbereitung ist der beste Schutz
Sie müssen nicht sofort ein eigenes SOC aufbauen. Ein hybrides Modell, das automatisierte Tools mit externer Expertise kombiniert, ist für den Mittelstand oft der effizienteste Weg. Mit der richtigen Strategie und Unterstützung durch spezialisierte IT-Beratung können Sie Ihre Sicherheitslage signifikant verbessern. Der Wechsel von reaktiv zu proaktiv ist keine Option mehr, sondern eine Notwendigkeit, um auf Bedrohungen vorbereitet zu sein, bevor sie zu einem teuren Incident werden. Starten Sie heute mit einer kleinen Hypothese und bauen Sie darauf Ihr Fundament auf.