Die Lücke zwischen grüner Infrastruktur und roter Nutzererfahrung
In vielen mittelständischen IT-Landschaften herrscht ein gefährliches Missverständnis: Solange die CPU-Last unter 80 Prozent liegt und der Speicher nicht voll ist, läuft alles gut. Klassische Monitoring-Systeme melden dann „Alles in Ordnung“. Doch in der Realität kann die Website bereits spürbar langsam sein, der Login schlägt fehl oder der Checkout-Prozess bricht ab, während die Server im Rechenzentrum technisch intakt erscheinen. Dieser Zustand führt nicht nur zu verärgerten Kunden, sondern treibt die Ticket-Last im Support in die Höhe, da die IT-Abteilung erst nachträglich und oft blind nach der Ursache suchen muss.
Synthetisches Monitoring schließt genau diese Lücke. Es verschiebt den Fokus von der reinen Ressourcennutzung hin zur tatsächlichen Geschäftsergebnis-orientierten Verfügbarkeit. Statt zu fragen „Läuft der Server?“, fragt das System „Funktioniert der Service für den Kunden?“. Durch die Simulation realer Nutzerpfade erkennen Sie Probleme, bevor der erste echte Kunde den Fehler bemerkt und sich beschwert.
So funktionieren synthetische Checks im Detail
Die Technik dahinter ist einfach, aber wirkungsvoll. Synthetisches Monitoring nutzt Skripte oder Bots, die definierte Nutzerpfade durchlaufen. Ein typischer Check für einen E-Commerce-Shop könnte aussehen wie folgt: Die Startseite wird geladen, ein Produkt wird in den Warenkorb gelegt, die Kasse wird geöffnet und ein Test-Login durchgeführt. Jeder einzelne Schritt wird mit exakten Zeitstempeln und HTTP-Statuscodes protokolliert.
Besonders wichtig ist die geografische Verteilung dieser Checks. Da die Leistung einer Anwendung oft von der Nähe zum Server oder dem verwendeten Netzwerk abhängt, werden die Tests aus verschiedenen Standorten (z. B. Frankfurt, New York, Singapur) und über verschiedene Netzwerktypen durchgeführt. So erkennen Sie sofort, ob ein Problem global ist oder nur bestimmte Regionen betrifft. Die Auswertung erfolgt in Echtzeit, was bedeutet, dass Alarme ausgelöst werden, bevor die Auswirkung auf den Umsatz signifikant wird.
Es gibt drei Hauptkategorien von synthetischen Checks, die Sie kombinieren sollten:
- Synthetische Transaktionen: Simulieren komplette Geschäftsprozesse, wie z. B. eine vollständige Bestellung oder den Zugriff auf ein Intranet-Portal.
- Ping-Checks: Messen die Latenz und Erreichbarkeit einzelner Endpunkte, wie z. B. einer Datenbank-API oder eines CDN-Knotens.
- Browser-Checks: Validieren, ob Seiteninhalte korrekt gerendert werden, ob Bilder geladen sind und ob JavaScript-Fehler vorliegen, die die Interaktivität blockieren.
Warum der Mittelstand proaktiv sein muss
Im Mittelstand fehlt oft das Personal für eine 24/7-Überwachung durch einen großen NOC (Network Operations Center). Synthetisches Monitoring automatisiert diese Aufgabe. Sie erhalten klare, binäre Signale: Der kritische Prozess funktioniert oder er funktioniert nicht. Innerhalb von Sekunden wissen Sie, ob das Online-Shop-Checkout oder der Zugang zum Intranet gestört ist.
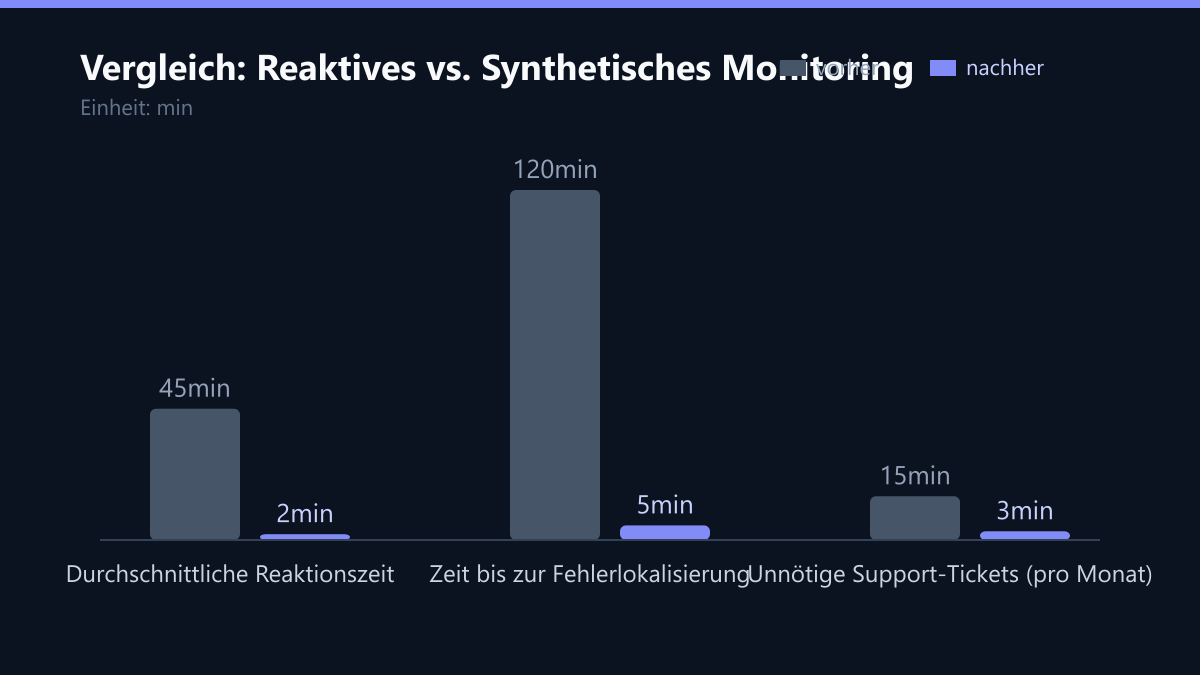
Dies führt zu einer drastischen Reduktion der Mean Time to Repair (MTTR). Statt stundenlanger Fehlersuche bei einer vagen Kundenmeldung („Die Seite geht nicht“), erhalten Sie einen exakten Hinweis auf den fehlerhaften Schritt (z. B. „Zeitüberschreitung beim Laden der Zahlungs-API“). Das schützt nicht nur Ihre Reputation, sondern direkt Ihren Umsatz, da Ausfallzeiten minimiert werden.
Die konkreten Vorteile für Ihre IT-Organisation sind:
- Proaktive Störungserkennung: Probleme werden gemeldet, bevor Kunden sie melden. Sie lösen das Problem, bevor es ein Support-Ticket wird.
- Präzise Fehlerlokalisierung: Der Alarm zeigt direkt den defekten Prozessschritt an, was die Troubleshooting-Zeit massiv verkürzt.
- SLA-Nachweis: Sie erhalten objektive, zeitgestempelte Daten zur Verfügbarkeit, die Sie gegenüber Vertragspartnern oder Kunden als Nachweis für vereinbarte Service Levels nutzen können.
Synthetisch vs. Reales Monitoring: Die richtige Kombination
Ein verbreitetes Missverständnis ist, dass synthetisches Monitoring echtes Monitoring ersetzt. Das ist falsch. Beide Ansätze sind sich ergänzende Werkzeuge. Synthetische Checks zeigen, ob der Service grundsätzlich funktioniert. Reales Monitoring (Real User Monitoring, RUM) zeigt, wie echte Nutzer dabei performen und welche Geräte oder Browser sie verwenden.
Für viele Mittelständler ist synthetisches Monitoring der kosteneffizientere Einstieg. Es liefert bereits 80 Prozent der proaktiven Sicherheit mit deutlich geringerem Datenaufkommen und einer viel einfacheren Auswertung. RUM erzeugt massive Datenmengen, die aufwendig zu analysieren sind. Wenn Sie später tiefgehende Performance-Analysen einzelner Nutzergruppen oder A/B-Testing-Daten benötigen, können Sie RUM ergänzen. Für die reine Störungserkennung und den SLA-Nachweis ist synthetisches Monitoring jedoch das Werkzeug der ersten Wahl.
| Merkmal | Synthetisches Monitoring | Reales Monitoring (RUM) |
|---|---|---|
| Datenquelle | Simulierte Tests (Bots) | Echte Nutzerdaten |
| Erkennungsgeschwindigkeit | Sofort (proaktiv) | Verzögert (reaktiv) |
| Kosten | Gering (feste Checks) | Höher (viele Datenpunkte) |
| Hauptnutzen | Störungsalarm & SLA | Performance-Optimierung |
Implementierung: In drei Schritten zum proaktiven Monitoring
Die Einführung von synthetischem Monitoring ist kein Großprojekt, sondern lässt sich schnell in bestehende IT-Prozesse integrieren. Der Schlüssel zum Erfolg liegt darin, den Umfang strikt auf die kritischsten Geschäftsprozesse zu beschränken. Versuchen Sie nicht, alles zu überwachen, sondern nur das, was Geld kostet, wenn es ausfällt.
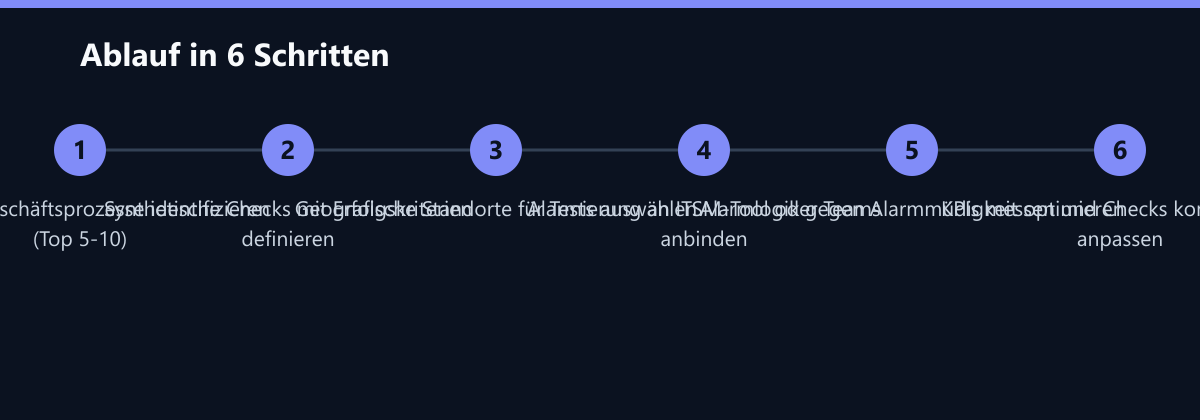
- Kritische Pfade identifizieren: Wählen Sie die 5 bis 10 Prozesse aus, deren Ausfall den größten Umsatz- oder Produktivitätsverlust verursacht. Beispiele sind der Login, der Checkout, die API-Abfragen für Partner oder der Zugriff auf das HR-Portal. Dokumentieren Sie diese Pfade schriftlich.
- Checks konfigurieren: Definieren Sie die Test-Schritte und die Erfolgskriterien. Was gilt als Erfolg? Typische Kriterien sind: Antwortzeit unter 2 Sekunden, HTTP-Status 200, keine JavaScript-Fehler auf der Seite, korrekte Anzeige des Logos. Setzen Sie Schwellenwerte, die für Ihr Geschäft realistisch sind.
- Alarmierung koppeln: Verknüpfen Sie die Alerts mit Ihrem ITSM-Tool (z. B. Jira, ServiceNow) oder Ihrer Kommunikationsplattform (z. B. Microsoft Teams, Slack, E-Mail). Stellen Sie sicher, dass nur relevante Störungen eskaliert werden. Eine zu aggressive Alarmierung führt zu „Alarmmüdigkeit“, bei der echte Störungen ignoriert werden. Nutzen Sie Eskalationsstufen: Erst eine Warnung, dann ein kritischer Alarm nach 5 Minuten, dann ein Anruf.
Typische Fehler bei der Einführung
Auch bei der scheinbar einfachen Einführung von synthetischem Monitoring passieren häufig Fehler, die den Nutzen mindern:
- Überwachung von nicht-kritischen Seiten: Wenn Sie jede einzelne Unterseite überwachen, entstehen zu viele Alarme für Probleme, die keinen geschäftlichen Einfluss haben. Fokussieren Sie sich auf die Conversion-Pfade.
- Fehlende geografische Abdeckung: Wenn Sie alle Checks nur aus einem Standort (z. B. dem eigenen Rechenzentrum) starten, erkennen Sie Probleme bei Kunden in anderen Regionen nicht. Mindestens zwei bis drei Standorte sind sinnvoll.
- Ignorieren von False Positives: Wenn das Monitoring-System selbst Probleme hat oder die Test-IPs blockiert werden, erhalten Sie falsche Alarme. Prüfen Sie regelmäßig, ob die Test-IPs in der Firewall erlaubt sind.
- Keine Eskalationslogik: Wenn jeder kleine Latenz-Anstieg einen Alarm auslöst, wird das System ignoriert. Definieren Sie klare Toleranzbereiche.
Kosten-Nutzen-Betrachtung und ROI
Die Kosten für synthetisches Monitoring skalieren mit der Anzahl der Checks und der gewählten Standorte. Für einen Mittelständler liegen die monatlichen Kosten für ein solides Setup oft im niedrigen vierstelligen Eurobereich (z. B. 500–1.500 Euro). Im Vergleich zu den Kosten einer Stunde IT-Support (die je nach Tarif 80–150 Euro betragen kann) oder dem Umsatzverlust durch eine Website-Ausfallzeit ist das eine geringe Investition.
Berechnen Sie den ROI anhand der vermiedenen Störungsmeldungen und der eingesparten Zeit. Wenn synthetisches Monitoring im Durchschnitt zwei kritische Vorfälle pro Monat vor dem Kundenkontakt erkennt, hat sich die Investition bereits amortisiert. Nehmen wir an, die manuelle Behebung eines solchen Vorfalls dauert im Schnitt 2 Stunden (160–300 Euro Kosten). Zwei Vorfälle pro Monat sparen also 320–600 Euro an Support-Kosten. Hinzu kommt der unsichtbare Gewinn durch geschützte Umsätze und zufriedene Kunden. Zudem steigt die Zufriedenheit der Fachabteilungen, da IT-Probleme schneller gelöst werden und die Kommunikation transparenter ist.
- Vermeidete Support-Tickets: Weniger manuelle Erfassung und Analyse durch den Helpdesk.
- Geschützte Umsatzkanäle: Minimierung von Ausfallzeiten im E-Commerce und in B2B-Portalen.
- Höhere IT-Verfügbarkeit: Messbare Verbesserung der Service-Level-Agreements und weniger Vertragsstrafen.
So messen Sie den Erfolg
Um den Wert des synthetischen Monitorings zu belegen, sollten Sie folgende Kennzahlen (KPIs) tracken:
- MTTR (Mean Time to Repair): Vergleichen Sie die durchschnittliche Zeit von der Störungserkennung bis zur Behebung vor und nach der Einführung. Ziel: Reduktion um mindestens 30–50 %.
- Proaktive Erkennungsquote: Wie viele Störungen wurden durch das System erkannt, bevor ein Kunde gemeldet hat? Ziel: Über 80 % der kritischen Störungen.
- False Positive Rate: Wie viele Alarme waren unnötig? Ziel: Unter 5 % der totalen Alarme. Eine hohe Rate deutet auf falsche Schwellenwerte hin.
- Support-Ticket-Reduktion: Zählen Sie die Anzahl der Tickets mit dem Betreff „Website langsam“ oder „Login geht nicht“. Diese sollten signifikant sinken.
Checkliste für die erfolgreiche Implementierung
- Kritische Geschäftsprozesse (Top 5) identifiziert und dokumentiert.
- Erfolgskriterien (Zeit, Statuscode, Inhalt) für jeden Pfad definiert.
- Mindestens zwei geografische Standorte für die Checks ausgewählt.
- Integration in das bestehende ITSM-Tool oder Kommunikationskanal eingerichtet.
- Eskalationsstufen und Ruhezeiten (z. B. nachts) konfiguriert.
- Testlauf durchgeführt und False Positives analysiert.
- Schulung der IT-Beauftragten zur Interpretation der Dashboards abgeschlossen.
Fazit: Investition in Geschäftssicherheit
Synthetisches Monitoring ist kein optionales Extra für IT-Profis, sondern ein essenzielles Werkzeug für den Mittelstand, der digital arbeitet. Es übersetzt technische Infrastruktur in geschäftliche Verfügbarkeit. Mit einer klaren Fokussierung auf kritische Pfade, einer sauberen Alarmierung und der regelmäßigen Auswertung der KPIs erhalten Sie eine proaktive IT-Landschaft, die Probleme löst, bevor sie Kunden kosten. Beginnen Sie klein mit den wichtigsten fünf Prozessen und skalieren Sie, wenn Sie den Wert erkannt haben.
Passend dazu
- Logistik-Unternehmen senkt Ausfallzeiten durch predictive Monitoring um 40 Prozent
- IT-Beratung & IT-Strategie
- Automatisierte NIS2-Readiness-Prüfung senkt Audit-Zeit für mittelständische Logistikfirma in München um 40 Prozent
- IT-Monitoring & Observability
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- Azure DevOps vs. GitHub Actions: CI/CD-Automatisierung für IT-Dienstleister