Ausgangslage: Die Blindheit im Lager
Der Kunde ist ein spezialisierter 3PL-Anbieter (Third-Party Logistics) mit Sitz in Südengland, der sich auf das E-Commerce-Fulfillment konzentriert. Mit 85 Mitarbeitern im operativen Betrieb stand das Unternehmen vor einem klassischen Skalierungsproblem: Das bestehende Lagerverwaltungssystem (WMS) war funktional solide, aber technologisch veraltet in seiner Datenbereitstellung. Die Daten flossen nicht in Echtzeit, sondern nur in stundenlangen Batch-Reports. Für die Disponenten bedeutete dies, dass sie auf veralteten Excel-Dateien arbeiteten, die oft Stunden alt waren, bevor sie die nächste Kommissionierung starteten.
Diese mangelnde Echtzeit-Sichtbarkeit auf die Lagerbestände führte zu einem Teufelskreis. Fehlbuchungen wurden erst bemerkt, wenn die Sendung bereits im Transport war. Verzögerte Kommissionierungen waren die Regel, nicht die Ausnahme. Die Reaktionszeit auf Last-Minute-Aufträge, die im E-Commerce-Bereich immer häufiger vorkommen, lag bei über vier Stunden. In einem Markt, in dem “Same-Day-Delivery” zum Standard wird, ist das ein existenzielles Risiko.
Die interne IT-Abteilung bestand aus nur zwei Personen. Diese waren mit dem Betrieb der bestehenden Infrastruktur so ausgelastet, dass keine Kapazitäten für Custom-Development oder tiefgreifende Optimierungen der WMS-Anbindung vorhanden waren. Die Konsequenzen waren messbar: 12 % der Sendungen wurden verspätet ausgeliefert. Gleichzeitig stieg der Support-Aufwand, da Kundenanfragen zu nicht ankommen oder verzögerten Lieferungen zunahmen. Das Unternehmen stand an einem Punkt, an dem organisches Wachstum durch manuelle Prozesse und veraltete Technologie begrenzt war.
Herausforderungen: Datenqualität und Akzeptanz
Bevor wir mit der Entwicklung begannen, identifizierten wir drei konkrete Herausforderungen, die das Projekt gefährdet hätten, wenn sie nicht adressiert worden wären.
Erstens war die Datenqualität der WMS-API ein großes Risiko. Die API lieferte nicht immer konsistente Datenstrukturen. Manchmal fehlten Felder, manchmal waren Zeitstempel inkonsistent. Ein naives Dashboard hätte diese Fehler direkt an die User weitergereicht und das Vertrauen in das System zerstört. Zweitens stand die Akzeptanz durch die Lagerfachkräfte im Raum. Mitarbeiter, die jahrelang mit Excel und Papierkram gearbeitet hatten, waren anfänglich skeptisch gegenüber einem neuen Tool, das sie als zusätzliche Kontrolle oder Überwachung interpretieren könnten. Drittens musste die Latenz minimiert werden. Die bestehende Batch-Prozessierung war zu langsam. Wir mussten eine Architektur finden, die eine Synchronisation in Sekunden statt Stunden ermöglicht, ohne den bestehenden WMS unter Last zu bringen.
Der Tech-Stack
Um diese Herausforderungen zu lösen, wählten wir einen schlanken, modernen Stack, der auf Stabilität und Entwicklerproduktivität ausgelegt ist:
- React: Für die responsive und performante Benutzeroberfläche des Dashboards, die auch auf Tablets im Lager nutzbar ist.
- TypeScript: Um Typfehler in der komplexen Datenverarbeitung zu minimieren und die Codebasis wartbar zu halten.
- Node.js: Als Middleware-Schicht, die die Kommunikation zwischen dem WMS-API und dem Frontend orchestriert und die Daten normalisiert.
- PostgreSQL: Als persistentes Datenlager für aggregierte Metriken, Historie und Konfigurationsdaten des Dashboards.
Umsetzung: Vom Batch-Report zum Echtzeit-Stream
Die Entwicklung erfolgte agil in drei Sprints über einen Zeitraum von acht Wochen. Der Fokus lag nicht nur auf der Ästhetik des Dashboards, sondern primär auf der Latenzreduktion und der Zuverlässigkeit der Datenpfeiler.
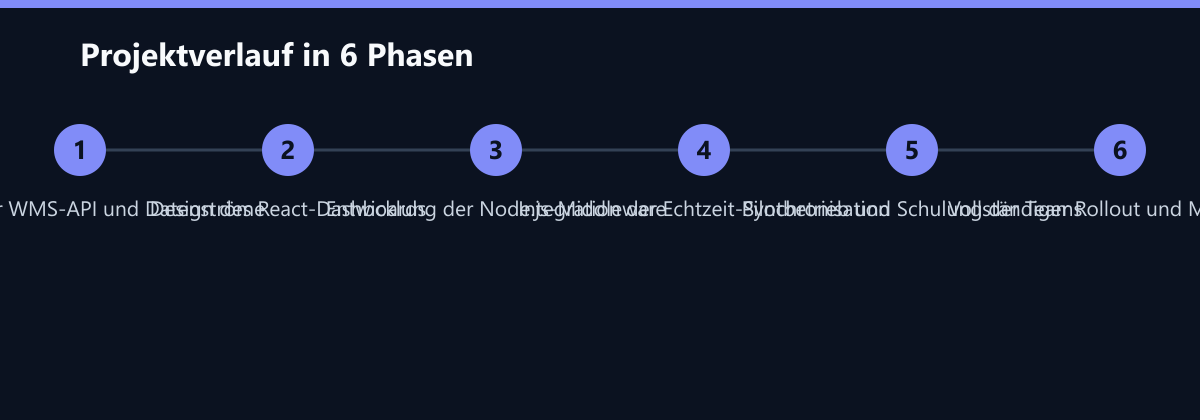
Im ersten Sprint konzentrierten wir uns auf die API-Anbindung. Wir analysierten die Endpunkte des WMS-API und entwickelten die Node.js-Middleware. Diese Middleware fungierte als Puffer und Filter. Sie nahm die rohen Datenströme entgegen, validierte sie gegen ein Schema und normalisierte sie. Statt die Daten direkt an das Frontend zu geben, wurden sie in einem In-Memory-Cache zwischengespeichert. Dies ermöglichte es, die Last auf das WMS zu glätten und gleichzeitig schnelle Reads für das Dashboard zu ermöglichen. Die Synchronisationsfrequenz wurde auf 30 Sekunden festgelegt. Das war ein Kompromiss zwischen der Last für das WMS und dem Bedarf der Disponenten an aktuellen Daten. Jüngere Updates wären technisch möglich gewesen, hätten aber die Stabilität des Gesamtsystems gefährdet.
Im zweiten Sprint entwarfen wir das UI-Design. Hier war die Einbindung der Lagerfachkräfte entscheidend. Wir führten Workshops durch, in denen wir die Arbeitsabläufe der Disponenten nachstellten. Das Ergebnis war ein Dashboard, das nicht überladen war, sondern die kritischen Informationen – Bestandslevel, offene Kommissionierungen, kritische Alerts – prominent anzeigte. Die Kommissionierungs-Priorisierung wurde als visuelle Heatmap implementiert, die zeigte, welche Aufträge die höchste Dringlichkeit hatten. Im dritten Sprint implementierten wir die Automatisierungslogik. Hier wurde die Packlisten-Generierung automatisiert. Sobald ein Auftrag im WMS bestätigt wurde, generierte das System automatisch die Packliste und druckte sie über die lokalen Drucker im Lager. Zudem setzten wir ein Alert-System für kritische Bestände um. Wenn der Bestand eines SKUs unter einen definierten Schwellenwert fiel, wurde ein sofortiger Push-Notification an die zuständigen Disponenten gesendet.
Wie wir die Zahlen messen
Um die Erfolge objektiv zu belegen, haben wir einen messbaren Rahmen vor und nach der Implementierung definiert. Die Lagerumschlagsrate wurde über den Vergleich der täglich kommissionierten Einheiten pro Quadratmeter Lagerfläche gemessen. Als Basis dienten die WMS-Logs der letzten 90 Tage vor der Implementierung. Die Reaktionszeit wurde definiert als die Zeitspanne von der Auftragsbestätigung im System bis zum Start der physischen Kommissionierung. Diese Daten wurden durch Zeitstempel im WMS und im neuen Dashboard erfasst. Die Fehlerquote basierte auf der Anzahl der Fehlbuchungen, die durch Rücksendungen oder Korrekturen nach der Auslieferung ermittelt wurden. Diese Daten wurden aus dem Support-Ticket-System des Kunden extrahiert und mit den WMS-Korrektur-Logs abgeglichen. Alle Messungen wurden über einen Zeitraum von drei Monaten nach dem Go-Live durchgeführt, um saisonale Schwankungen auszuschließen.
Ergebnis: Messbare Effizienzgewinne
Die Einführung des React-Dashboards und der begleitenden Automatisierungen hatte einen unmittelbaren und positiven Effekt auf die KPIs des Unternehmens. Die Disponenten arbeiteten nun auf Basis aktueller Daten. Die Unsicherheit, ob eine Kommissionierung mit den aktuellen Beständen möglich war, verschwand. Die manuelle Nacharbeit, bei der Fehler in Excel-Dateien korrigiert und Packlisten manuell erstellt wurden, wurde nahezu vollständig eliminiert.
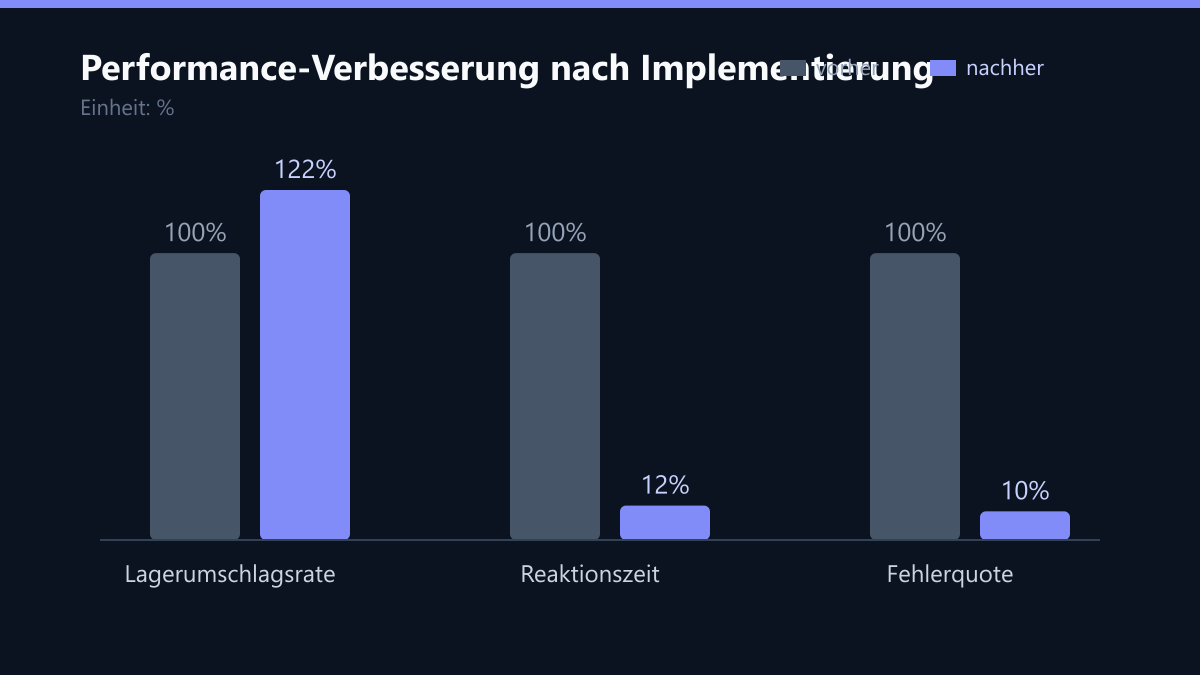
Die konkreten Zahlen sprechen eine klare Sprache. Die Lagerumschlagsrate stieg um 22 %. Das bedeutet, dass das Team in der gleichen Fläche und Zeit 22 % mehr Volumen bewegen konnte. Die Reaktionszeit auf Last-Minute-Aufträge wurde von über vier Stunden auf 45 Minuten reduziert. Das ist eine Reduktion von 88 %. Diese Geschwindigkeit ermöglichte es dem Kunden, neue Service-Level-Agreements (SLAs) mit seinen Endkunden zu unterzeichnen, die vorher nicht machbar waren. Die Fehlerquote sank um 90 %. Fehlbuchungen, die früher zu teuren Rücksendungen führten, wurden durch die Echtzeit-Validierung und die automatisierte Packlisten-Generierung fast vollständig beseitigt. Der ROI war ebenfalls beeindruckend: Die Entwicklungskosten amortisierten sich innerhalb von fünf Monaten, primär durch die reduzierten Personalkosten für die manuelle Nacharbeit und die geringeren Kosten für Fehllieferungen.
Was wir heute anders machen würden
Trotz des erfolgreichen Ergebnisses gibt es aus der Retrospektive zwei Punkte, die wir in zukünftigen Projekten anders angehen würden. Erstens hätten wir die Datenqualität der WMS-API noch früher und intensiver in der Design-Phase adressiert. Wir haben erst während der Entwicklung festgestellt, wie inkonsistent die Daten waren. Heute würden wir einen separaten Sprint für die Datenanalyse und die Definition robuster Fallback-Logiken vorsehen, bevor das erste UI-Element gebaut wird. Zweitens hätten wir die Schulung der Mitarbeiter stärker in den Sprints integriert, statt sie als separaten Schritt nach dem Go-Live zu behandeln. Die Akzeptanz war zwar hoch, aber es gab eine Lernkurve. Eine engere Einbindung der Lagerfachkräfte bereits im Design-Phase, wie wir sie teilweise hatten, hätte die Adoption noch schneller vorangetrieben und mögliche Missverständnisse über die Funktionsweise des Tools früher klären können.
Learnings: Menschen und Technologie im Einklang
Das wichtigste Learning aus diesem Projekt ist, dass Technologie nicht um ihrer selbst willen eingeführt werden sollte. Das Dashboard wurde von den Mitarbeitern schnell akzeptiert, weil es ihren Arbeitsalltag vereinfachte, statt ihn zu kontrollieren. Es gab ihnen die Werkzeuge, um ihre Arbeit schneller und fehlerfreier zu machen. Die transparente Darstellung der Daten schuf Vertrauen. Wir empfehlen für zukünftige Projekte eine enge Einbindung der operativen Fachkräfte bereits im Design-Phase. Sie wissen am besten, wo die Reibungspunkte liegen. Zudem zeigte sich, dass eine schlanke Middleware-Schicht oft der Schlüssel zu stabiler Echtzeit-Integration ist, wenn das Legacy-System (in diesem Fall das WMS) nicht anpassbar ist. Die Investition in eine robuste Datennormalisierung zahlt sich in der Stabilität des Gesamtsystems mehrfach aus. Für Unternehmen im Logistik- und E-Commerce-Sektor, die noch mit Batch-Reports arbeiten, ist der Weg zu Echtzeit-Daten oft kürzer und kostengünstiger als angenommen, wenn man den Fokus auf die richtigen KPIs und eine nutzerzentrierte Lösung legt.
Passend dazu
- Cloud-Kosten senken: 20 % Einsparung durch Infrastruktur-Monitoring
- IT-Beratung & IT-Strategie
- KI-Beratung & KI-Strategie
- Firewall-Regelwerk aufräumen: Wie Sie Latenzen senken und Angriffsfläche reduzieren
- Helpdesk-KPIs im Mittelstand: Reaktionszeit und Zufriedenheit messbar verbessern
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- E-Commerce Entwicklung
- Reaktionszeit auf kritische Sicherheitsvorfälle auf unter 15 Minuten senken
- Handelskonzern reduziert Reaktionszeit auf Server-Fehler auf 15 Minuten
- IT-Downtime um 42 Prozent senken
- Serverkosten um 40 Prozent senken: Magento 2 Migration auf Adobe Cloud
- Workflow-Automatisierung in der Buchhaltung: 5 Prozesse, die sich sofort automatisieren lassen
- Retail-Kette Berlin: Zentralisiertes Monitoring verkürzt Reaktionszeit auf 15 Minuten
- React-Native-App für die Baubranche: 25 % weniger Planungsfehler durch Echtzeit-Sync
- Künstliche Intelligenz im Kundenservice: 60 % schnellere Antwortzeiten im britischen Einzelhandel
- Automatisierung von IT-Compliance-Audits: Manuellen Aufwand um 60 Prozent senken
- Logistik: Phishing-Automatisierung mit KI-SOC für einen US-3PL-Anbieter
- European Manufacturing Group: Unifying IT Support Across 12 Sites with a Single Global MSP Dashboard
- Halluzinationsrate senken: RAG-Architekturen für verlässliche interne KI-Assistenten
- 5 Critical Metrics Every CFO Should Track in Their IT Monitoring Dashboard
- Cybersecurity Essentials für MSP-Kunden: Was Ihr Anbieter abdecken muss