Warum Cloud-Abrechnungen im Mittelstand oft zu hoch ausfallen
Viele Unternehmen zahlen für Rechenleistung, die sie schlicht nicht nutzen. Dieses Phänomen liegt selten an böswilliger Absicht der Anbieter oder an technischen Mängeln, sondern an einer fundamentalen mangelnden Sichtbarkeit. Ohne detaillierte Nutzungsdaten wächst die Cloud-Infrastruktur oft ungeplant weiter. Neue Instanzen werden für Projekte spin-up, aber nie wieder heruntergefahren. Sicherheitspuffer werden immer weiter erhöht, ohne dass die tatsächliche Last steigt. Die Folge sind hohe Fixkosten für unterausgelastete Server, die im Hintergrund weiterlaufen, obwohl sie 80 % der Zeit nichts tun.
Infrastruktur-Monitoring liefert die entscheidende Datenbasis, um diese Verschwendung sichtbar zu machen. Es geht hier nicht um Micro-Optimierung im Cent-Bereich, sondern um die Identifikation großer Hebel. Wer seine Kosten nicht versteht, kann sie auch nicht senken. Der erste Schritt zur Kostensenkung ist daher immer die vollständige Transparenz über die Ressourcennutzung. Nur wer weiß, welche Instanz wie viel CPU, RAM und Storage verbraucht, kann fundierte Entscheidungen treffen. Viele IT-Verantwortliche sind überrascht, wie stark die Abweichung zwischen der konfigurierten Kapazität und der tatsächlichen Auslastung ausfällt.
Die drei großen Kostentreiber identifizieren
Um die angestrebte 20-prozentige Einsparung zu erreichen, müssen Sie drei spezifische Problemstellen ansprechen. In unseren Analysen machen diese drei Kategorien in der Regel den Großteil der unnötigen Ausgaben aus. Wenn Sie diese Hebel ziehen, erzielen Sie die größten Effekte mit dem geringsten Aufwand.
- Überdimensionierung: Server mit zu viel CPU oder RAM, die im Durchschnitt unter 20 % ausgelastet sind. Entwickler neigen dazu, bei der Neukonfiguration großzügig zu kalkulieren. Die Folge ist, dass Sie für Spitzenlasten zahlen, die nur einmal im Monat auftreten, während die Basislast deutlich niedriger ist.
- Zombie-Instanzen: Testsysteme, alte Backups oder Entwicklungsumgebungen, die nie heruntergefahren wurden. Diese „verwaisten“ Ressourcen sind oft schwer zuordenbar, da keine klare Abteilung oder ein Projekt mehr damit assoziiert wird. Sie laufen weiter, weil niemand weiß, ob sie noch benötigt werden.
- Ineffiziente Storage-Klassen: Hochwertiger, teurer Storage für Daten, die selten gelesen werden. Standard-SSDs oder Hochleistungs-Blöcke sind ideal für aktive Datenbanken. Für Logs, Archive oder kalte Backups sind sie jedoch unnötig teuer. Hier liegt enormes Einsparpotenzial in günstigeren Archiv-Speichermedien.
Monitoring-Tools zeichnen die Auslastung über einen Zeitraum von 30 bis 90 Tagen auf. So erkennen Sie Muster, die bei einer manuellen Prüfung oder einem Blick auf das Dashboard zum aktuellen Zeitpunkt unsichtbar bleiben. Sie sehen nicht nur den Durchschnitt, sondern auch die Spitzenlasten und die Leerlaufzeiten.
Von Rohdaten zu handlungsrelevanten Insights
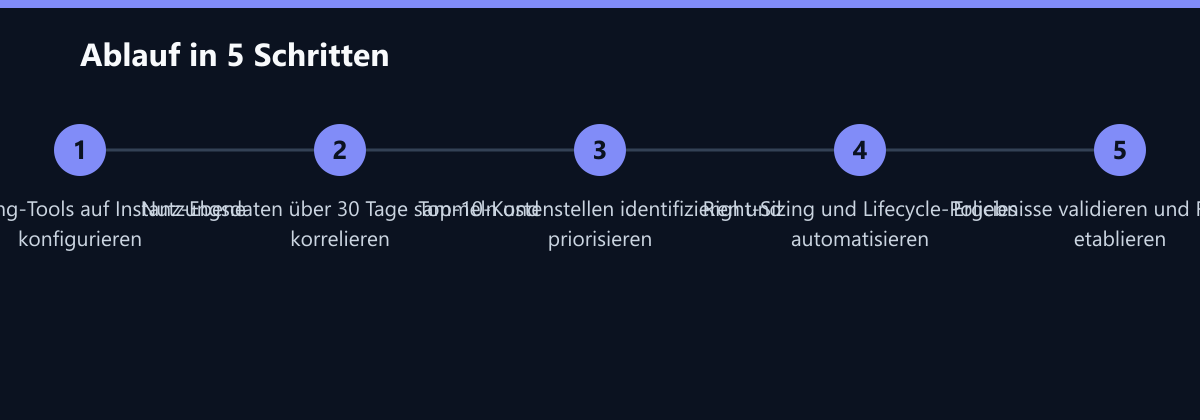
Rohdaten allein nützen nichts. Ein Stack von Grafiken mit CPU-Auslastung pro Instanz ist für die meisten IT-Manager unübersichtlich. Die Daten müssen in konkrete Handlungsempfehlungen übersetzt werden. Ein effektiver Prozess besteht aus drei Schritten, die Sie in Ihre bestehende Routine integrieren können.
Erstens die Datensammlung: Erfassen Sie CPU, RAM, IOPS und Netzwerk-Traffic auf Instanz-Ebene. Achten Sie darauf, dass die Daten nicht nur aggregiert, sondern pro Ressource verfügbar sind. Zweitens die Korrelation: Zuordnung der Kosten zu einzelnen Abteilungen, Projekten oder Kostenstellen (Showback/Chargeback). Nur wenn die Marketing-Abteilung sieht, wie viel ihr Test-Cluster kostet, entsteht der Druck, diesen zu optimieren. Drittens die Empfehlung: Generieren Sie automatische Vorschläge zur Herunterstufung oder Deaktivierung. Moderne Tools können Ihnen sagen: „Instanz X hat im letzten Monat eine durchschnittliche CPU-Auslastung von 15 % gehabt. Eine Herunterstufung um eine Größe würde 200 € pro Monat sparen und die Verfügbarkeit nicht gefährden.“
Wichtig: Die Daten müssen granular genug sein, um Entscheidungen zu rechtfertigen. Ein Dashboard, das nur die Gesamtkosten des Cloud-Kontos zeigt, ist für die Optimierung wertlos. Sie benötigen die Tiefe, um den Finger auf die konkrete Ressource legen zu können, die Geld verbrennt.
Praktische Massnahmen zur Kostensenkung
Basierend auf den Monitoring-Daten können Sie folgende Massnahmen umsetzen. Diese sind in der Regel schnell umsetzbar und tragen ein niedriges Risiko. Beginnen Sie mit den Maßnahmen, die die größte Wirkung haben und die am einfachsten zu automatisieren sind.
- Right-Sizing: Passen Sie die Instanzgröße an den tatsächlichen Spitzenbedarf an. Wenn Ihre Anwendung im Spitzenfall 4 vCPU benötigt, aber standardmäßig mit 8 vCPU läuft, ist die Herunterstufung auf 4 vCPU der erste Schritt. Prüfen Sie dabei immer auch den RAM-Verbrauch, um OOM-Kills (Out-of-Memory) zu vermeiden.
- Automatisches Skalieren: Nutzen Sie Auto-Scaling-Gruppen, um Lastspitzen zu absorbieren, ohne dauerhaft hohe Kapazitäten zu halten. So zahlen Sie nur dann für die volle Leistung, wenn sie tatsächlich benötigt wird. In der Nacht oder am Wochenende skaliert die Gruppe auf ein Minimum herunter.
- Lifecycle-Management: Schalten Sie Nicht-Produktions-Systeme automatisch am Wochenende oder nach Feierabend ab. Viele Test- und Entwicklungsumgebungen laufen 24/7, obwohl sie nur während der Arbeitszeiten genutzt werden. Eine einfache Scheduler-Automatisierung kann hier sofort 50–70 % der Kosten für diese spezifischen Instanzen einsparen.
- Storage-Tiering: Verschieben Sie alte Daten auf günstigere Archiv-Speichermedien. Konfigurieren Sie Lifecycle-Policies, die Daten nach 30, 60 oder 90 Tagen automatisch in eine günstigere Storage-Klasse verschieben. Dies ist besonders bei Log-Dateien und Backups effektiv.
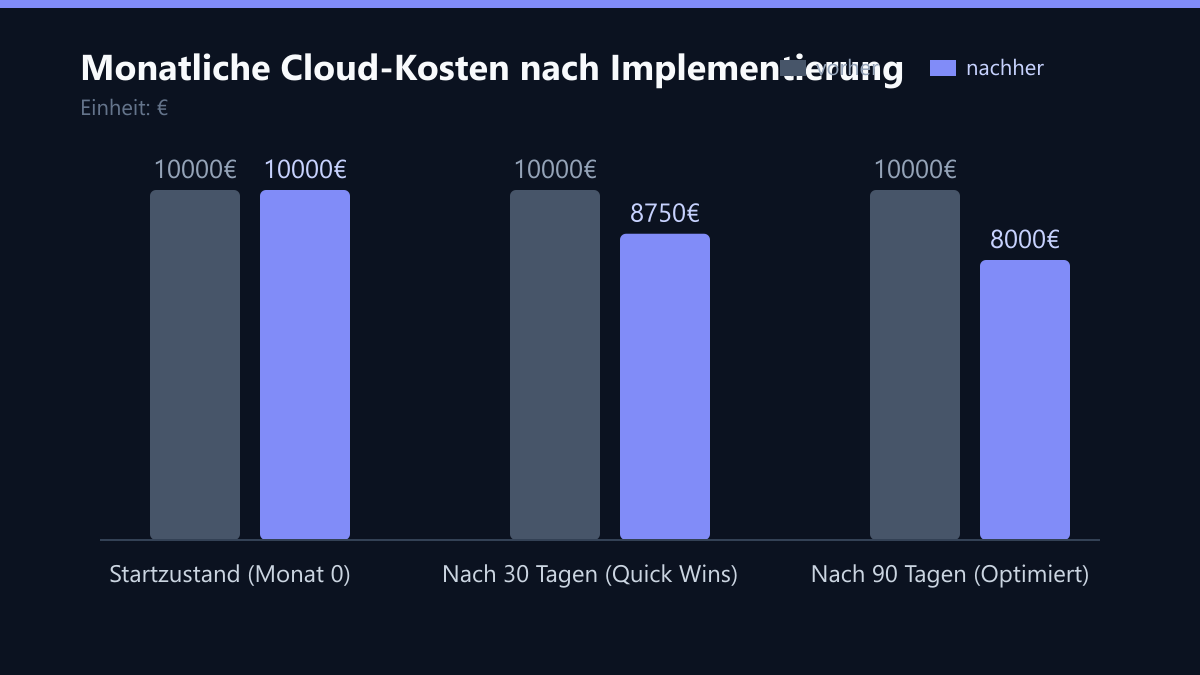
Diese Massnahmen führen oft zu einer sofortigen Reduktion der monatlichen Rechnung um 10 bis 15 %. In Kombination mit der Beseitigung von Zombie-Instanzen ist die Marke von 20 % realistisch erreichbar.
Typische Fehler bei der Cloud-Kostenoptimierung
Trotz der klaren Hebel scheitern viele Optimierungsprojekte an typischen Fehlern. Bewahren Sie diese Punkte im Hinterkopf, um Zeit und Nerven zu sparen.
- Fehlende Kommunikation mit den Entwicklern: Wenn Sie Server herunterskalieren, ohne die Entwickler zu informieren, kommt es zu Störungen und Widerstand. Einhergehend mit dem Monitoring sollte ein klarer Kommunikationsprozess stehen. Erklären Sie, warum die Maßnahme nötig ist und wie die Performance geschützt bleibt.
- Optimierung nur auf Basis des Durchschnitts: Wer nur die durchschnittliche Auslastung betrachtet, übersieht die Spitzenlast. Wenn Sie eine Instanz herunterskalieren, die im Schnitt 15 % ausgelastet ist, aber an einem bestimmten Tag im Monat 95 % benötigt, wird die Anwendung an diesem Tag abstürzen. Analysieren Sie immer auch die 95. und 99. Perzentile.
- Ignorieren von Netzwerk-Kosten: Viele Unternehmen optimieren die Compute-Kosten, vergessen aber die Datenübertragung. Wenn Daten zwischen verschiedenen Regionen oder Availability Zones übertragen werden, können die Netzwerk-Kosten die Compute-Kosten übersteigen. Prüfen Sie, ob Ihre Architektur unnötige Datenströme erzeugt.
- Einmalige Aktion statt Prozess: Wenn Sie die Kosten einmal optimiert haben und dann das Monitoring einstellen, wachsen die Kosten wieder. Die Infrastruktur ist dynamisch. Neue Features, mehr Nutzer oder geänderte Workloads verändern den Ressourcenbedarf. Ohne kontinuierliche Überwachung ist die Einsparung ein Einmaleffekt.
So messen Sie den Erfolg
Ohne messbare Kennzahlen bleibt die Kostensenkung ein Bauchgefühl. Definieren Sie klare KPIs, um den Erfolg Ihres Monitoring- und Optimierungsprojekts zu quantifizieren. Diese Kennzahlen sollten Sie monatlich im Management-Reporting präsentieren.
- Spend-Per-Resource-Ratio: Verhältnis der ausgegebenen Kosten zur tatsächlichen genutzten Leistung. Ziel: Steigerung der Effizienz um 20 % innerhalb von 90 Tagen.
- Zombie-Instance-Rate: Prozentuale Anzahl der Instanzen, die länger als 30 Tage keine relevante Aktivität zeigen. Ziel: Reduktion auf unter 5 % der Gesamtinstanzen.
- Cost-Savings-Per-Month: Absolute Einsparung in Euro im Vergleich zum Baseline-Monat (Monat 0). Ziel: Stabilisierung bei mindestens 20 % unter dem Baseline-Wert.
- Alert-Accuracy: Wie viele der generierten Optimierungsvorschläge wurden tatsächlich umgesetzt? Dies misst die Qualität Ihrer Monitoring-Regeln und die Akzeptanz im Team.
Messen Sie diese Werte über einen Zeitraum von mindestens drei Monaten. So können Sie kurzfristige Schwankungen von strukturellen Verbesserungen trennen. Dokumentieren Sie auch die geschätzte Zeitersparnis für das IT-Team, die durch die Automatisierung entsteht. Das ist ein oft unterschätzter Benefit, der die Investition in Monitoring-Tools zusätzlich rechtfertigt.
Checkliste für den Start
Nutzen Sie diese Checkliste, um Ihr Projekt strukturiert anzugehen:
- Baseline der aktuellen Cloud-Kosten dokumentieren (Monat 0).
- Monitoring-Tools auf alle kritischen Instanzen und Storage-Volumes anwenden.
- Tags und Metadaten für die Zuordnung zu Kostenstellen sicherstellen.
- 30 Tage Daten sammeln und erste Auswertungen durchführen.
- Top-10-Kostenstellen identifizieren und mit den Verantwortlichen besprechen.
- Automatische Lifecycle-Policies für Nicht-Produktionssysteme einrichten.
- Erste Right-Sizing-Maßnahmen an den am meisten überdimensionierten Instanzen umsetzen.
- Ergebnisse nach 30 Tagen messen und berichten.
Kontinuierliche Optimierung statt Einmaleffekt
Cloud-Infrastrukturen sind dynamisch. Was heute optimal dimensioniert ist, kann morgen überdimensioniert sein, wenn sich die Anforderungen ändern. Neue Produkte, saisonale Schwankungen oder veränderte Nutzerzahlen beeinflussen den Ressourcenbedarf. Deshalb ist eine kontinuierliche Überwachung essenziell.
Setzen Sie sich ein Ziel: Die monatliche Überprüfung der Top-10-Kostenstellen. So verhindern Sie, dass sich Ineffizienzen erneut einschleichen. IT-Verantwortliche sollten diese Kennzahlen in ihren regulären Reporting-Zyklus integrieren. Machen Sie die Cloud-Kosten zu einem festen Agenda-Punkt im IT-Management. Nur wenn die Kosten regelmäßig thematisiert werden, bleibt die Sensibilität für Effizienz hoch.
Langfristig führt diese Disziplin zu einer stabilen Kostenbasis. Sie wissen genau, wofür Sie zahlen, und können Budgets realistisch planen. Sie entwickeln von einem reaktiven Kostenzahler zu einem proaktiven Kostenmanager. Das Monitoring wird zum Werkzeug der strategischen Steuerung, nicht nur zur technischen Überwachung. In einem Wettbewerbsumfeld, in dem Margen eng sind, kann diese 20-prozentige Einsparung den Unterschied zwischen Gewinn und Verlust ausmachen. Investieren Sie in die Sichtbarkeit, um die Kontrolle zurückzugewinnen.
Passend dazu
- Cloud Services & Cloud-Migration
- IT-Monitoring & Observability
- Netzwerk & Netzwerk-Infrastruktur
- Full-Stack-Observability: So finden Sie Bottlenecks in der Cloud-Infrastruktur
- IT-Budget planen: Versteckte Kosten in Cloud und Software identifizieren
- Log-Management im Mittelstand: So senkt zentralisiertes Monitoring Compliance-Kosten
- Microsoft 365 Kosten senken: Lizenzoptimierung und Power User Strategien
- From Alerts to Actions: Building a Zero-Noise Monitoring Strategy for IT Managers
- Open-Source Monitoring Stack: Effiziente Observability mit Prometheus und Loki
- Warum Ihr aktuelles IT-Monitoring nicht ausreicht: Die Lücke zwischen Uptime und User Experience
- Kubernetes Monitoring in der Produktion: Stabilität und Kostenkontrolle
- Digitale Transformation im US-Gesundheitswesen: 50 % schnellere Datenanalyse durch Cloud-Infrastruktur
- Halluzinationsrate senken: RAG-Architekturen für verlässliche interne KI-Assistenten
- HIPAA-konformes Monitoring für Patient-Portale
- Cloud Security Kosten um 40 Prozent senken durch automatische Azure Policy Enforcement
- Monitoring KPIs für CIOs: Die 5 Metriken, die Umsatz und SLA bestimmen
- Die Kosten von Inaktivität: Quantifizierung des Geschäftsrisikos bei KI-Verzicht
- Datengrundlage für KI: 5 Schritte zu sauberen Legacy-Daten
- MSSP-Vertrag verhandeln: 7 Klauseln zum Schutz Ihrer Daten
- 5 Critical Metrics Every CFO Should Track in Their IT Monitoring Dashboard
- Netzwerk-Infrastruktur auf KI-Workloads vorbereiten
- Hot Desking vs. Fixed Seats: Einfluss auf Wi-Fi Dichte und IT-Kosten
- Robuste Daten-Synchronisation zwischen Magento und ERP aufbauen
- IT-Helpdesk-Tickets um 30 % senken durch gezieltes User-Empowerment
- Prometheus vs Grafana Stack: Self-Hosted Monitoring statt SaaS-Kosten
- Falsch-positive Monitoring-Alerts reduzieren: Eine praktische Strategie
- MSP-Verträge verhandeln: Kosten senken ohne SLA-Verlust
- Cloud-Sicherheit: IAM und Verschlüsselung für sensible Daten
- Cloud-Kosten um 30 % senken: Server-Instanzen richtig dimensionieren
- KI-Dokumentverarbeitung: OCR-Genauigkeit und Kosten bei der Rechnungsautomatisierung