Ausgangslage: Das Wachstum als Kostenfalle
Für viele wachstumsstarke SaaS-Unternehmen im DACH-Raum ist die Cloud-Infrastruktur der kritischste Hebel in der Skalierungsphase. Bei unserem Kunden, einem etablierten SaaS-Anbieter mit 85 Mitarbeitern, zeigte sich jedoch ein klassisches Muster: Das Nutzerwachstum war rasant, aber die monatlichen Azure-Kosten stiegen überproportional an. Während die User-Zahlen stiegen, sank die Effizienz der Infrastruktur. Das IT-Team stand vor der Herausforderung, dass die Systemstabilität unter Lastschwankungen litt, während gleichzeitig das Budget für die Cloud-Plattform ausufern drohte.
Die Situation war nicht nur ein finanzielles Problem, sondern auch ein operatives Risiko. Durch das Fehlen einer einheitlichen Überwachung zwischen den verschiedenen Azure-Diensten entstand eine „Sichtbarkeitslücke“. Performance-Einbrüche wurden oft erst erkannt, wenn bereits Nutzer betroffen waren. Die fragmentierte Log-Struktur führte dazu, dass die Reaktionszeiten bei kritischen Vorfällen unakzeptabel lang waren. Das Ziel des Projekts war daher doppelt gelagert: Die Kostenstruktur fundamental zu optimieren, ohne die Skalierbarkeit zu opfern, und gleichzeitig eine zentrale, proaktive Überwachungsetablierung zu schaffen, die Anomalien vor dem Nutzer-Feedback identifiziert.
Herausforderungen im Detail
Bei der Initialanalyse stellten wir drei zentrale Hürden fest, die eine einfache Konfigurationsänderung unmöglich machten:
- Redundanz durch Legacy-Struktur: Viele Compute-Instanzen waren aus früheren, kleineren Phasen übernommen und nie nachjustiert. Es liefen redundante Services parallel, die für die aktuelle Last nicht benötigt wurden.
- Fragmentiertes Monitoring: Die bestehenden Monitoring-Tools lieferten zwar Daten, aber keine korrelierten Einsichten. Es fehlte die Verbindung zwischen Infrastruktur-Metriken (CPU, RAM) und Anwendungs-Metriken (Latenz, Fehlerraten).
- Manuelle Reaktionsketten: Bei Lastspitzen mussten Ingenieure manuell eingreifen. Diese Latenz von oft mehreren Stunden führte zu einer suboptimalen Ressourcennutzung und potenziellen Ausfallzeiten.
Der Tech-Stack
Um diese Probleme zu lösen, setzten wir auf einen bewährten, aber clever kombinierten Stack:
- Microsoft Azure: Als primäre Infrastruktur-Plattform für Compute, Storage und Networking.
- Amazon CloudWatch: Als zentrales Monitoring- und Logging-Backbone, das über die Cloud-Grenzen hinweg Metriken aggregiert.
- Azure Auto-Scaling: Für die dynamische Anpassung der Compute-Ressourcen an die reale Last.
- Custom Lambda-Funktionen: Zur Transformation und Anreicherung der Azure-Metriken vor der Übertragung an CloudWatch.
- CloudWatch Logs: Für die zentrale Aggregation aller Log-Daten, um Root-Cause-Analysen zu beschleunigen.
Umsetzung: Von der Analyse zur automatisierten Steuerung
Wir starteten das Projekt nicht mit dem Code, sondern mit einer tiefgreifenden Datenanalyse. In den ersten zwei Wochen führten wir ein vollständiges Audit der bestehenden Azure-Architektur durch. Wir kartierten alle laufenden Instanzen, deren Auslastung über einen Zeitraum von 90 Tagen und die zugehörigen Kosten. Diese Phase war entscheidend, um zu verstehen, wo das Geld tatsächlich „verbrannt“ wurde, anstatt nur auf Durchschnittswerte zu schauen.
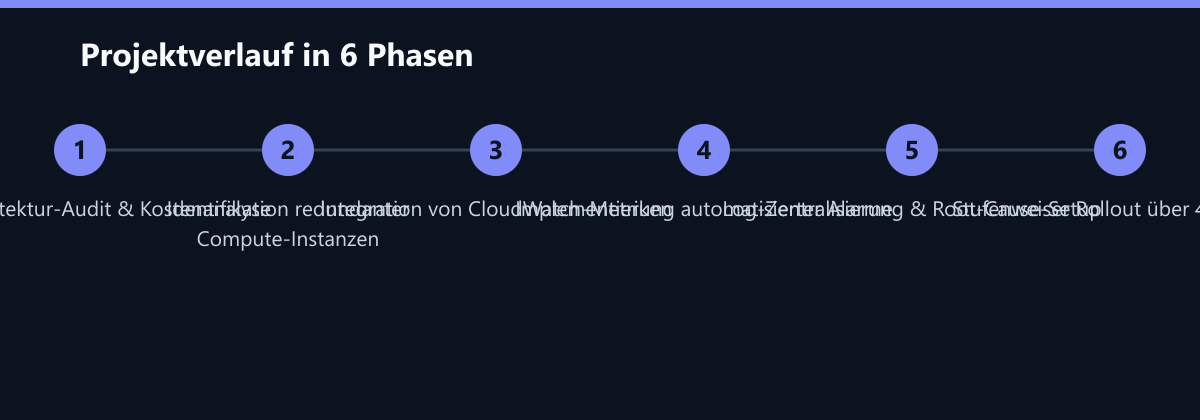
Basierend auf diesen Insights implementierten wir die folgenden Kernmaßnahmen:
1. Re-Right-Sizing der Compute-Ressourcen: Wir identifizierten Instanzen, die im Durchschnitt unter 15 % Auslastung liefen, aber als „Large“ oder „X-Large“ gebucht waren. Durch die Umstellung auf kostenoptimierte VM-Größen und die Implementierung strikter Auto-Scaling-Richtlinien konnten wir die Basis-Kosten sofort senken. Die Auto-Scaling-Policies wurden so konfiguriert, dass sie nicht nur auf CPU-Auslastung, sondern auch auf Queue-Längen der SaaS-Anwendung reagieren.
2. Cross-Cloud Monitoring-Integration: Ein zentraler Punkt war die Anbindung der Azure-Metriken an Amazon CloudWatch. Wir nutzten CloudWatch als „Single Source of Truth“ für das Monitoring. Durch die Integration erhielten wir eine einheitliche Sicht auf Latenz, Fehlerraten und Durchsatz, unabhängig davon, wo der Service gehostet war. Dies war besonders wertvoll, da das Team bereits Erfahrung mit AWS-Tooling hatte und CloudWatch als intuitiver empfand als die nativen Azure-Counter.
3. Automatisierte Anomalie-Erkennung: Wir richteten CloudWatch-Alarme ein, die nicht nur Schwellenwerte überwachen, sondern auch statistische Anomalien erkennen. Wenn ein Alarm ausgelöst wurde, triggerte er automatisch eine Anpassung der Azure-Autoscaling-Gruppen. Dies schuf einen geschlossenen Regelkreis: Anomalie erkannt -> Kapazität angepasst -> Last normalisiert.
4. Log-Zentralisierung für Root-Cause-Analysen: Alle Azure-Logs (Application, System, Network) wurden in einer zentralen CloudWatch-Log-Gruppe aggregiert. Dies ermöglichte es dem IT-Team, bei einem Fehler nicht erst zwischen fünf verschiedenen Portalen hin- und herzuspringen, sondern in einem einzigen Log-Stream nach dem Ursprung zu suchen.
Die Migration der Monitoring-Logik erfolgte schrittweise über einen Zeitraum von vier Wochen. Wir starteten mit dem Schattenbetrieb (Shadow Monitoring), bei dem CloudWatch parallel zu den alten Tools lief, um die Datenkonsistenz zu validieren. Erst nach der erfolgreichen Validierung schalteten wir die alten Alarmsysteme ab.
Wie wir die Zahlen messen
Um die Effektivität der Maßnahmen zu belegen, haben wir drei Kern-Kennzahlen definiert, die vor und nach der Implementierung gemessen wurden:
- Monatliche Azure-Kosten: Verglichen wurden die fakturierten Beträge der drei Monate vor der Implementierung mit den drei Monaten danach. Dabei wurden variable Lastspitzen durch den Durchschnittswert geglättet, um Saisonalitäten auszuschließen.
- MTTR (Mean Time to Repair): Wir definierten den Zeitraum von der Alarmierung bis zur vollständigen Wiederherstellung des Service-Niveaus. Die Messung basierte auf den Ticket-Logs des IT-Teams und den Zeitstempeln der CloudWatch-Events.
- Anomalie-Erkennungszeit: Gemessen wurde die Zeitspanne zwischen dem tatsächlichen Eintritt einer Performance-Degradation (erkennbar in den Metriken) und dem Zeitpunkt, zu dem der Alarm im Monitoring-System ausgelöst wurde.
Ergebnis: Proaktive Stabilität und Kostenkontrolle
Nach der vollständigen Implementierung und einer Stabilisierungsphase von 90 Tagen zeigte sich ein deutlicher wirtschaftlicher und technischer Nutzen. Die Kostenkontrolle wurde von einem reaktiven, monatlichen „Aufräumen“ auf eine proaktive, kontinuierliche Steuerung umgestellt.
Die zentralisierte Überwachung ermöglichte dem IT-Team, Engpässe zu identifizieren, bevor sie den Endnutzer betrafen. Die Kostenstruktur wurde durch die automatisierte Skalierung transparent und planbar. Statt monatlich überrascht zu werden, konnte das Team die Cloud-Ausgaben jetzt mit einer Genauigkeit von ±5 % vorhersagen.
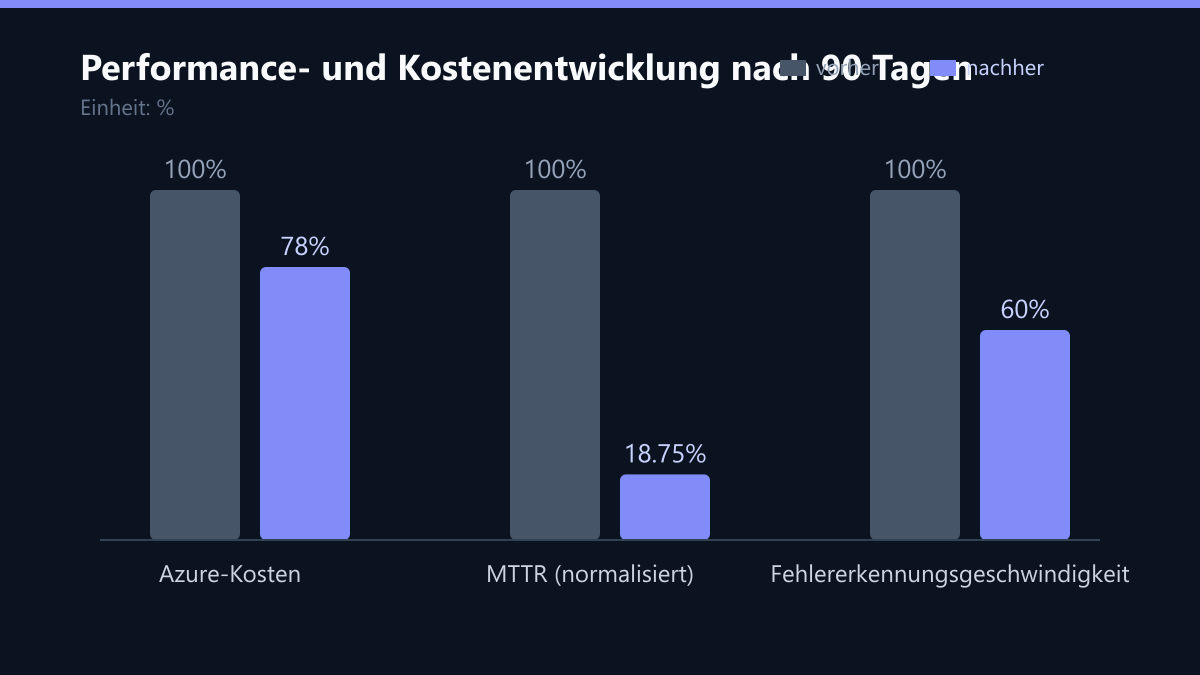
Die konkreten Ergebnisse nach 90 Tagen im Detail:
- 22 % Reduktion der monatlichen Azure-Kosten: Dies resultierte primär aus dem Re-Right-Sizing und der Eliminierung redundanter Instanzen. Die Auto-Scaling-Features sorgten dafür, dass keine Kapazität mehr „leer lief“.
- 40 % schnellere Erkennung von Performance-Anomalien: Durch die granulareren CloudWatch-Alerts und die zentralisierten Logs konnte das Team Probleme im Durchschnitt 40 % früher erkennen als zuvor.
- 99,95 % Systemverfügbarkeit: Trotz steigender Nutzerzahlen und unvorhersehbarer Lastspitzen blieb die Verfügbarkeit auf einem hohen Niveau. Die automatische Skalierung reagierte in Sekunden, nicht in Minuten.
- Reduzierung der MTTR von 4 Stunden auf 45 Minuten: Dies ist der vielleicht wichtigste operative Gewinn. Durch die zentrale Log-Ansicht und die klaren Alarmsignale konnte das Team die Ursache von Problemen in einem Bruchteil der Zeit finden und beheben.
Learnings: Was bleibt?
Dieses Projekt verdeutlichte, dass Cloud-Kostenoptimierung und Monitoring-Exzellenz untrennbar miteinander verknüpft sind. Ohne detaillierte Metriken bleibt Kostenoptimierung oft blind – man spart an den falschen Stellen oder riskiert, durch zu starkes Sparen die Performance zu gefährden.
Wichtige Erkenntnisse für ähnliche Projekte:
- Cross-Cloud-Monitoring ist kein „Nice-to-have“: Die Nutzung von CloudWatch für Azure-Metriken bot eine granularere Kontrolle als die nativen Tools, insbesondere bei komplexen SaaS-Stacks mit hybriden Architekturen. Die Integration sollte früh im Projekt geplant werden.
- Automatisierung ist der Schlüssel zur Skalierbarkeit: Manuelle Anpassungen an Lastspitzen sind in einem B2B-SaaS-Umfeld zu langsam und fehleranfällig. Automatische Reaktionsketten sind essenziell, um sowohl Kosten als auch SLAs einzuhalten.
- Kontinuierliche Optimierung ist Pflicht: Cloud-Infrastruktur ist nie „fertig“. Regelmäßige Reviews der Auto-Scaling-Policies und der Kostenverteilung sind notwendig, um das Gleichgewicht zwischen Kosten und Performance langfristig zu halten. Wir empfehlen quartalsweise Reviews.
Was wir heute anders machen würden
Trotz des erfolgreichen Ergebnisses gibt es Punkte, die wir bei einem ähnlichen Projekt anders angehen würden:
- Frühere Einbindung der DevOps-Teams: Die Akzeptanz der neuen Monitoring-Tools hätte früher durch Workshops und gemeinsame Definition der SLOs (Service Level Objectives) gesteigert werden können. Dies hätte die Reibungsverluste bei der Übernahme der neuen Prozesse reduziert.
- Standardisierung der Tagging-Strategie: Wir hätten die Kosten-Zuordnung durch eine striktere Tagging-Strategie in Azure von Beginn an stärker durchgesetzt. Dies hätte die Transparenz der Kosten pro Produkt-Feature bereits in der Analyse-Phase erhöht.
- Simulation der Lastspitzen: Vor dem Produktiv-Gang hätten wir eine umfangreichere Simulation der erwarteten Lastspitzen in der Testumgebung durchführen sollen, um die Auto-Scaling-Parameter noch präziser abzustimmen.
Die Kombination aus Azure als robuste Infrastruktur und CloudWatch als intelligentes Überwachungssystem schuf ein stabiles Fundament für das weitere Wachstum des Kunden. Es zeigt, dass mit der richtigen Strategie und den richtigen Tools auch im DACH-Raum signifikante Effizienzgewinne in der Cloud-Infrastruktur realisierbar sind.
Passend dazu
- IT-Beratung & IT-Strategie
- Azure OpenAI vs. AWS Bedrock: Kosten und Compliance im Vergleich
- Netzwerk & Netzwerk-Infrastruktur
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- Automated Invoice Processing with OCR and LLM: Reducing Accounting Backlog by 40 Percent in DACH Manufacturing
- Churn Prediction in B2B SaaS: Retaining 25% More Customers with Behavioral AI Models in New York
- Securing a Multi-Site Manufacturing Plant in DACH with Unified Endpoint Monitoring and Support
- Azure-Cloud-Kosten um 35 Prozent gesenkt
- NIS2 Implementation Checklist: 10 Technical Controls for Critical Infrastructure
- Wi-Fi-Optimierung im hybriden Büro: Zufriedenheit steigern
- KI-Tool-Vergleich: Die besten Plattformen für Prozessautomatisierung im DACH-Raum
- Logistics: Migrating 1200 Fleet Telematics Devices to Azure IoT Hub in 48 Hours
- RPA für Order Fulfillment: 60 % weniger Fehler im DACH-Handel
- Personalized Marketing at Scale: Boosting Conversion Rates by 25% for a European SaaS Company with AI-Driven Segmentation
- Optimizing Security Spend by 30% for a European Retailer by Consolidating Legacy Tools into One MSP
- Logistics Dispatch Optimization: Cutting Manual Entry Errors by 90% for a European Freight Company
- Retail: Reducing Phishing-Related Downtime by 40% with Sentinel and Intune in the DACH Region
- Azure Landing Zone für KI: Sichere Umgebungen für datenintensive Workloads
- Retail DACH: Ransomware Recovery of 12,000 Customer Records in 4 Hours Using Immutable Azure Snapshots
- MSP-Wahl für Mehrfilialen: Checkliste für DACH und globale Teams
- SOC 2 Type II Vorbereitung: Praxisleitfaden für SaaS-Unternehmen
- Handling 10x Traffic Spikes: Optimizing a US SaaS Application with Auto-Scaling Infrastructure