Ausgangslage: Der wachsende Engpass in der Buchhaltung
Ein mittelständischer Maschinenbauer mit 150 Mitarbeitern in der DACH-Region stand vor einer wachsenden Herausforderung, die typisch für viele produzierende Unternehmen ist: Die manuelle Erfassung von Lieferantenrechnungen überlastete das Team zunehmend. Der Kern des Problems lag nicht in der Menge an Rechnungen an sich, sondern in der Heterogenität der eingehenden Dokumente. Neben standardisierten PDFs, die relativ leicht zu verarbeiten sind, kamen oft gescannte Papierfaxe, E-Mails mit unstrukturierten Anhängen oder sogar handschriftliche Korrekturen auf alten Formularen an.
Diese Vielfalt an Formaten erforderte einen hohen manuellen Aufwand. Die Buchhaltung verbrachte täglich über drei Stunden mit der reinen Datenerfassung und dem Abgleich der Positionen. Dies führte zu einem Rückstau von durchschnittlich fünf Arbeitstagen bis zur Freigabe der Rechnung. In einer Zeit, in der Liquidität und Cash-Flow-Prognosen entscheidend sind, verzögerte diese Latenzzeit nicht nur die Zahlung an Lieferanten, sondern schuf auch erhebliche Fehlerquellen. Manuelle Tippfehler bei Kontierungen oder Summenabgleich waren kaum vermeidbar, was zu unnötigen Klärungsanfragen und weiteren Verzögerungen führte.
Herausforderungen: Warum klassische Tools nicht ausreichten
Bevor wir mit der Implementierung begannen, mussten wir drei zentrale Herausforderungen identifizieren, die eine einfache Automatisierung schwierig machten. Erstens war die Variabilität der Layouts extrem hoch. Verschiedene Lieferanten nutzten unterschiedliche ERP-Systeme, die Rechnungen in völlig unterschiedlichen Formaten exportierten. Zweitens fehlte oft ein eindeutiger Kontext bei der Zuordnung von Beträgen. Ein Feld, das bei einem Lieferanten „Netto“ hieß, war bei einem anderen „Nettobetrag“ oder einfach nur eine Zahl ohne Beschriftung. Drittens gab es strenge Vorgaben zur Datenintegrität: Keine Rechnung durfte ohne Prüfung im ERP-System landen, da falsche Kontierungen steuerliche und bilanzielle Probleme verursachen könnten.
Der Tech-Stack
Um diese Herausforderungen zu meistern, setzten wir auf einen hybriden Ansatz, der die Stärken zweier Technologien kombiniert:
- OCR-Engine: Eine hochpräzise optische Zeichenerkennung, die speziell für technische Dokumente und gestörte Scans optimiert ist, extrahiert zunächst die Rohdaten (Text und Zahlen) aus den Bildern.
- Large Language Model (LLM): Ein LLM analysiert den semantischen Kontext der extrahierten Daten. Es versteht, dass „Zahlungsziel 30 Tage“ dasselbe bedeutet wie „Zahlung innerhalb von 30 Tagen“, und kann unstrukturierte Felder korrekt zuordnen.
- REST-API Integration: Eine schlankes Middleware-Schicht, die die validierten Daten in Echtzeit an die bestehende Buchhaltungssoftware des Kunden überträgt und bei Abweichungen einen Review-Workflow auslöst.
Umsetzung: Von der Analyse zur Produktivität
Die Implementierung erfolgte in einem agilen Prozess, der die bestehende IT-Infrastruktur des Kunden respektierte und nutzte.
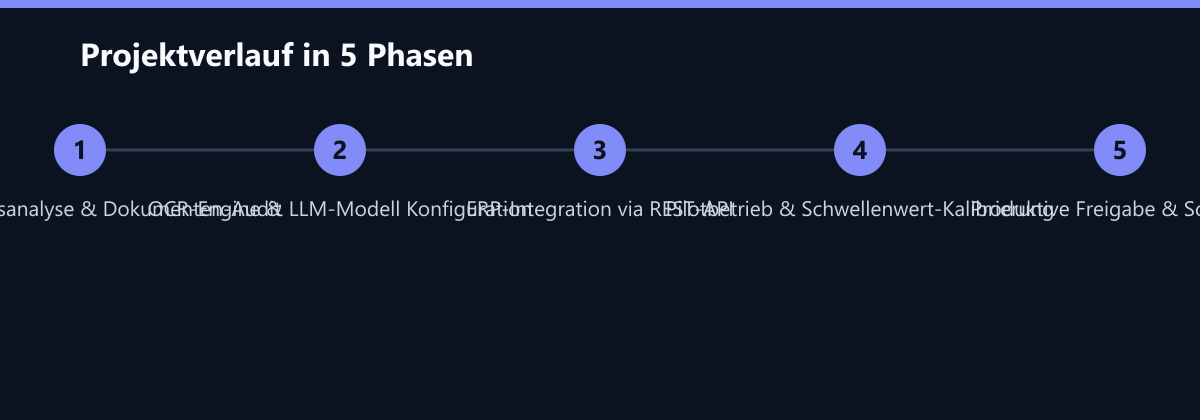
Phase 1: Dokumenten-Audit und Vorverarbeitung (Woche 1-2) Wir sammelten eine repräsentative Auswahl von historischen Rechnungen. Alle eingehenden Rechnungen – ob per E-Mail, Fax oder manueller Upload – werden zentral in einem Dokumenten-Repository gesammelt. Dies schuf eine einheitliche Eingabestufe, unabhängig vom Ursprung des Dokuments.
Phase 2: Extraktions-Logik (Woche 3-4) Hier kam die hybride KI-Lösung zum Tragen. Die OCR-Engine extrahierte zunächst die Rohdaten. Anschließend analysierte das LLM den Kontext. Es lernte, abweichende Layouts zu erkennen und Felder wie „Netto“, „Brutto“ oder „Zahlungsziel“ korrekt zuzuordnen, selbst wenn die Beschriftung fehlte oder unüblich war. Dies war der entscheidende Schritt, um die Genauigkeit zu steigern.
Phase 3: Validierung und Integration (Woche 5-6) Die extrahierten Daten wurden gegen das ERP-System geprüft. Wir definierten harte Schwellenwerte: Bei Abweichungen im Nettopreis von mehr als 5 % oder bei unbekannten Lieferanten wurde automatisch ein manueller Review-Workflow ausgelöst. Die Integration erfolgte über eine REST-API direkt in die Buchhaltungssoftware, wodurch Medienbrüche wie Excel-Exporte eliminiert wurden.
Phase 4: Pilotbetrieb und Feinjustierung (Woche 7-8) Das System lief parallel zum manuellen Prozess. Wir verglichen die Ergebnisse täglich und justierten die LLM-Prompts und OCR-Regeln basierend auf den manuellen Korrekturen. Nach acht Wochen von der Anforderungsanalyse bis zur produktiven Freigabe war das System stabil und bereit für den Vollbetrieb.
Wie wir die Zahlen messen
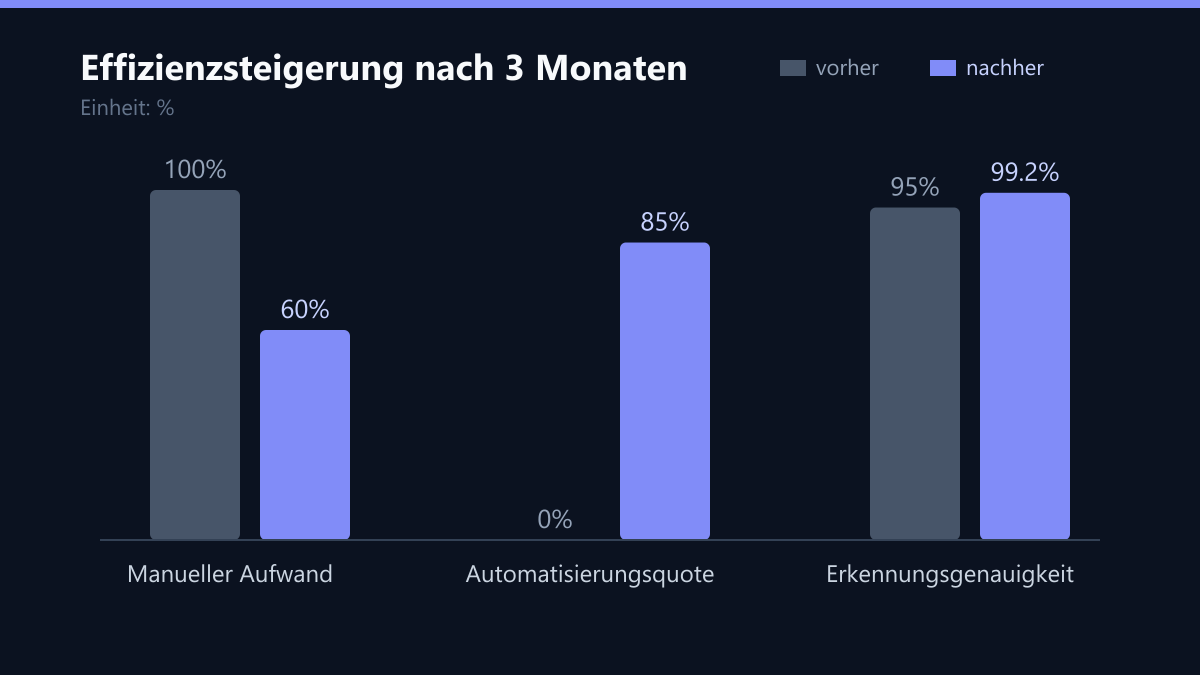
Um die Effektivität der Lösung zu belegen, haben wir einen klaren Messplan definiert, der über drei Monate nach der Einführung lief. Die Kennzahlen wurden nicht geschätzt, sondern direkt aus dem ERP-System und dem Monitoring-Tool der KI-Pipeline extrahiert. Der „Manuelle Aufwand“ wurde gemessen, indem wir die Zeit, die Buchhalter für die Erfassung einer einzelnen Rechnung benötigten, vor und nach der Einführung verglichen. Die „Vollautomatische Verarbeitungsquote“ (85 %) definiert wir als den Anteil der Rechnungen, die ohne menschlichen Eingriff vollständig im ERP-System verbucht wurden. Die „Erkennungsgenauigkeit“ (99,2 %) basiert auf einer Stichprobenprüfung von 500 zufällig ausgewählten Rechnungen, bei der die KI-Ergebnisse manuell gegen das Originaldokument validiert wurden. Diese Methodik stellt sicher, dass die gemessenen Verbesserungen real und reproduzierbar sind.
Ergebnis: Messbare Effizienzsteigerung
Nach der Einführung der automatisierten Pipeline zeigte sich ein sofortiger, messbarer Effekt auf die Effizienz der Buchhaltung. Die Zahlen nach drei Monaten sprechen für sich:
- 40 % Reduktion des manuellen Aufwands pro Rechnung.
- 85 % der Rechnungen werden ohne manuellen Eingriff vollständig verarbeitet.
- Zwei Tage weniger Durchlaufzeit von der Rechnungseingangs bis zur Verbuchung.
- 99,2 % Genauigkeit bei der Datenerkennung.
Das Team konnte sich wieder auf wertschöpfende Tätigkeiten konzentrieren, wie die Kreditorenanalyse, das Verhandeln von Zahlungszielen mit Lieferanten und strategische Reporting-Aufgaben. Die Investition amortisierte sich innerhalb des ersten Quartals durch die eingesparten Personalkosten und die beschleunigte Liquiditätsplanung, die durch den kürzeren Durchlaufzeit ermöglicht wurde.
Was wir heute anders machen würden
Rückblickend gibt es zwei Punkte, die wir in zukünftigen Projekten noch stärker in den Fokus rücken würden. Erstens: Die Datenaufbereitung der Eingangsdaten. Wir hätten früher und intensiver mit den Lieferanten kommuniziert, um standardisierte E-Mail-Adressen und Betreffzeilen zu etablieren. Die Qualität der Eingangsdaten beeinflusst die Erkennungsrate massiv, und je sauberer die Quelle, desto höher die Autonomie der KI. Zweitens: Die Schulung der Mitarbeiter. Die Akzeptanz im Team war anfangs gemischt, da viele befürchteten, ihre Arbeit zu verlieren. Heute würden wir die Mitarbeiter früher als „KI-Trainer“ einbinden und sie darauf vorbereiten, dass ihre Rolle sich von der Erfassung zur Prüfung und Optimierung verschiebt. Dies hätte den Widerstand im Team reduziert und die Feedback-Schleifen während des Pilotbetriebs beschleunigt.
Learnings: Schlüssel für robuste Automatisierung
Die Kombination aus OCR und LLM ist der Schlüssel für robuste Automatisierung im Mittelstand. Reine OCR scheitert oft an abweichenden Formaten und kann keinen Kontext verstehen. LLMs verstehen Kontext hervorragend, können aber nicht zuverlässig Zahlen aus Bildern lesen oder sind in der Lage, pixelgenaue Positionen zu bestimmen. Die Kombination beider Technologien ist essenziell, um beide Schwächen auszugleichen.
Ein weiterer wichtiger Aspekt ist der „Mensch im Loop“. Eine vollständige Automatisierung ist selten sinnvoll und oft riskant. Ein klar definierter Review-Prozess für Ausreißer schafft Vertrauen im Team und minimiert Fehler. Das System muss lernen, wann es unsicher ist und den Ball an den Menschen weitergeben. Schließlich zeigt dieses Projekt, dass Skalierbarkeit kein nachträglicher Gedanke sein sollte. Die Architektur, die wir für Rechnungen entwickelt haben, lässt sich leicht auf weitere Dokumentenarten wie Lieferscheine oder Angebote erweitern, was die Lösung zu einem zentralen Baustein der digitalen Transformation im Unternehmen macht.
Passend dazu
- Azure OpenAI vs. AWS Bedrock: Kosten und Compliance im Vergleich
- IT-Beratung & IT-Strategie
- KI-Beratung & KI-Strategie
- Cloud Automation Tools: Manuelle Lasten für IT-Teams reduzieren
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- E-Commerce Entwicklung
- Automotive Supplier in Munich: Edge-Cloud Integration Speeds Up Data Processing by 50 Percent
- US Healthcare Network in New York Improves Patient Portal Availability by 60 Percent with Synthetic Monitoring
- 28 % Reduktion der Cloud-Ausgaben für einen US-amerikanischen SaaS-Anbieter
- DevOps-Pipelines für den asiatischen Maschinenbau optimieren
- Managed Security Services für DACH und UK: Auswahlkriterien
- Logistics Hub in Frankfurt: Cutting Phishing Success Rates by 92% with AI-Driven Email Security
- Automated Clinical Data Extraction: Accelerating Trial Preparation by 30% for a Berlin-Based Biotech Startup
- Securing a Multi-Site Manufacturing Plant in DACH with Unified Endpoint Monitoring and Support
- Reducing Onboarding Friction for 500 New Employees in a UK Fintech via Centralized IT Support
- Churn Prediction in B2B SaaS: Retaining 25% More Customers with Behavioral AI Models in New York
- Digital Transformation in Manufacturing: 5 Quick Wins ohne hohe Investition
- Optimizing Azure Infrastructure for a DACH SaaS Company with CloudWatch
- European Manufacturing Group: Unifying IT Support Across 12 Sites with a Single Global MSP Dashboard
- KI-Tool-Vergleich: Die besten Plattformen für Prozessautomatisierung im DACH-Raum
- RPA für Order Fulfillment: 60 % weniger Fehler im DACH-Handel
- Personalized Marketing at Scale: Boosting Conversion Rates by 25% for a European SaaS Company with AI-Driven Segmentation
- Healthcare Data Protection: Reducing HIPAA Violations by 70 Percent via Micro-Learning for Clinical Staff
- Retail: Reducing Phishing-Related Downtime by 40% with Sentinel and Intune in the DACH Region
- MSP-Wahl für Mehrfilialen: Checkliste für DACH und globale Teams