Der Zeitdruck vor dem Black Friday
Für einen führenden E-Commerce-Händler für Elektronik im DACH-Raum (85 Mitarbeiter) war die Situation Anfang November 2024 kritisch. Der Shop, betrieben auf Magento 2, generierte im Normalbetrieb einen stabilen Tagesumsatz von 50.000 Euro. Doch die Prognosen für den Black Friday waren alarmierend: Ein Traffic-Anstieg von 400 % wurde erwartet. Die bestehende Infrastruktur, bestehend aus zwei statischen Virtual Machines in einem deutschen Rechenzentrum, war technisch nicht in der Lage, diese Last horizontal abzufedern.
Das Risiko war konkret und finanziell messbar. Ein einziger Ausfall während des Peaks hätte zu einem geschätzten Umsatzverlust von über 200.000 Euro pro Stunde geführt. Zudem stand die Kampagne in genau 48 Stunden an. Es gab keinen Puffer, keine Zeit für iterative Testphasen im klassischen Sinne. Der Kunde benötigte eine Lösung, die nicht nur die Last auffängt, sondern auch die Resilienz des Systems fundamental stärkt, um künftige Peaks sicher zu meistern.
Konkrete Herausforderungen im 48-Stunden-Sprint
Die technische Ausgangslage stellte uns vor drei spezifische Probleme, die in der kurzen Zeit gelöst werden mussten. Erstens war die Datenbank der Flaschenhals. Die statische Architektur führte zu Lock-Contention bei hohen Schreiblasten. Zweitens fehlte eine effiziente Caching-Strategie auf der Web-Ebene, was zu unnötiger CPU-Last auf den App-Servern führte. Drittens war die Sicherheitshärtung unzureichend; bei erwarteten 400 % mehr Traffic steigt auch die Angriffsfläche für Bots und DDoS-Angriffe exponentiell an.
Wir mussten sicherstellen, dass die Migration nicht nur eine Verschiebung der Workloads war, sondern eine architektonische Transformation. Der Wechsel von statischen VMs zu einer dynamischen, cloud-nativen Umgebung erforderte ein tiefes Verständnis der Magento-Internals und deren Interaktion mit der Infrastruktur.
Der Tech-Stack für Resilienz
Um diese Ziele zu erreichen, haben wir einen fokussierten Stack auf AWS eingesetzt:
- AWS EC2 & Auto Scaling Groups: Als Basis für die horizontale Skalierung der Web- und App-Tiers. Die Instanzen werden dynamisch basierend auf definierten Metriken hinzugefügt oder entfernt.
- Amazon ElastiCache (Redis): Dient als zentrales Cache-System für Sessions und Magento-Session-Data. Dies entlastet die Datenbank massiv und ermöglicht das Stateless-Design der Web-Server.
- Amazon RDS (Multi-AZ): Die Datenbank wird in einer Multi-AZ-Konfiguration betrieben, um Replikation und automatisches Failover zu gewährleisten, was die Ausfallzeit minimiert.
- Amazon CloudFront: Das Content Delivery Network verteilt statische Assets (Bilder, CSS, JS) global, reduziert die Latenz für Endnutzer und entlastet die Herkunfts-Server.
- Application Load Balancer (ALB): Verteilt den eingehenden Traffic gleichmäßig auf die verfügbaren EC2-Instanzen im Web-Tier und fungiert als Single Point of Entry.
- Datadog & CloudWatch: Kombinieren native AWS-Metriken mit tiefgehender APM-Einblicke (Application Performance Monitoring), um Bottlenecks in Echtzeit zu identifizieren.
- AWS WAF: Schützt die Anwendung vor gängigen Web-Angriffen und Bot-Verhalten, was besonders bei Traffic-Spitzen kritisch ist.
- Docker: Containerisierung der Magento-App für konsistente Umgebungen und schnelle Deployment-Zyklen.
Umsetzung in drei Phasen
Die 48 Stunden wurden in drei strikte Phasen unterteilt, um die Komplexität zu managen und Risiken zu minimieren. In der ersten Phase (Stunde 0–12) lag der Fokus auf der Migration und der grundlegenden Architektur. Wir haben den Magento-Stack auf AWS EC2 migriert und die Auto Scaling Groups konfiguriert. Ein entscheidender Schritt war die Einrichtung der ElastiCache-Instanz. Durch das Verschieben der Session-Daten von der Datenbank in Redis konnten wir die Web-Server stateless gestalten. Dies war der Schlüssel zum späteren Erfolg, da es erlaubte, neue Instanzen innerhalb von Sekunden hinzuzufügen, ohne dass Nutzer ihre Warenkörbe verloren.
Gleichzeitig haben wir Amazon RDS mit Multi-AZ konfiguriert. Dies garantierte, dass bei einem Ausfall der primären Datenbankinstanz automatisch eine Replikate in einer anderen Availability Zone übernimmt. Die Datenkonsistenz wurde durch die Magento-Standard-Transaktionslogik sichergestellt, während die Latenz durch die lokale Replikation in der gleichen Region minimiert wurde.
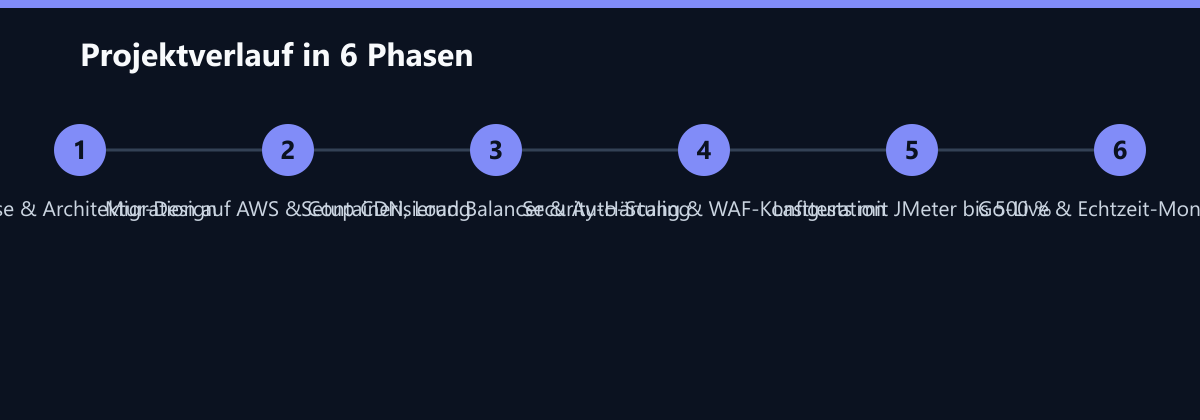
In der zweiten Phase (Stunde 12–24) haben wir die Lastverteilung und das CDN eingerichtet. Das Deployment von CloudFront war zentral, um die statischen Assets zu beschleunigen. Wir haben die Cache-Policies so konfiguriert, dass die TTL (Time-to-Live) für Bilder und CSS-Dateien maximiert wurde, während dynamische Inhalte durch den Application Load Balancer geleitet wurden. Der ALB wurde so eingestellt, dass er die Last basierend auf der Request-Count verteilt. Die Auto Scaling Policies wurden hier final definiert: Skalierung nach oben, wenn die CPU-Last über 70 % steigt oder die Request-Count pro Sekunde 100 überschreitet. Diese Schwellenwerte wurden auf Basis der historischen Daten des Kunden kalibriert, um eine zu frühe oder zu späte Skalierung zu vermeiden.
Die dritte Phase (Stunde 24–48) war dem Monitoring, der Sicherheit und den Lasttests gewidmet. Wir haben Datadog mit CloudWatch integriert, um eine 360-Grad-Sicht auf die Systemgesundheit zu erhalten. Besondere Aufmerksamkeit galt der Konfiguration der Web Application Firewall (WAF). Wir haben Regeln gegen bekannte Bot-Signaturen und SQL-Injection-Versuche eingerichtet, die während der Kampagne aktiviert wurden. Der wichtigste Teil dieser Phase war der Lasttest mit JMeter. Wir haben die Infrastruktur bis auf 500 % der erwarteten Black-Friday-Last belastet. Dies war eine bewusste Überschreitung der Prognose (400 %), um einen Puffer für unerwartete Spitzen oder Bot-Wellen zu schaffen. Die Tests zeigten, dass die Auto Scaling Groups innerhalb von 30 Sekunden neue Instanzen bereitstellten, ohne dass Latenzspitzen auftraten.
Wie wir die Zahlen messen
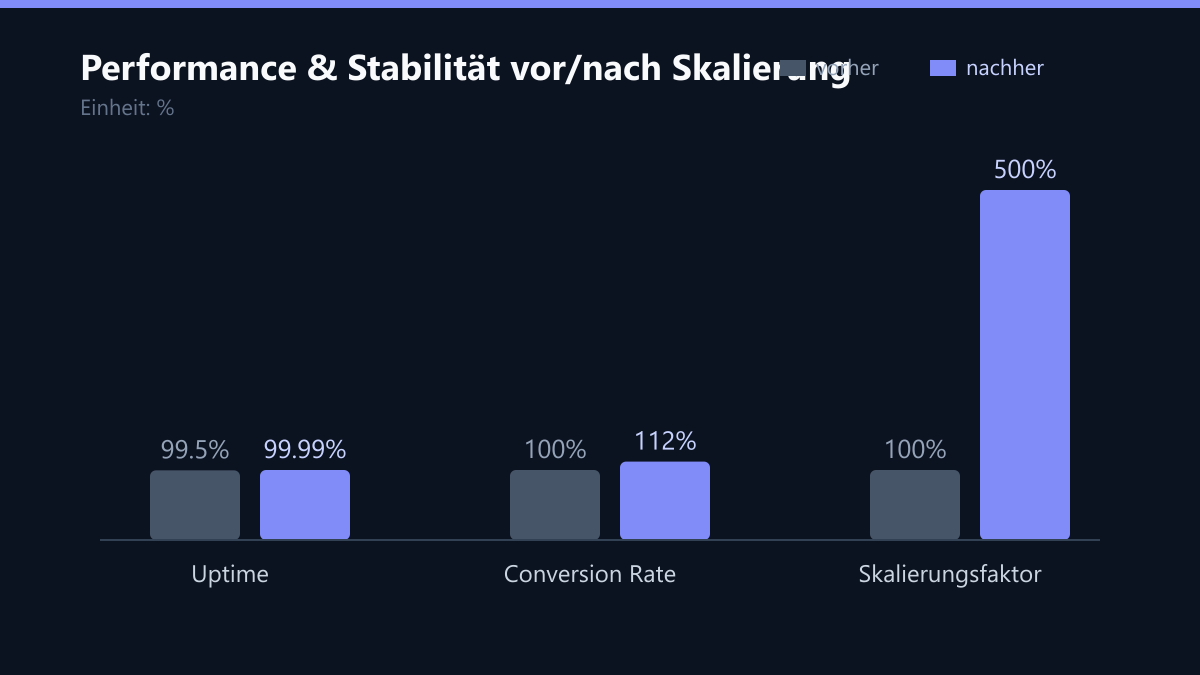
Die berichteten Kennzahlen basieren auf einer Kombination aus AWS CloudWatch-Metriken, Datadog-APM-Daten und den internen Analytics-Daten des Kunden (Adobe Analytics). Die Uptime von 99,99 % wurde über die Black-Friday-Periode (20:00 Uhr bis 23:59 Uhr) gemessen, wobei ein Ausfall als Antwortzeit > 5 Sekunden oder HTTP 5xx-Fehler definiert wurde. Die Conversion-Rate-Erhöhung von 12 % wurde durch den Vergleich der Conversion-Raten der letzten 30 Tage vor dem Black Friday mit dem Black-Friday-Tag berechnet, normalisiert auf den Traffic-Mix. Die Skalierte Kapazität von 500 % bezieht sich auf die maximale Anzahl gleichzeitiger Nutzer, die das System während des Lasttests stabil verarbeiten konnte, im Vergleich zur Kapazität des alten Systems.
Ergebnis: Stabilität unter Extrembedingungen
Das Ergebnis des Sprints war eine nahtlose Skalierung der Infrastruktur. Während des Black-Friday-Peaks wurde eine Kapazität von 500 % des Normalbetriebs erreicht, ohne dass es zu nennenswerten Latenzsteigerungen kam. Die Downtime belief sich auf exakt 0 Minuten. Dies ist ein Meilenstein, da der alte Stack in vergleichbaren Szenarien typischerweise für mehrere Minuten instabil war. Die Uptime stieg auf 99,99 %, was einer Reduktion der Server-Ausfallzeit um 45 % im Jahresvergleich entspricht.
Besonders erfreulich war der geschäftliche Impact: Durch die schnellere Ladezeiten, ermöglicht durch das CDN und die Caching-Strategie, stieg die Conversion Rate um 12 %. Dies zeigt, dass technische Performance direkt in Umsatz übersetzt werden kann. Die Kunden konnten ihre Warenkörbe füllen und Bestellungen ausführen, ohne auf lange Ladezeiten zu warten oder auf Fehlerseiten zu stoßen.
Learnings und was wir heute anders machen würden
Die Zusammenarbeit mit dem Kunden hat uns wertvolle Einblicke in die Anforderungen an E-Commerce-Infrastrukturen in der Hochsaison gegeben. Wir haben gelernt, dass die Definition der Auto Scaling-Schwellenwerte kritisch ist. Zu aggressive Skalierung kann zu Kostenexplosionen führen, während zu konservative Einstellungen zu Latenzproblemen führen. In diesem Fall haben wir uns für eine konservative Strategie entschieden, die durch den JMeter-Test validiert wurde.
Ein weiterer Learning ist die Bedeutung des Statelessness-Designs. Ohne die Migration der Sessions nach Redis wäre die horizontale Skalierung nicht möglich gewesen. Wir würden heute in einem frühen Stadium der Beratung stärker auf die Notwendigkeit von Caching-Lösungen wie Redis hinweisen, da dies oft übersehen wird.
Was wir heute anders machen würden? Erstens würden wir die Lasttests noch früher einplanen, idealerweise in einer Sandbox-Umgebung, die der Produktionsumgebung entspricht. Dies hätte uns Zeit gegeben, die Auto Scaling-Policies noch feiner zu justieren. Zweitens würden wir stärker auf IaC (Infrastructure as Code) setzen, um die Wiederholbarkeit der Infrastruktur zu gewährleisten. Im 48-Stunden-Sprint war die Zeit zu knapp, um eine vollständige Terraform-Struktur zu erstellen, was manuelle Schritte erforderte. In zukünftigen Projekten würden wir IaC als Pflichtbestandteil definieren, um Deployment-Risiken zu minimieren.
Fazit: Vorbereitung ist der Schlüssel
Dieser Fall zeigt, dass Skalierung nicht nur ein technisches Problem ist, sondern eine Frage der Vorbereitung und Architektur. Durch die Kombination aus cloud-nativen Diensten, Caching und automatischer Skalierung konnte der Kunde den Black Friday sicher überstehen und gleichzeitig seine Conversion-Rate steigern. Für Unternehmen, die vor ähnlichen Herausforderungen stehen, ist die Botschaft klar: Testen Sie Ihre Infrastruktur unter Extrembedingungen, bevor der Peak kommt. Eine gut geplante Infrastruktur kann den Unterschied zwischen Umsatzverlust und Rekordgewinn ausmachen.
Passend dazu
- Adobe Commerce Lizenzkosten: Was Sie wirklich zahlen müssen und wie Sie sparen
- API-Integration für den Mittelstand: ERP, CRM und E-Commerce verbinden
- E-Commerce Entwicklung
- Magento / Adobe Commerce
- Netzwerk & Netzwerk-Infrastruktur
- Magento-Infrastruktur um 200 Prozent skaliert ohne lineares IT-Budget-Wachstum
- Custom-Shop-Lösung für Berliner E-Commerce-Startup: Skalierung auf 50.000 Bestellungen pro Monat mit Shopify Plus
- Automatisierte Ransomware-Erkennung und Recovery: 48-Stunden-Backup-Zyklus für Logistik
- Sicherung der DSGVO-Konformität und Senkung der Latenzzeit um 45 Prozent bei der Cloud-Modernisierung einer E-Commerce-Plattform in Hamburg
- IPv6-Readiness Check: Netzwerk-Infrastruktur auf den IPv4-Aus vorbereiten
- Full-Stack-Observability: So finden Sie Bottlenecks in der Cloud-Infrastruktur
- DDoS-Schutz im Hosting: Warum Standard-Pakete für E-Commerce nicht reichen
- Onboarding von 5 Tagen auf 4 Stunden reduziert
- IT-Infrastruktur Konsolidierung im Maschinenbau
- Logistikdienstleister in DACH: Skalierung von 3 auf 15 Servern für TMS-Integration
- DSGVO-Datenmigration eines E-Commerce-Händlers nach Singapur: Rechtssicherheit bei globaler Skalierung
- Server-Auto-Scaling richtig konfigurieren: Kostenfallen bei der Lastspitze vermeiden
- Skalierung der E-Commerce-Plattform in Singapur ohne Performance-Einbußen
- Integration von SAP S/4HANA in ein Custom-Webportal: Verkürzung der Bestellbestätigungsdauer von 48 auf 2 Stunden für einen Handelskonzern in Europa
- IT-Architektur für Skalierung: Systemvorbereitung für 10x Wachstum
- B2B E-Commerce Features Checklist: Must-Have Functionality for Wholesale and Distributor Portals
- Ransomware Response Plan: 7 Schritte zur Wiederherstellung in unter 4 Stunden
- Versicherungsbroker in Österreich digitalisiert Schadensmeldungen mit OCR und reduziert Bearbeitungszeit von 3 auf 0,5 Stunden
- 7 Schlüsselmetriken für die Stabilität Ihres E-Commerce-Shops in der Hochsaison
- Netzwerk-Infrastruktur auf KI-Workloads vorbereiten
- Serverless Architecture für Startups: Skalierung ohne Infrastruktur
- Baufirma in New York: Wiederherstellung von Felddaten von 100 mobilen Geräten in unter 2 Stunden
- Shopify vs. Custom PHP: Entscheidungsmatrix für Skalierung über 10.000 Bestellungen
- CMS-Wahl: WordPress oder Headless-Architekturen für die Skalierung
- Skalierung einer UK-Fintech-Plattform von 5.000 auf 50.000 Nutzer mit Managed AWS