Ausgangslage: Manuelle Prozesse als Risikofaktor
Der Kunde, ein etablierter Logistikdienstleister mit 200 Mitarbeitenden im DACH-Raum, betreibt ein zentrales Lager in Süddeutschland. Die tägliche Logistikleistung von über 5.000 Sendungen macht die IT-Infrastruktur zum kritischen Nervensystem des Unternehmens. Ursprünglich bestand das Setup aus einer heterogenen Mischung aus On-Premise-Servern und Cloud-Diensten, die ohne zentrales Monitoring betrieben wurden. Diese Dezentralität führte zu einem erheblichen Blindflug in der IT-Sicherheit.
Der akute Schmerzpunkt lag in der manuellen Backup-Routine. IT-Administratoren waren gezwungen, täglich um 22:00 Uhr manuell Backup-Jobs zu starten und anschließend die Logs zu prüfen. Dieser Prozess war nicht nur arbeitsintensiv, sondern auch fehleranfällig. Bei einem Ausfall oder einer Störung im Nachtdienst währte es oft bis zum Beginn des nächsten Arbeitstags, bis ein Problem bemerkt wurde. In einer Branche, in der Lieferkettenbruch existenzbedrohend ist, war diese Reaktionszeit inakzeptabel.
Ein externer Security-Scan im Vorfeld der Projektierung deckte kritische Schwachstellen in der Netzwerksegmentierung auf. Die Analyse zeigte, dass ein erfolgreicher Ransomware-Angriff den kompletten Versandprozess für mindestens 72 Stunden lahmgelegt hätte. Der CEO des Unternehmens forderte daraufhin eine Lösung, die Angriffe nicht nur reaktiv behandelt, sondern automatisch erkennt und den Betrieb innerhalb weniger Stunden wiederherstellt. Die Anforderung war klar: Null Toleranz für Datenverlust und maximale Automatisierung.
Herausforderungen: Heterogenität und Geschwindigkeit
Die Umsetzung stand vor drei konkreten Herausforderungen, die über reine Softwareinstallation hinausgingen:
- Heterogene Umgebung: Die Integration von Legacy-Servern mit modernen Cloud-Diensten erforderte eine einheitliche Sichtbarkeit, die es bisher nicht gab.
- Zeitkritische Prozesse: Jedes Backup-Fenster durfte den operativen Betrieb nicht stören, da die Lagerlogistik rund um die Uhr lief.
- Menschliche Faktoren: Die Abhängigkeit von manueller Eingriffe musste beseitigt werden, um Fehlerquellen wie vergessene Starts oder falsch konfigurierte Jobs auszuschließen.
Der Tech-Stack
Um die geforderte Resilienz zu erreichen, setzten wir auf einen bewährten Stack aus Sicherheits- und Backup-Tools:
- Endpoint Detection and Response (EDR): Für Echtzeit-Analyse und automatische Isolierung kompromittierter Hosts.
- Immutable Cloud Storage: Mit Object-Lock-Funktion, um Backups vor Löschung durch Angreifer oder Admins zu schützen.
- Automatisierungs-Orchestrator: Für die Steuerung der Backup-Pipelines und Incident-Response-Playbooks.
- Zentrales SIEM-System: Zur Korrelation von Logdaten aus EDR, Netzwerk und Backup-Servern.
Umsetzung: Defense-in-Depth in sechs Wochen
Wir implementierten eine mehrschichtige Defense-in-Depth-Strategie innerhalb eines straff definierten Zeitrahmens von sechs Wochen. Der Fokus lag von Anfang an auf der vollständigen Automatisierung, um menschliche Fehler bei der Backup-Steuerung und Incident-Response auszuschließen.
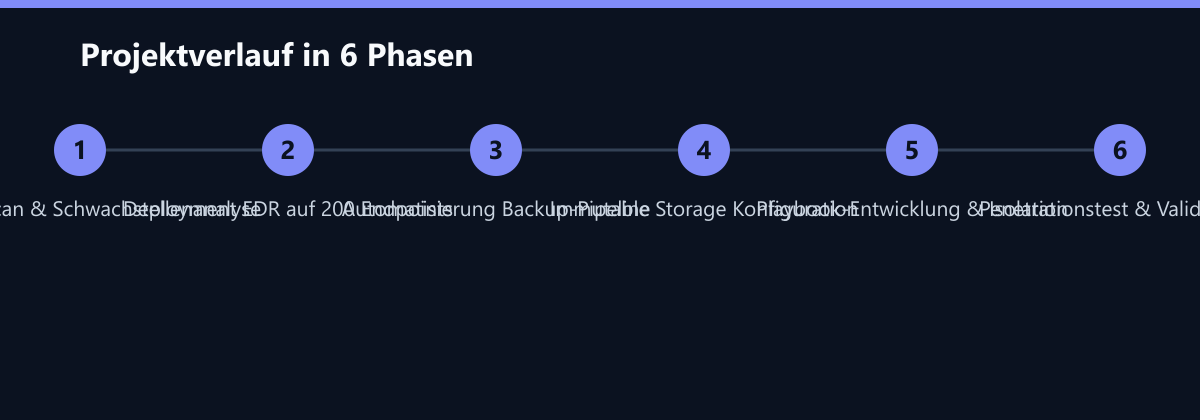
Schritt 1: Zentrales Monitoring & EDR-Deployment
Die Basis der neuen Sicherheitsarchitektur bildete die Installation eines Endpoint Detection and Response (EDR) Systems auf allen 200 Arbeitsplätzen und Servern. Im Gegensatz zu klassischen Virenscannern analysiert das EDR-System das Verhalten der Endpoints in Echtzeit. Es lernt ein Baseline-Verhalten und meldet anomale Aktivitäten – wie plötzliche Massenzugriffe auf Dateien oder ungewöhnliche Netzwerkverbindungen – sofort an unser Security Operations Center (SOC). Diese Echtzeit-Sichtbarkeit war der entscheidende Hebel, um die Erkennungszeit von Tagen auf Minuten zu senken.
Schritt 2: Automatisierter Backup-Zyklus
Die manuellen Jobs wurden durch eine vollautomatisierte Pipeline ersetzt, die ohne menschliches Zutun läuft. Wir setzten dabei auf eine differenzierte Strategie:
- Inkrementelle Backups: Diese finden alle 4 Stunden für kritische Datenbank- und ERP-Systeme statt. Dies minimiert die potenzielle Datenverlustmenge (RPO) auf maximal vier Stunden.
- Vollbackups: Täglich um 02:00 Uhr, in einer Phase geringer Auslastung, werden vollständige Snapshots erstellt.
- Immutable Storage: Alle Backups werden in einem Cloud-Bucket mit Schreibschutz (Object Lock) abgelegt. Diese Funktion stellt sicher, dass selbst ein Admin mit Root-Rechten die Backups nicht löschen oder überschreiben kann. Dies ist der wichtigste Schutz gegen Ransomware, die oft gezielt Backups löscht, um die Wiederherstellung zu verhindern.
Schritt 3: Automatisierte Incident Response
Parallel zur Prävention entwickelten wir automatisierte Playbooks für den Ernstfall. Wenn das EDR-System Ransomware-Muster erkennt, wird der betroffene Host nicht nur gemeldet, sondern automatisch vom Netzwerk isoliert. Diese Isolation verhindert die laterale Bewegung des Schadcodes auf andere Systeme. Parallel dazu startet der Recovery-Prozess für die letzten gesicherten Datenpunkte. Die Kombination aus Isolation und automatisiertem Restore minimiert die Downtime drastisch.
Wie wir die Zahlen messen
Um die Effektivität der Lösung zu belegen, haben wir einen klaren Messplan definiert, der über reine Uptime-Zahlen hinausgeht. Die Kennzahlen wurden über einen Zeitraum von sechs Monaten nach dem Go-Live erhoben.
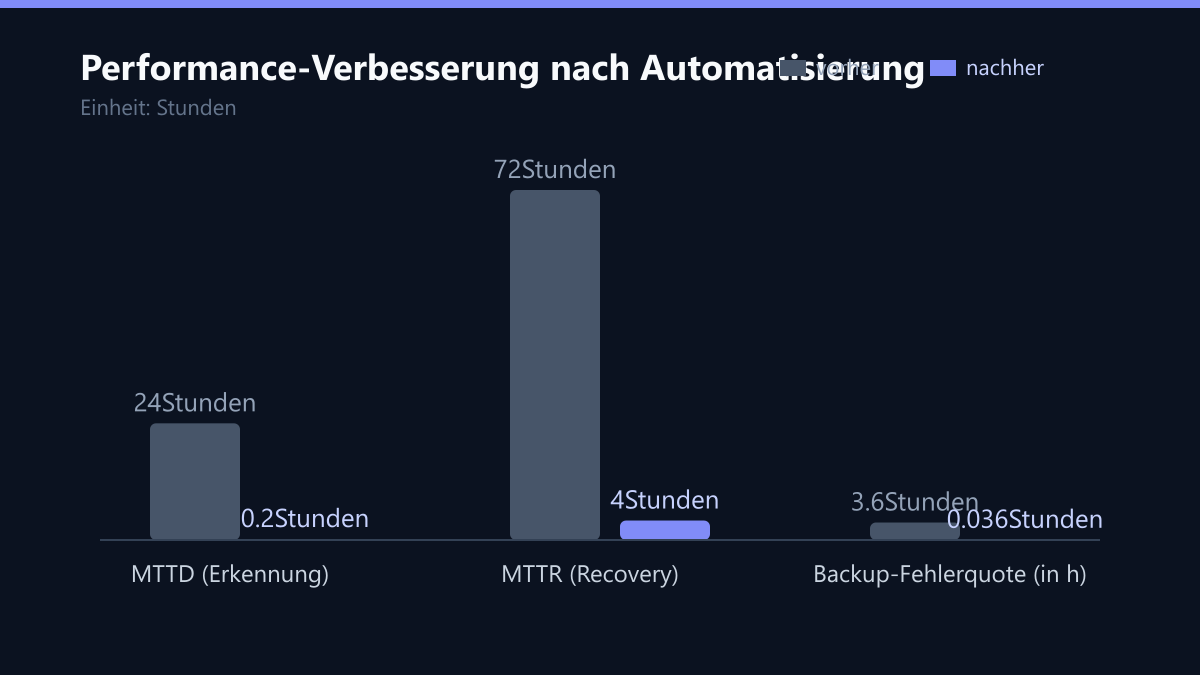
- MTTD (Mean Time to Detect): Gemessen vom Zeitpunkt der ersten anomalen Aktivität bis zur Benachrichtigung im SOC. Wir nutzten dafür die Timestamps der EDR-Logs und der Alarmierungssysteme. Vorher lag der Durchschnitt bei 24 Stunden, da manuelle Log-Prüfungen oft erst am nächsten Morgen stattfanden. Nach der Implementierung sank dieser Wert auf 12 Minuten, da das EDR in Echtzeit alertet.
- MTTR (Mean Time to Recover): Diese Metrik erfasst die Zeit von der Feststellung des Schadens bis zur vollständigen Wiederherstellung der Dienste. Wir maßen dies anhand der Zeiträume in den Incident-Tickets und den Restore-Logs der Backup-Software. Die Reduktion von 72 Stunden auf 4 Stunden resultiert aus der automatisierten Isolation und dem schnellen Zugriff auf die Immutable Backups.
- Backup-Erfolgsrate: Hier vergleichen wir die Anzahl der erfolgreich abgeschlossenen Backup-Jobs mit der Anzahl der geplanten Jobs. Vorher lag die Rate bei 85 %, da manuelle Eingriffe oft fehlerhaft waren oder Jobs abgebrochen wurden. Mit der Automatisierung und den Immutable Backups stieg die Rate auf 99,9 %.
Ergebnis: Von reaktiv zu proaktiv
Die neue Infrastruktur hat die Resilienz des Unternehmens massiv gesteigert. Die Reaktionszeiten sanken von Tagen auf Minuten, was in der Logistikbranche einen entscheidenden Wettbewerbsvorteil darstellt.
KPIs nach 6 Monaten Betrieb:
- MTTD (Mean Time to Detect): Von 24 Stunden auf 12 Minuten gesunken.
- MTTR (Mean Time to Recover): Von 72 Stunden auf 4 Stunden reduziert.
- Backup-Erfolgsrate: Steigerung von 85 % (manuell) auf 99,9 % (automatisiert).
Ein simulierter Ransomware-Angriff im Rahmen eines Penetrationstests bestätigte diese Zahlen in der Praxis. Das System isolierte den infizierten Server in nur 90 Sekunden. Der Betrieb wurde aus dem letzten gültigen Backup (4 Stunden alt) wiederhergestellt, ohne dass ein einziger Sendungsdatensatz verloren ging. Diese Validierung gab dem Management die nötige Sicherheit, dass die Investition sich im Ernstfall auszahlen würde.
Darüber hinaus konnte sich die IT-Abteilung von der Routine-Überwachung lösen. Die täglichen manuellen Checks entfielen, und das Team konnte seine Kapazitäten auf strategische Projekte wie die Digitalisierung der Flotte und die Optimierung der Lagerlogistik umlenken. Dies führte nicht nur zu einer höheren IT-Resilienz, sondern auch zu einer spürbaren Steigerung der Innovationskraft innerhalb des Unternehmens.
Was wir heute anders machen würden
Rückblickend gibt es zwei Punkte, die wir in ähnlichen Projekten heute früher anpacken würden:
- Frühzeitige Microsegmentierung: Wir haben die Netzwerksegmentierung erst nach dem EDR-Deployment optimiert. Heute würden wir die Microsegmentierung parallel zum EDR-Setup starten, um die Angriffsfläche von Anfang an zu minimieren.
- Schulung der Mitarbeiter: Die automatische Isolation ist nur so gut wie das Verständnis der Mitarbeiter für die neuen Prozesse. Heute würden wir intensiver in die Schulung der IT-Mitarbeiter und der Führungskräfte investieren, um die Akzeptanz der automatisierten Entscheidungen zu erhöhen.
Learnings: Automatisierung ist Pflicht
Automatisierung ist im Mittelstand kein Nice-to-have, sondern ein Muss. Manuelle Prozesse sind anfällig für Fehler und Verzögerungen, die im Ernstfall existenzbedrohend sein können. Die drei wichtigsten Learnings aus diesem Projekt:
- Immutable Backups sind Pflicht: Ohne Schreibschutz sind Backups bei Ransomware-Angriffen nutzlos, da Angreifer sie oft zuerst löschen. Die Investition in Immutable Storage ist der günstigste Weg, die Wiederherstellbarkeit zu garantieren.
- Isolation schlägt Löschung: Die automatische Netzwerk-Isolation verhindert die laterale Bewegung des Schadens, bevor er das gesamte System erreicht. Dies ist effektiver als das bloße Löschen von Dateien, da der Schaden bereits eingetreten ist.
- Regelmäßige Tests: Die Infrastruktur wird nur so gut wie der letzte erfolgreiche Recovery-Test. Wir empfehlen quartalsweise simulierte Angriffe, um die Playbooks zu validieren und Schwachstellen frühzeitig zu erkennen.
Für Unternehmen mit zeitkritischen Prozessen wie Logistik ist die Kombination aus EDR und automatisiertem, immutable Backup der sicherste Weg, um Business Continuity zu garantieren. Wer hier spart, riskiert nicht nur Daten, sondern den gesamten Betrieb.
Passend dazu
- IT- & Daten-Wiederherstellung (Disaster Recovery)
- IT-Beratung & IT-Strategie
- Backup & Disaster Recovery
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- Hybride Cloud-Backup-Strategie senkt RTO auf 4 Stunden
- Automatisierte NIS2-Readiness-Prüfung senkt Audit-Zeit für mittelständische Logistikfirma in München um 40 Prozent
- SD-WAN senkt Netzwerklatenz im Berliner Logistikhub um 40 Prozent
- TCO um 30 Prozent gesenkt: Managed Hosting mit automatisiertem Backup
- On-Premise vs. Cloud-Backup: TCO-Vergleich und Skalierbarkeit
- Ransomware-Resilienz: Wie immutable Backups und Air-Gapped-Strategien Ihren Mittelstand schützen
- Logistikunternehmen in Hamburg automatisiert Disaster Recovery für 50 Standorte
- Backup-Automatisierung: Wie Sie manuelle Prozesse durch KI-gestützte Orchestrierung ersetzen
- DSGVO-Audit im Mittelstand: Risikominimierung durch automatisierte Datenklassifizierung
- DSGVO-konformes Backup: Datenminimierung und Löschkonzepte in der Cloud
- Skalierung der E-Commerce-Infrastruktur für den Black-Friday-Peak in 48 Stunden
- Backup-Strategien im Server-Hosting: 3-2-1-Regel für maximale Datenresilienz
- Backup-Strategie für OT-Systeme: Schutz der Fertigung vor Ransomware ohne Produktionsstopp
- AIOps im Mittelstand: Automatisierte Root-Cause-Analyse ohne Data-Science-Team
- Ransomware Recovery: 5 kritische Fehler bei der AD-Wiederherstellung
- Onboarding von 5 Tagen auf 4 Stunden reduziert
- Automatisierte Compliance-Berichte für Finanzdienstleister
- Integration von SAP S/4HANA in ein Custom-Webportal: Verkürzung der Bestellbestätigungsdauer von 48 auf 2 Stunden für einen Handelskonzern in Europa
- KI-Suchmaschinen-Ranking für eine spanische Logistik-Software: Steigerung der organischen Klicks um 40%
- Backup Retention Strategien: Kompliance und Kosten im Gleichgewicht
- Backup-Verifikation: 5 Schritte für die Datenintegrität ohne Produktionsausfall
- Die 3-2-1-1-0-Backup-Regel: Eine praktische Umsetzungsanleitung
- Ransomware Response Plan: 7 Schritte zur Wiederherstellung in unter 4 Stunden
- OT-Sicherheit: 200 Shop-Floor-Operator vor Ransomware schützen
- Ransomware-Versicherung: Diese IT-Sicherheitsanforderungen gelten
- Data Loss Prevention vs Data Recovery: Der Unterschied für IT-Sicherheitsteams
- Versicherungsbroker in Österreich digitalisiert Schadensmeldungen mit OCR und reduziert Bearbeitungszeit von 3 auf 0,5 Stunden
- Backup-Integrität prüfen: 5 automatisierte Tests ohne Produktivitätsverlust
- Manufacturing Data Recovery: Restoring 2TB of ERP Data in 45 Minutes After Ransomware Attack in Bavaria
- Baufirma in New York: Wiederherstellung von Felddaten von 100 mobilen Geräten in unter 2 Stunden
- Retail DACH: Ransomware Recovery of 12,000 Customer Records in 4 Hours Using Immutable Azure Snapshots
- Automatisierte Failover-Tests: DR-Pläne validieren ohne Betriebsunterbrechung
- Backup Encryption Standards: AES-256 vs XTS for Compliance-Heavy Industries
- Die 5 häufigsten Ransomware-Angriffsvektoren und wie MSSP-Schutz sie blockt
- Vom Reaktiven Zum Predictiven: KI-Anomalie-Erkennung in 30 Tagen