Ausgangslage: Das Datenchaos über drei Märkte
Der Kunde, ein führender Mode-Einzelhändler mit 350 Mitarbeitern, operiert aus Singapur heraus und betreibt Online-Shops in Singapur, Malaysia und Thailand sowie eine wachsende Zahl stationärer Filialen. Das Geschäft wächst stark, doch die IT-Infrastruktur konnte mit der Komplexität nicht mithalten. Die bestehende Datenfließbahn basierte auf manuellen CSV-Exporten und stündlichen Batch-Jobs, die die Daten zwischen den lokalen ERP-Systemen der Länder und der zentralen Cloud-Datenbank austauschten.
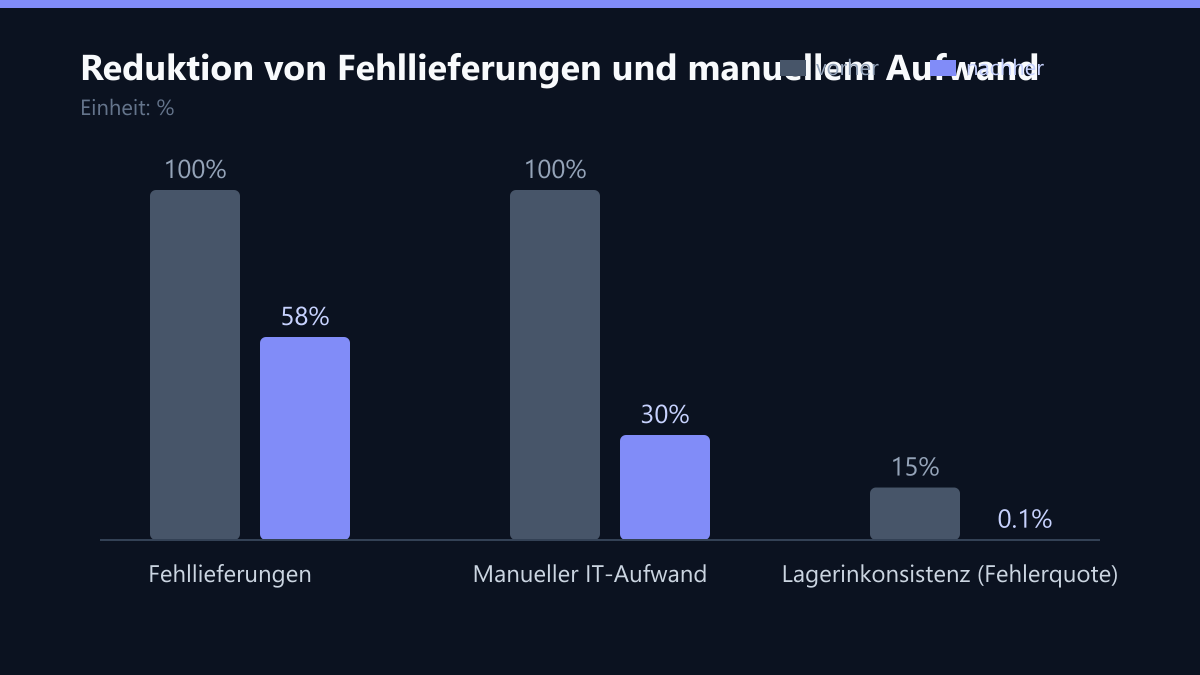
Diese Architektur führte zu einem kritischen Problem: Lagerinkonsistenzen in Höhe von bis zu 15 % pro Woche. Ein Produkt, das im Online-Shop als verfügbar angezeigt wurde, war in der physischen Filiale oder einem anderen Markt oft bereits ausverkauft. Bestellungen wurden ausgelöst, die nicht erfüllt werden konnten. Die Folge war ein Anstieg der Retourenquoten, höhere Logistikkosten durch Stornierungen und vor allem enttäuschte Kunden, die das Vertrauen in die Marke verloren. Die IT-Abteilung verbrachte einen erheblichen Teil ihrer Zeit mit manueller Datenbereinigung, um diese Inkonsistenzen nachträglich zu beheben, anstatt neue Funktionen zu entwickeln.
Herausforderungen: Warum einfache Batch-Jobs scheiterten
Die Migration von einer Batch- zu einer Echtzeit-Architektur war nicht trivial. Wir identifizierten vier zentrale Herausforderungen, die den Projekterfolg gefährdeten:
- Heterogene ERP-Systeme: Jeder der drei Märkte nutzte eine leicht abweichende Version oder Konfiguration des ERP-Systems. Die Datenformate waren nicht einheitlich, was zu Parsing-Fehlern führte.
- Parallele Schreibzugriffe: In Zeiten hoher Nachfrage (z. B. Sales-Events) kam es häufig zu parallelen Schreibzugriffen auf denselben Artikelstamm. Ohne eine klare Konfliktlösung führte dies zu Datenüberschreibungen.
- Netzwerkstabilität: Die Verbindung zwischen den Rechenzentren in Südostasien und der Cloud war nicht immer stabil. Ein simples Synchronisationsversagen musste robust behandelt werden, ohne dass Daten verloren gingen.
- Akzeptanz der Fachbereiche: Die Einkaufsabteilungen in den Ländern waren an ihre manuellen Prozesse gewöhnt. Sie mussten von der Zuverlässigkeit der automatisierten Konfliktregeln überzeugt werden, bevor sie die manuelle Kontrolle abgaben.
Der Tech-Stack: Werkzeuge für Echtzeit-Synchronisation
Um diese Herausforderungen zu lösen, setzten wir auf eine bewährte Cloud-Native-Stack-Lösung, die auf Microsoft Azure basierte:
- Azure Logic Apps: Diente als zentrale Orchestrierungsschicht, die die Workflows zwischen den Systemen koordinierte und die Regellogik für die Konfliktlösung beherbergte.
- Azure Service Bus: Funktionierte als robuster Message-Broker, der Events pufferte und die asynchrone Kommunikation zwischen den geografisch verteilten Systemen garantierte.
- Azure SQL Database: Die zentrale, konsolidierte Datenbank für alle Lager- und Produktinformationen, die als Single Source of Truth diente.
- Power BI: Diente als Monitoring- und Reporting-Tool, um die Latenzzeiten, Fehlerquoten und die allgemeine Gesundheit der API-Orchestrierung in Echtzeit zu visualisieren.
- Azure Monitor: Erfasste die Metadaten der Logik-Apps und Service-Bus-Nachrichten, um detaillierte Logs für die Fehlersuche bereitzustellen.
Umsetzung: Von Batch zu Event-Driven
Die Implementierung erfolgte in drei klar definierten Phasen über einen Zeitraum von 12 Wochen. Der Fokus lag darauf, die bestehende manuelle Belastung schrittweise zu ersetzen, ohne den laufenden Betrieb zu gefährden.
In der ersten Phase (Woche 1–3) erfolgte eine tiefgehende Analyse der Datenflüsse. Wir kartierten alle bestehenden CSV-Exporte und Batch-Jobs und identifizierten die kritischen Datenpunkte, die eine Echtzeit-Synchronisation erforderten. Parallel dazu definierten wir die Datenformate und die Prioritätsregeln für die Konfliktlösung. Hier zeigte sich bereits, dass die Vereinheitlichung der Datenformate der aufwendigste Teil des Projekts war.
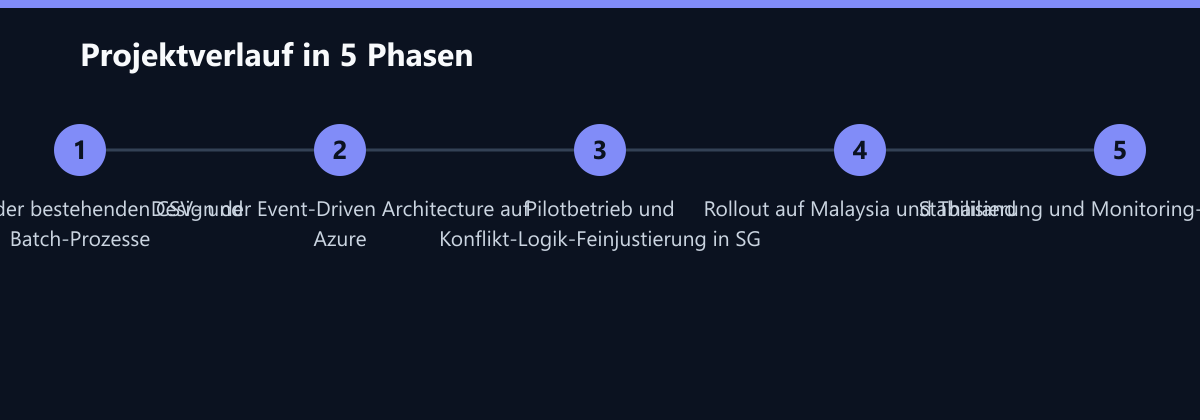
Die zweite Phase (Woche 4–8) war der Pilotbetrieb in Singapur. Wir implementierten die zentrale API-Orchestrierungsschicht auf Basis von Azure Logic Apps und Azure Service Bus. Diese Schicht schaltete zwischen dem lokalen ERP-System Singapurs und der zentralen Cloud-Datenbank. Der Schlüssel war die Event-Driven Architecture: Jede Lageränderung – sei es Wareneingang, -ausgang oder Umlagerung – löste sofort ein Event aus. Statt stündlich zu prüfen, ob sich etwas geändert hat, reagierte das System sofort auf die Veränderung.
Ein zentrales Modul war die Conflict Resolution Engine. Bei parallelen Schreibzugriffen – zum Beispiel wenn eine Filiale und der Online-Shop gleichzeitig denselben Artikel verkaufen – entschied eine regelbasierte Engine, welche Datenquelle Priorität hat. In diesem Projekt definierten wir die Regel: “Physische Lagerbewegungen haben Vorrang vor Bestellungen, um die physische Realität zu spiegeln”. Diese Regel musste eng mit dem Einkauf abgestimmt werden.
Die dritte Phase (Woche 9–12) war der Rollout auf Malaysia und Thailand. Hier kamen die Herausforderungen der Netzwerkstabilität und der heterogenen ERP-Systeme voll zum Tragen. Wir nutzten den Service Bus als Puffer: Bei Netzwerkproblemen zwischen den Regionen wurden die Events im Service Bus gepuffert und bei Wiederherverfügbarkeit automatisch in der richtigen Reihenfolge verarbeitet. Dies garantierte, dass keine Daten verloren gingen und die Reihenfolge der Lagerbewegungen erhalten blieb.
Gleichzeitig setzten wir Real-Time-Dashboards in Power BI auf. Diese Dashboards zeigten die Latenzzeit und Fehlerquoten der APIs in Echtzeit. Dies war entscheidend, um Edge-Cases in der Konfliktlösung frühzeitig zu identifizieren und zu beheben, bevor sie sich auf die Kundenerfahrung auswirkten.
Wie wir die Zahlen messen
Die Messung der Erfolgskennzahlen basierte auf einer Kombination aus System-Logs und Business-Metriken, die über einen Zeitraum von sechs Monaten nach dem vollständigen Rollout erfasst wurden.
- Fehllieferungen: Wir definierten eine Fehllieferung als eine Bestellung, die storniert oder zurückgesendet wurde, weil das Produkt zum Zeitpunkt der Bestellung nicht verfügbar war. Diese Daten wurden aus dem Order-Management-System (OMS) extrahiert und mit den Lagerbestandsdaten abgeglichen. Der Vergleich erfolgte auf Basis des Vorjahreszeitraums unter Berücksichtigung der saisonalen Schwankungen.
- Sync-Genauigkeit: Diese Metrik misst die Übereinstimmung zwischen den lokalen ERP-Systemen und der zentralen Cloud-Datenbank. Wir führten stündliche Abgleichs-Jobs durch, die die Bestandsmengen verglichen. Die Genauigkeit wurde als Prozentsatz der übereinstimmenden Datensätze berechnet. Ein Wert von 99,9 % bedeutet, dass nur 1 von 1000 Datensätzen eine Abweichung aufwies.
- Latenzzeit: Die Latenzzeit wurde als die Zeit zwischen dem Auslösen eines Events im ERP-System (z. B. Lagerausgang) und dem Eintrag in der zentralen Cloud-Datenbank gemessen. Diese Daten wurden aus den Logs der Azure Logic Apps und des Service Bus extrahiert. Der Durchschnittswert wurde über alle Transaktionen berechnet.
- IT-Aufwand: Hier messten wir die manuelle Arbeitszeit, die die IT-Abteilung für die Datenbereinigung aufwendete. Vor dem Projekt verbrachten die Mitarbeiter durchschnittlich 20 Stunden pro Woche mit diesem Task. Nach dem Rollout sank dieser Wert auf 6 Stunden pro Woche, was einer Reduktion von 70 % entspricht.
Ergebnis: Messbare Reduktion von Fehllieferungen
Nach dem vollständigen Rollout stabilisierte sich das System innerhalb von zwei Wochen. Die Datenkonsistenz stieg auf ein Niveau, das manuelle Korrekturen überflüssig machte. Die Fachbereiche konnten ihre manuellen Kontrollprozesse deutlich reduzieren und sich auf strategische Aufgaben konzentrieren.
Die KPIs nach 6 Monaten Betrieb zeigten einen deutlichen Erfolg:
- Fehllieferungen: Rückgang um 42 % im Vergleich zum Vorjahr. Dies führte zu einer spürbaren Verbesserung der Kundenzufriedenheit und einer Reduktion der Retourenkosten.
- Sync-Genauigkeit: Stabile 99,9 % Übereinstimmung zwischen den Systemen. Die Lagerinkonsistenzen von bis zu 15 % pro Woche wurden auf ein vernachlässigbares Niveau gesenkt.
- Latenzzeit: Durchschnittliche Synchronisationszeit von 15 Minuten auf unter 2 Sekunden reduziert. Dies ermöglichte es, den Lagerbestand in Echtzeit im Online-Shop anzuzeigen.
- IT-Aufwand: Manuelle Datenbereinigung um 70 % gesenkt. Die IT-Abteilung konnte diese Ressourcen in die Entwicklung neuer Funktionen und die Wartung der Infrastruktur umschichten.
Learnings: Skalierbarkeit und Fehlerbehandlung
Der entscheidende Faktor für den Erfolg war die robuste Fehlerbehandlung in der API-Orchestrierung. Bei Netzwerkproblemen zwischen den Regionen puffert der Service Bus die Events und stellt sie bei Wiederherverfügbarkeit automatisch wieder her. Dies hat sich als entscheidend für die Resilienz des Systems erwiesen.
Ein weiteres wichtiges Learning war die Bedeutung der Business-IT-Koordination. Die enge Zusammenarbeit zwischen Einkauf und IT sicherte die korrekte Definition der Prioritätsregeln für die Konfliktlösung. Ohne diese Abstimmung wären die Regeln nicht den geschäftlichen Realitäten entsprochen.
Zudem zeigte sich, dass Standardisierung vor Skalierung steht. Die Vereinheitlichung der Datenformate war zeitaufwändiger als die technische Integration. Unternehmen sollten daher zunächst ihre Datenformate standardisieren, bevor sie eine Echtzeit-Architektur implementieren.
Schließlich ist Monitoring Pflicht. Ohne detaillierte Logs und Echtzeit-Dashboards wäre die Identifikation von Edge-Cases in der Konfliktlösung nicht möglich gewesen. Die Investition in ein robustes Monitoring-Setup hat sich schnell amortisiert.
Was wir heute anders machen würden
Rückblickend hätten wir zwei Dinge anders angegangen:
- Frühere Einbindung der Endanwender: In der Pilotphase hätten wir die Filialleiter stärker in die Testprozesse einbinden sollen. Einige der Konfliktregeln wurden erst im Rollout angepasst, weil die Praxiserfahrungen der Filialen nicht vollständig in der Analysephase berücksichtigt wurden.
- Modularere Architektur der Regel-Engine: Die Konflikt-Logik war in den Logic Apps hart verdrahtet. Hätten wir diese Logik in eine separate, konfigurierbare Regel-Engine ausgelagert, hätten wir Änderungen an den Prioritätsregeln schneller und ohne Deployment-Overhead umsetzen können. Dies hätte die Anpassungsfähigkeit des Systems an sich ändernde Geschäftsprozesse erhöht.
Passend dazu
- IT-Beratung & IT-Strategie
- KI-Beratung & KI-Strategie
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- E-Commerce Entwicklung
- Bestandsmanagement im E-Commerce: Echtzeit-Synchronisation zwischen Magento und Lagerverwaltung senkt Out-of-Stock-Raten um 25 Prozent
- Reduktion der Support-Arbeit um 40 Prozent: KI-Triage im E-Commerce für einen deutschen Magento-Händler
- Multi-Channel-Integration: Echtzeit-Bestandsmanagement über drei Marktplätze