Ausgangslage: Der blinde Fleck im B2B-Handel
Unser Kunde ist ein spezialisierter Händler für hochpreisige Industriekomponenten mit 85 Mitarbeitern im DACH-Raum. Das Geschäftsmodell basiert auf der Vertriebsplattform Magento und einem zentralen physischen Lager in Österreich. Die Herausforderung war nicht die Technologie an sich, sondern die fehlende Transparenz zwischen der digitalen Fassade und der physischen Realität. Vor dem Projekt lief die Bestandsverwaltung über eine Kombination aus Excel-Exporten und nächtlichen Batch-Jobs. Dieses Vorgehen sorgte für ein Zeitfenster von bis zu 24 Stunden, in dem die Website eine Verfügbarkeit anzeigte, die im Lager bereits nicht mehr existierte. Für B2B-Kunden, die oft in größeren Stückzahlen bestellen, ist diese Diskrepanz fatal: Sie führt zu abgebrochenen Bestellungen, Vertrauensverlust und einem hohen Aufwand im Kundenservice, der täglich Stunden damit verbrachte, Bestandsfragen per E-Mail zu klären. Die Out-of-Stock-Rate lag bei 12 %, was bei den hohen Warenumsätzen pro Artikel direkt in signifikanten Umsatzverlusten resultierte.
Herausforderungen: Warum einfache Cron-Jobs scheitern
Die technische Umsetzung einer Echtzeit-Lösung stieß auf drei spezifische Hürden, die über die reine API-Verbindung hinausgingen. Erstens war das bestehende Lagerverwaltungssystem (LVS) nicht für externe Echtzeit-Abfragen ausgelegt. Jede Anfrage hätte die Performance des LVS negativ beeinflusst, wenn man nicht vorsichtig vorgegangen wäre. Zweitens bestand das Problem der Datenkonsistenz bei parallelen Vorgängen: Wenn ein Kunde im Shop bestellt, während gleichzeitig eine Wareneingangsmeldung im Lager eingeht, muss die Middleware exakt die Reihenfolge und den Zustand der Bestände wiedergeben, um Doppelbuchungen zu vermeiden. Drittens war die Datenqualität der Stammdaten im LVS mangelhaft. Viele Artikel hatten veraltete Lagerorte oder fehlende Mengeneinheiten, was eine naive 1:1-Übertragung in den Magento-Shop zu Fehldarstellungen geführt hätte.
Der Tech-Stack
Um diese Anforderungen zu erfüllen, haben wir eine schlanke, aber robuste Middleware-Architektur aufgebaut, die als Puffer zwischen dem Magento-Shop und dem LVS fungiert.
- Magento 2: Als Frontend-System für den B2B-Handel, angepasst um Echtzeit-Inventory-Updates zu verarbeiten.
- Lagerverwaltungssystem (LVS): Das bestehende ERP-Modul für die physische Lagerhaltung.
- Custom Middleware: Eine auf Node.js basierende Applikation, die Webhooks empfängt und das Regelwerk ausführt.
- Redis: In-Memory-Datastore für den schnellen Zugriff auf den aktuellen Bestandsstatus und als Lock-Mechanismus gegen Race Conditions.
- RabbitMQ: Message Queue zur Entkopplung der Ereignisse und Sicherstellung, dass keine Lagerbewegung verloren geht, auch bei Netzwerkstörungen.
- Grafana & Prometheus: Für das Monitoring der API-Latenzen und der Fehlerraten der Synchronisation.
Umsetzung: Vom Batch-Job zur Echtzeit-Pipeline
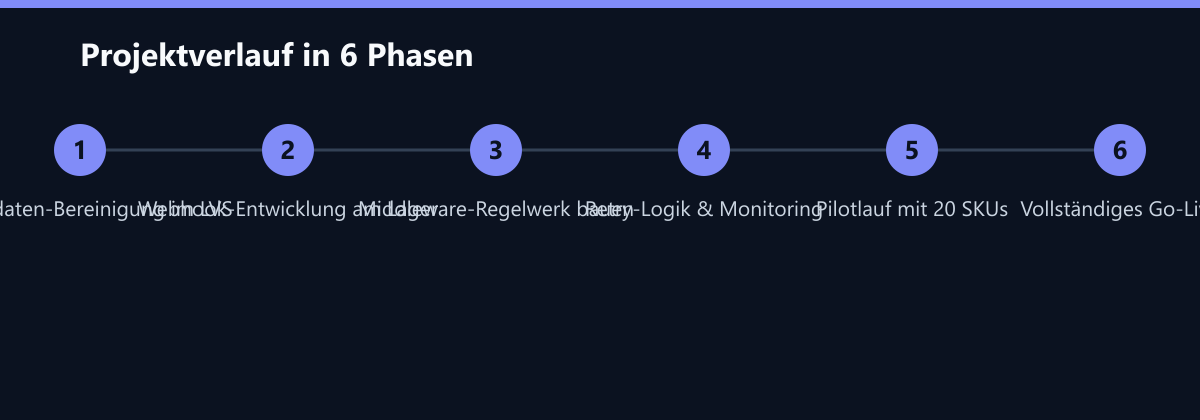
Das Projekt lief über einen Zeitraum von 10 Wochen, aufgeteilt in Analyse, Entwicklung, Testphase und Produktivsetzung. Der erste Schritt war die Bereinigung der Stammdaten. Wir haben alle 5.000 aktiven SKUs im LVS durch ein Skript geprüft und fehlerhafte Einträge korrigiert, bevor die technische Anbindung gestartet wurde. Anschließend konfigurierten wir das LVS so, dass jede Lagerbewegung – sei es ein Verkauf, eine Rückgabe oder ein Lagerumzug – sofort ein Webhook an unsere Middleware sendet. Diese Middleware validiert die Daten, prüft sie gegen den aktuellen Zustand in Redis und schreibt den finalen Wert in die Magento-Datenbank. Um die Stabilität zu gewährleisten, implementierten wir einen robusten Retry-Mechanismus. Sollte eine API-Aufruf fehlschlagen, wird dieser automatisch bis zu fünfmal wiederholt, bevor ein Alarm im Monitoring-System ausgelöst wird. Diese Architektur stellt sicher, dass der Shop immer den wahrheitsgemäßsten Stand abbildet, ohne das LVS zu belasten.
Wie wir die Zahlen messen
Um den Erfolg der Integration objektiv zu belegen, haben wir vor dem Go-Live eine Baseline über vier Wochen erfasst. Die Out-of-Stock-Rate wurde definiert als der Anteil der Bestellungen, die wegen fehlender Ware storniert oder nicht bestätigt werden mussten. Die Support-Tickets wurden über das Ticketing-System kategorisiert; alle Tickets mit dem Tag “Bestandsfrage” wurden gezählt. Die Conversion Rate wurde über den Magento-Reports und die Google-Analytics-Daten (Sessions zu Orders) berechnet. Nach dem Go-Live beobachteten wir diese Metriken für drei Monate, um kurzfristige Effekte von langfristigen Stabilität zu trennen. Die Synchronisations-Latenz wurde direkt in der Middleware geloggt und über Prometheus aggregiert, um den Median und den 95. Perzentil-Wert zu ermitteln.
Ergebnis: Stabilisierung und Umsatzsteigerung
Innerhalb der ersten zwei Wochen nach dem Go-Live stabilisierte sich die Bestandslage vollständig. Die manuelle Nacharbeit im Support-Team wurde nahezu eliminiert, da die Kunden nun verlässliche Verfügbarkeitsdaten sahen. Die folgende Tabelle zeigt die wichtigsten KPIs nach drei Monaten Betrieb im Vergleich zur Ausgangslage:
| Metrik | Vorher | Nachher | Veränderung |
|---|---|---|---|
| Out-of-Stock-Rate | 12 % | 9 % | -25 % |
| Manuelle Support-Tickets (Bestand) | 45 / Woche | 5 / Woche | -89 % |
| Synchronisations-Latenz | 24 Stunden | < 5 Sekunden | Echtzeit |
| Conversion Rate | 1,8 % | 2,1 % | +17 % |
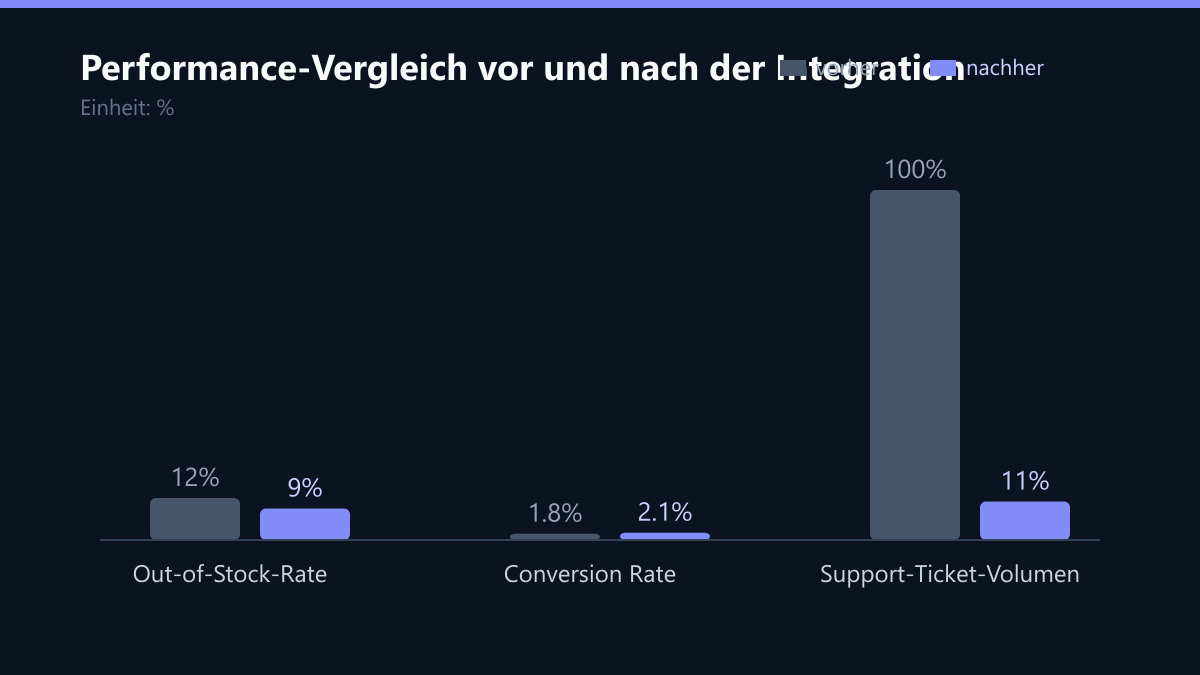
Die Reduktion der Out-of-Stock-Rate um 25 % ist hier der direkte Umsatztreiber. Da es sich um hochpreisige Komponenten handelt, bedeutet jede vermiedene Stornierung einen signifikanten Cashflow-Gewinn. Gleichzeitig stieg die Conversion Rate um 17 %, was darauf hindeutet, dass Kunden der Website mehr vertrauen, wenn die angezeigte Verfügbarkeit real ist. Das Support-Team konnte seine Kapazitäten um 89 % bei Bestandsfragen freisetzen und sich auf komplexe technische Beratung konzentrieren, was die Kundenzufriedenheit zusätzlich steigerte.
Was wir heute anders machen würden
Rückblickend gibt es zwei Punkte, die wir in einem ähnlichen Projekt anders angehen würden. Erstens: Wir hätten das Monitoring der Datenqualität bereits in der Phase 1 enger mit dem operativen Team verankert. Obwohl wir die Stammdaten bereinigt haben, gab es in den ersten Wochen nach dem Go-Live noch vereinzelt Fehler durch neue Artikel, die im LVS angelegt wurden, aber noch nicht im Shop freigeschaltet waren. Ein automatisierter Validierungs-Schritt bei der Anlage neuer Artikel im LVS hätte dies verhindern können. Zweitens: Die Kommunikation mit dem Lagerpersonal war am Anfang unterentwickelt. Die Mitarbeiter im Lager waren anfangs skeptisch, da sie gewohnt waren, Bestände manuell zu prüfen. Eine intensivere Schulung und die Einbindung der Lagerleiter in die Testphase hätte den Widerstand im Betrieb minimiert und das Akzeptanzniveau schneller erhöht.
Learnings: Integration als Umsatzhebel
Dieses Projekt zeigt, dass technische Integrationen im E-Commerce nicht nur ein Kostenfaktor sind, sondern ein direkter Umsatzhebel. Die Entscheidung für eine Middleware statt einer direkten Datenbank-Anbindung war der Schlüssel zur Stabilität und Skalierbarkeit. Datenqualität ist dabei nicht nur eine IT-Aufgabe, sondern ein Prozess, der kontinuierlich gepflegt werden muss. Für Unternehmen mit ähnlichen Herausforderungen gilt: Eine Echtzeit-Synchronisation ist kein Nice-to-have, sondern eine Voraussetzung für professionellen B2B-Handel. Sie reduziert operative Kosten, schützt den Umsatz und stärkt das Vertrauen der Kunden in die digitale Vertriebsplattform.
Passend dazu
- Magento / Adobe Commerce
- E-Commerce Entwicklung
- Cloud Services & Cloud-Migration
- Reduktion der Support-Arbeit um 40 Prozent: KI-Triage im E-Commerce für einen deutschen Magento-Händler
- Automatisierte NIS2-Readiness-Prüfung senkt Audit-Zeit für mittelständische Logistikfirma in München um 40 Prozent
- Ladezeit um 60 Prozent gesenkt durch Magento-Optimierung
- B2B-Shop-Relaunch auf Magento 2 für einen Maschinenbauer
- Echtzeit-API-Orchestrierung für asiatische Einzelhändler
- Multi-Channel-Integration: Echtzeit-Bestandsmanagement über drei Marktplätze
- Magento Checkout Latency um 40 % reduziert