Ausgangslage: Der Flaschenhals im klinischen Workflow
Das Unternehmen, ein wachsendes Biotech-Startup in Berlin mit 45 Mitarbeitern, stand vor einer klassischen Skalierungshürde. Während die Zahl der klinischen Studien und der teilnehmenden Patienten stetig anstieg, blieben die Prozesse zur Datenaufbereitung manuell und zeitaufwändig. Die Daten stammten aus einer Vielzahl unstrukturierter Quellen: gescannte PDFs von Arztbriefen, E-Mails mit Laborwerten und disparate Excel-Tabellen.
Die Hauptprobleme waren dabei nicht nur der reine Zeitaufwand, sondern die wachsende Fehleranfälligkeit. Teams verbrachten bis zu 40 % ihrer wertvollen Zeit mit der manuellen Transkription und Validierung von Patientendaten. Diese manuellen Eingaben führten zu Inkonsistenzen, die den Validierungsprozess erheblich verzögerten. Mit der Zunahme der Studienteilnehmer wuchs der administrative Overhead nicht linear, sondern exponentiell. Es drohte, dass das Unternehmen seine wissenschaftliche Kernkompetenz zugunsten administrativer Routineaufgaben aufgab.
Herausforderungen: Mehr als nur Technik
Die Umsetzung einer KI-Lösung im Gesundheitswesen ist komplexer als in anderen Branchen. Wir identifizierten vier zentrale Herausforderungen, die es zu bewältigen galt:
- Heterogene Datenformate: Die Eingangsdokumente waren oft unleserlich gescannt oder in unterschiedlichen Layouts gehalten, was die Standardisierung erschwerte.
- Strikte Compliance-Anforderungen: Als Biotech-Unternehmen unterliegt der Kunde strengen Vorschriften der DSGVO sowie ISO 27001. Die Datenhaltung in der EU war eine unbedingte Voraussetzung.
- Akzeptanz im klinischen Team: Die Fachkräfte hatten Skepsis gegenüber einer “Black-Box”-Lösung, die ihre Expertise ersetzen könnte. Vertrauen in die Systemgenauigkeit musste aufgebaut werden.
- Integration in bestehende Systeme: Die extrahierten Daten mussten nahtlos in die internen Studienmanagement-Systeme überführt werden, ohne dass der Workflow unterbrochen wird.
Der Tech-Stack: Präzision durch Kombination
Um diese Herausforderungen zu lösen, haben wir einen spezialisierten Tech-Stack aufgebaut, der auf Bewährtes setzt und moderne KI-Methoden kombiniert:
- Azure AI Services: Diente als zentrale Cloud-Plattform für die Verarbeitung der KI-Modelle, wobei explizit die EU-Regionen konfiguriert wurden, um die Datenhoheit zu wahren.
- OCR-Engine (Optical Character Recognition): Eine spezialisierte Engine zur Digitalisierung gescannter Dokumente, die auch mit handschriftlichen Notizen und komplexen Tabellen umgehen konnte.
- NLP-Pipeline (Natural Language Processing): Basierend auf Large Language Models (LLMs) zur semantischen Analyse. Diese Pipeline identifizierte Diagnosen, Medikation und Vitalwerte im Kontext des Textes.
- API-Schnittstellen: REST-APIs zur direkten Anbindung an die internen Studienmanagement-Systeme, die eine Echtzeit-Synchronisation der validierten Daten ermöglichten.
Umsetzung: Drei Phasen zur Automatisierung
Die Implementierung erfolgte nicht als Big-Bang, sondern in drei klar definierten Phasen, um Risiken zu minimieren und den Mehrwert frühzeitig sichtbar zu machen.
In der ersten Phase, der Analyse & dem Prototyping, haben wir gemeinsam mit dem klinischen Team die Datenquellen analysiert. Wir definierten die relevanten Datenpunkte (z. B. Diagnosen, Medikation, Vitalwerte) und erstellten ein erstes Prototyp auf Basis von LLMs. Ziel war es, die technische Machbarkeit zu beweisen und die Datenpunkte zu priorisieren, die den größten Hebel für die Effizienz bieten.
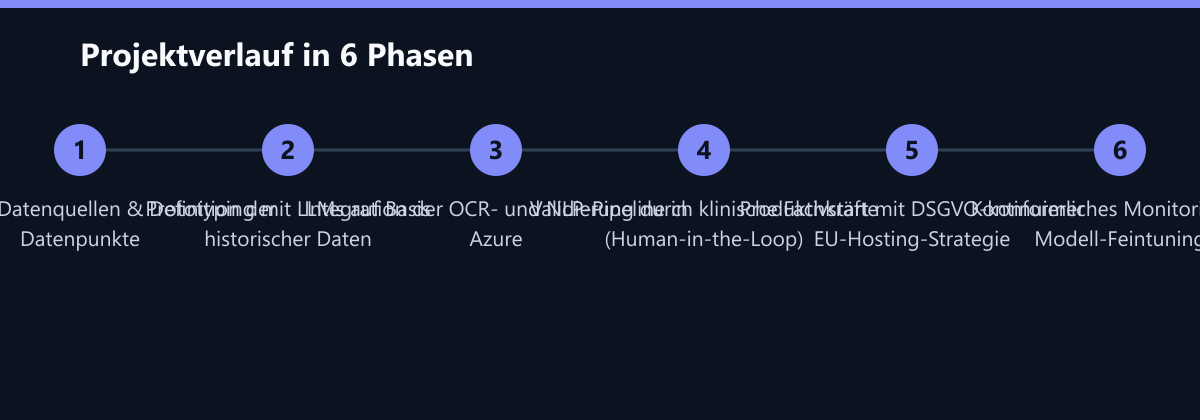
Die zweite Phase, Entwicklung & Integration, stand im Zeichen der technischen Verankerung. Die Extraktions-Engine wurde in die interne IT-Infrastruktur integriert. Wir nutzten Azure AI Services für die Verarbeitung und stellten sicher, dass alle Daten innerhalb der EU-Region verbleiben. Ein besonderer Fokus lag auf der Sicherheit: Alle Daten wurden verschlüsselt übertragen und gespeichert, und die Zugriffsberechtigungen wurden strikt nach dem Need-to-Know-Prinzip geregelt.
Die dritte Phase, Training & Validierung, war entscheidend für den Erfolg. Das Modell wurde mit historischen Daten trainiert, die von den klinischen Fachkräften manuell validiert wurden. Hier kam das Human-in-the-Loop-Prinzip zum Tragen: Die KI lieferte Vorschläge, die von den Experten geprüft und korrigiert wurden. Diese Rückkopplungsschleife diente nicht nur der Validierung, sondern auch dem kontinuierlichen Feintuning des Modells. Kritische Fälle, bei denen die KI-Konfidenz unter einem definierten Schwellenwert lag, wurden automatisch an menschliche Prüfer eskaliert.
Wie wir die Zahlen messen: Methodik der Erfolgsmessung
Um die Effektivität der Lösung objektiv zu belegen, haben wir ein umfassendes Messkonzept entwickelt, das bereits vor dem Go-Live definiert wurde. Wir haben einen Basiszeitraum (Baseline) von drei Monaten erfasst, in dem die manuellen Prozesse dokumentiert wurden.
Die Zeit für die Studievorbereitung wurde gemessen als die Zeitspanne von der Initialisierung eines neuen Patientenfalls bis zur finalen Validierung aller Datenpunkte im Studienmanagement-System. Diese Zeit wurde über alle neuen Fälle in den ersten sechs Monaten nach der Implementierung im Mittelwert berechnet und mit dem Baseline-Wert verglichen.
Die Automatisierungsrate wurde durch den Vergleich der Anzahl der Datenpunkte, die ohne menschliche Korrektur übernommen wurden, zur Gesamtzahl der extrahierten Datenpunkte ermittelt. Wir nutzten die Audit-Logs der API, um nachzuvollziehen, welche Felder automatisch gesetzt und welche manuell überschrieben wurden.
Die Kosteneinsparung wurde auf Basis der durchgesetzten Stundensätze der operativen Teams berechnet. Da weniger Zeit für Transkription aufgewendet wurde, sanken die operativen Kosten pro Studienteilnehmer. Wir haben hier nicht nur die direkte Arbeitszeit, sondern auch die indirekten Kosten durch reduzierte Nacharbeit bei Validierungsfehlern einbezogen.
Die Fehlerquote wurde durch die Anzahl der Korrekturen, die im Validierungsprozess vorgenommen werden mussten, relativiert zur Gesamtzahl der Eingaben. Ein Rückgang dieser Quote zeigt direkt die Verbesserung der Datenqualität.
Ergebnis: Messbare Effizienzsteigerung
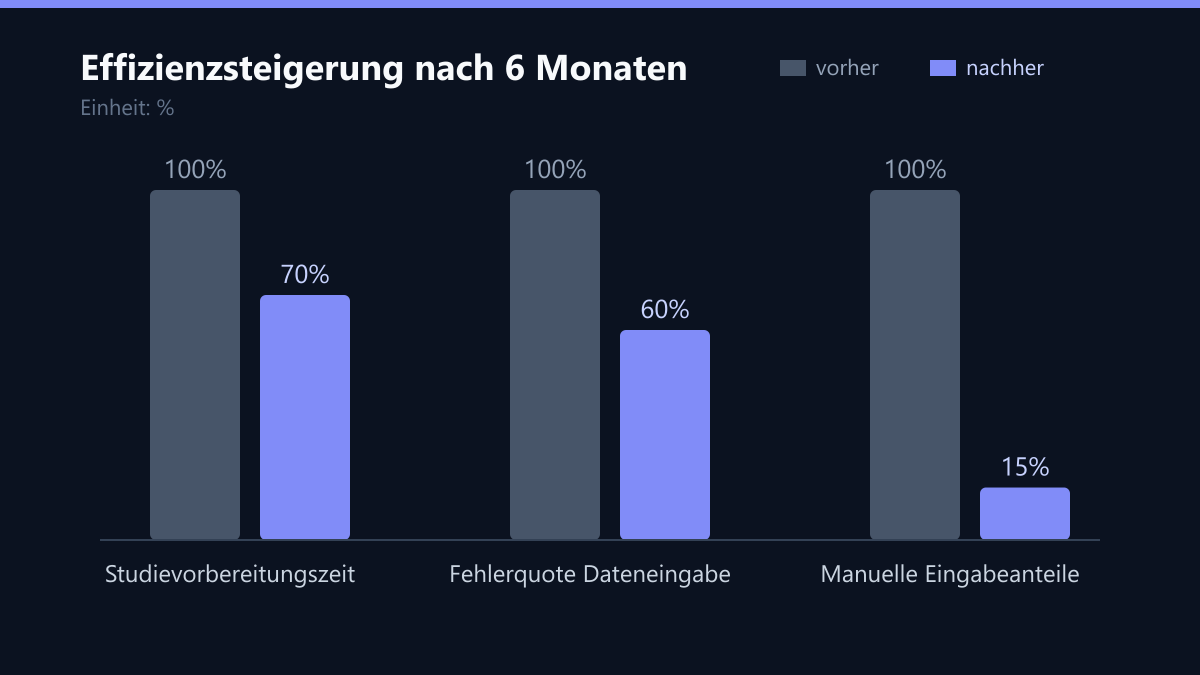
Nach sechs Monaten Betrieb zeigte sich ein klarer und messbarer Erfolg. Die Einführung der automatisierten Extraktion führte zu erheblichen Verbesserungen in der Effizienz und der Datenqualität. Die Vorbereitung neuer Studienteilnehmer wurde erheblich beschleunigt, was dem Unternehmen ermöglichte, mehr Studien parallel zu führen, ohne das Personal aufzustocken.
Die wichtigsten KPIs nach sechs Monaten Betrieb im Detail:
- 30 % schnellere Studievorbereitung: Die Zeit von der Datenerfassung bis zur Validierung sank von durchschnittlich 5 Tagen auf 3,5 Tage. Dies bedeutet, dass für jeden neuen Patienten 1,5 Tage an administrativer Vorlaufzeit eingespart wurden.
- Reduktion manueller Eingaben: 85 % der Datenpunkte werden nun automatisch und korrekt extrahiert. Die verbleibenden 15 % sind komplexe Sonderfälle, die weiterhin menschliche Expertise erfordern, aber durch die KI-Kontextualisierung schneller bearbeitet werden können.
- Kosteneinsparung: Die operativen Kosten pro Studienteilnehmer sanken um 22 %. Dies resultiert direkt aus der Reduktion der manuellen Arbeitszeit und der geringeren Nacharbeit.
- Erhöhte Datenqualität: Die Fehlerquote bei der Dateneingabe wurde um 40 % reduziert. Die Konsistenz der Daten im Studienmanagement-System stieg signifikant, was die Qualität der klinischen Auswertungen verbessert.
Learnings: Was wir mitgenommen haben
Das Projekt hat gezeigt, dass KI-Automatisierung im Gesundheitswesen nicht nur ein technisches, sondern ein tiefgreifendes organisatorisches Projekt ist. Die Technologie ist nur so gut wie die Prozesse, die sie unterstützt, und die Akzeptanz, die sie im Team findet.
Ein zentraler Punkt war die Datenqualität als Grundlage. Wir haben gelernt, dass die Qualität der Ausgangsdaten die Effektivität der KI bestimmt. Eine saubere Dokumentenmanagement-Struktur ist die Basis für erfolgreiche Automatisierung. Wo die Scans unleserlich waren, musste die OCR-Engine stärker nachhelfen, was die Latenzzeit erhöhte. Die Investition in bessere Scan-Praktiken vor der KI-Implementierung war daher ein entscheidender Erfolgsfaktor.
Zweitens hat sich bestätigt, dass Human-in-the-Loop im klinischen Kontext unverzichtbar bleibt. Vollständige Automatisierung wäre hier nicht nur riskant, sondern auch schwer durchsetzbar. Die Kombination aus der Geschwindigkeit der KI und der fachlichen Expertise der Menschen bietet den besten Kompromiss aus Effizienz und Sicherheit. Das Team hat die KI nicht als Bedrohung, sondern als Werkzeug zur Entlastung von Routineaufgaben akzeptiert.
Drittens ist Compliance von Anfang an in der Architektur verankert werden. Die Einhaltung von DSGVO und ISO 27001 kann nicht nachträglich implementiert werden. Die Entscheidung, lokale Hosting-Optionen in der EU zu nutzen, war für das Vertrauen der Kunden und der internen Compliance-Abteilung entscheidend. Regulatorische Anforderungen müssen als technische Constraints (z. B. Datenlokalisierung, Verschlüsselung) in der Design-Phase definiert werden.
Was wir heute anders machen würden
Trotz des Erfolgs gibt es Punkte, die wir bei einem ähnlichen Projekt heute anders angehen würden, um den Prozess noch effizienter zu gestalten.
Erstens hätten wir die Datenbereinigung noch stärker in der Vorphase getrennt. Im Projekt wurde die Datenbereinigung teilweise parallel zur Modellentwicklung durchgeführt. Hätten wir eine dedizierte Phase für die Standardisierung der Eingangsdaten (z. B. durch Vorverarbeitungs-Skripte) vor der KI-Integration eingeplant, hätten wir die Trainingszeit des Modells verkürzen und die initiale Genauigkeit erhöhen können.
Zweitens hätten wir die User-Akzeptanz-Tests (UAT) früher und intensiver einbezogen. Die klinischen Fachkräfte hatten anfangs Bedenken, ihre Eingaben mit der KI zu vergleichen. Ein früherer Prototyp, der in einer geschützten Umgebung mit realen (anonymisierten) Daten getestet wurde, hätte das Vertrauen in die Technologie schneller aufbauen und das Feedback-Loop beschleunigen können.
Drittens würden wir die Monitoring-Dashboards für die Modell-Drift bereits im Prototyping definieren. Während des Betriebs ist es wichtig, nicht nur die Leistung, sondern auch die Stabilität des Modells im Auge zu behalten. Eine frühere Definition der Metriken für Modell-Drift (z. B. Abweichung der Extraktionsgenauigkeit über die Zeit) hätte uns erlaubt, proaktiver auf Veränderungen in den Eingangsdaten zu reagieren.
Passend dazu
- 5 Engpässe bei manueller Datenerfassung und sichere Automatisierung
- IT- & Daten-Wiederherstellung (Disaster Recovery)
- IT-Beratung & IT-Strategie
- AIOps im Mittelstand: Automatisierte Root-Cause-Analyse ohne Data-Science-Team
- 3DS-Prüfung für Backups: Warum regelmäßige Wiederherstellungstests Pflicht sind
- IT-Compliance & Datenschutz
- Cloud Services & Cloud-Migration
- E-Commerce Entwicklung
- Fintech Startup in Berlin: Multi-Cloud Strategy Reduces Vendor Lock-In Risks
- Automatisierte Compliance-Berichte für Finanzdienstleister
- Automated Invoice Processing with OCR and LLM: Reducing Accounting Backlog by 40 Percent in DACH Manufacturing
- Automotive Supplier in Munich: Edge-Cloud Integration Speeds Up Data Processing by 50 Percent
- Remote IT Support Security: Best Practices for Protecting Sensitive Data
- GDPR Data Mapping for a US Healthcare Tech Startup: Achieving 100 Percent Record Accuracy and Passing the DPA Audit
- Berlin Fintech Reduces Audit Preparation Time by 65% Through Continuous Compliance Monitoring
- Data Loss Vorfälle um 40 Prozent reduziert mit eDiscovery und DLP
- Healthcare Data Protection: Reducing HIPAA Violations by 70 Percent via Micro-Learning for Clinical Staff
- Data Loss Prevention vs Data Recovery: Der Unterschied für IT-Sicherheitsteams
- GDPR Data Breach Response: 5 Steps to Minimize Fines and Reputational Damage
- Securing BYOD Devices: 5 Essential Policies to Protect Corporate Data