Ausgangslage: Der stille Kostentreiber
Der Kunde, ein wachsender B2B-SaaS-Anbieter mit Sitz in New York und rund 150 Mitarbeitern, stand vor einem klassischen Problem der Skalierung: Die Cloud-Ausgaben stiegen schneller als der Umsatz. Im letzten Quartal vor dem Projektstart war die monatliche AWS-Rechnung um 40 % explodiert, ohne dass ein entsprechendes Wachstum der Nutzerbasis oder der API-Aufrufe vorlag. Diese Diskrepanz zwischen Kosten und Wertschöpfung wurde zum kritischen Thema im Vorstand. Die CIO-Abteilung stand unter erheblichem Druck, die Margen zu schützen, ohne die Skalierbarkeit und Zuverlässigkeit der Plattform zu gefährden. Das eigentliche Kernproblem war jedoch nicht die Technologie selbst, sondern die fehlende Sichtbarkeit. Es gab keine zentralen Dashboards, die zeigten, welche Teams, Projekte oder Umgebungen welche Ressourcen verbrauchen. Kosten wurden als „gemeinsame Last“ betrachtet, was zu einem fehlenden Bewusstsein für Effizienz führte. Ohne klare Verantwortlichkeiten und granulare Daten war jede Optimierung ein Blindflug.
Herausforderungen: Warum einfache Sparmaßnahmen nicht reichten
Bevor wir mit der technischen Umsetzung begannen, mussten wir drei spezifische Hindernisse identifizieren, die in der Vergangenheit zu Ineffizienzen geführt hatten.
Erstens fehlte ein konsistentes Tagging-Schema. Ressourcen wurden historisch nach individuellen Entwicklerpräferenzen benannt oder gar nicht erst taggt. Das machte eine Zuordnung von Kosten zu Business-Einheiten unmöglich. Zweitens war das Lifecycle-Management von Ressourcen unzureichend. Testumgebungen liefen oft über Wochen im Hintergrund, ohne aktiv genutzt zu werden, und alte Snapshots oder EBS-Volumes wurden nie bereinigt. Drittens gab es keine proaktiven Alarme. Budgetüberschreitungen wurden erst bemerkt, wenn die monatliche Rechnung bereits fällig war, was eine sofortige Korrektur unmöglich machte. Diese drei Faktoren erforderten einen strukturierten Ansatz, der über das bloße „Ausschalten“ von Servern hinausging.
Der Tech-Stack: Tools für Transparenz und Kontrolle
Um die identifizierten Probleme zu lösen, setzten wir auf eine Kombination aus nativen Cloud-Diensten und Infrastruktur-as-Code-Praktiken. Der Fokus lag auf der Nutzung bestehender Tools, um die Komplexität für das interne Team niedrig zu halten.
- AWS Cost Explorer & Compute Optimizer: Dienten als Grundlage für die historische Analyse und die Identifikation von überdimensionierten Instanzen. Der Compute Optimizer lieferte konkrete Empfehlungen für die richtige Instanzgröße basierend auf CPU- und Memory-Utilization.
- CloudWatch: Wurde genutzt, um detaillierte Metriken zu erfassen und als Datenquelle für unsere Custom-Dashboards zu dienen. Es ermöglichte die Korrelation von Kosten mit tatsächlicher Systemauslastung.
- Terraform: Diente der Verwaltung der Infrastruktur als Code. Dies war entscheidend, um das neue Tagging-Schema und die Scheduling-Policies versionierbar und reproduzierbar zu machen.
- AWS Budgets & Alarms: Konfiguriert, um proaktive Warnungen bei Abweichungen von über 10 % vom erwarteten Budget zu senden. Dies verschiebt den Fokus von reaktiver Reaktion zu proaktiver Steuerung.
- Custom Python-Skripte: Entwickelt, um spezifische Reporting-Anforderungen zu erfüllen, die über die Standard-Dashboards hinausgingen, insbesondere für die Aggregation von Kosten nach Produktlinien.
Umsetzung: FinOps in drei Phasen
Wir implementierten einen strukturierten FinOps-Ansatz in drei Phasen über einen Zeitraum von acht Wochen. Das Ziel war es, zunächst Transparenz zu schaffen, dann sofortige Einsparpotenziale zu heben und schließlich Prozesse zu automatisieren, die die Ergebnisse langfristig stabilisieren.
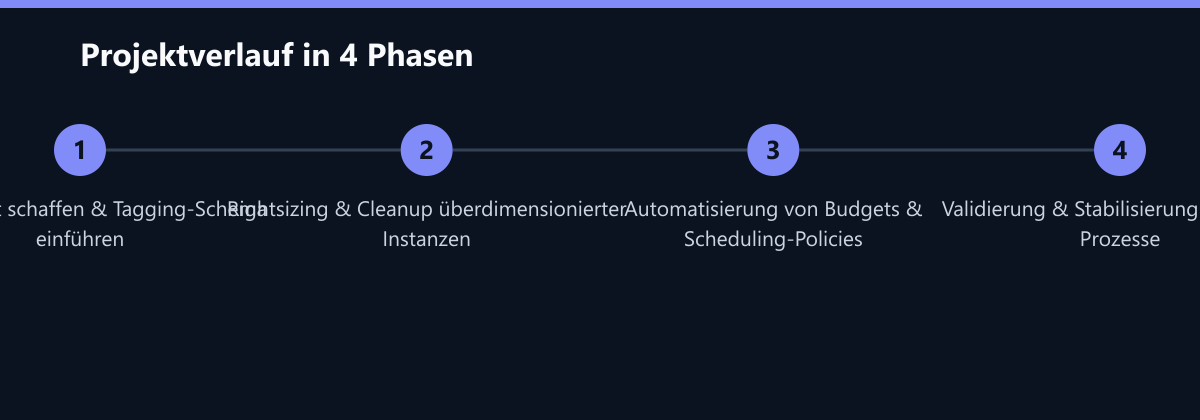
Phase 1: Visibility & Tagging (Woche 1–2) Die Grundlage jeder Kostenoptimierung ist die Fähigkeit, Kosten zuzuordnen. In den ersten zwei Wochen führten wir ein konsistentes Tagging-Schema ein, das alle Ressourcen nach Projekt, Team, Umgebung und Kostenstelle klassifizierte. Wir definierten klare Richtlinien, dass keine neue Ressource ohne die erforderlichen Tags erstellt werden durfte. Mit AWS Cost Explorer und CloudWatch erstellten wir granulare Dashboards, die Kosten in Echtzeit abbildeten. Diese Dashboards wurden nicht nur für die IT-Leitung, sondern auch für die Team-Leads der Entwicklung zugänglich gemacht. Das Ziel war es, Kosten als gemeinsame Verantwortung zu etablieren, nicht als IT-Problem.
Phase 2: Rightsizing & Cleanup (Woche 3–5) Mit der neuen Sichtbarkeit konnten wir nun gezielt ansetzen. Automatisierte Analysen identifizierten überdimensionierte EC2-Instanzen, deren CPU-Auslastung im Durchschnitt unter 20 % lag. Wir reduzierten die Größe von 35 % der Workloads, ohne die Performance zu beeinträchtigen. Dies geschah in enger Abstimmung mit den Dev-Teams, um sicherzustellen, dass keine kritischen Puffer verloren gingen. Zusätzlich wurden ungenutzte EBS-Volumes und alte Snapshots, die länger als 30 Tage nicht referenziert wurden, systematisch bereinigt. Diese Phase brachte die schnellsten sichtbaren Ergebnisse, da sie direkt auf „verschwendete“ Kapazitäten abzielte.
Phase 3: Automatisierung & Policies (Woche 6–8) Um sicherzustellen, dass die Einsparungen nicht wieder verloren gehen, konfigurierten wir AWS Budgets mit automatischen Alarmen bei Abweichungen von über 10 %. Für nicht-prodaktive Umgebungen wie Entwicklung und Staging implementierten wir Scheduling-Policies, die Instanzen nach Feierabend und am Wochenende automatisch herunterfahren und am Montagmorgen wieder starten. Dies eliminierte die manuelle Disziplin, die oft zum Versagen führt. Alle Änderungen wurden über Terraform gemanagt, um die Reproduzierbarkeit und Auditierbarkeit sicherzustellen.
Wie wir die Zahlen messen: Methodik hinter den KPIs
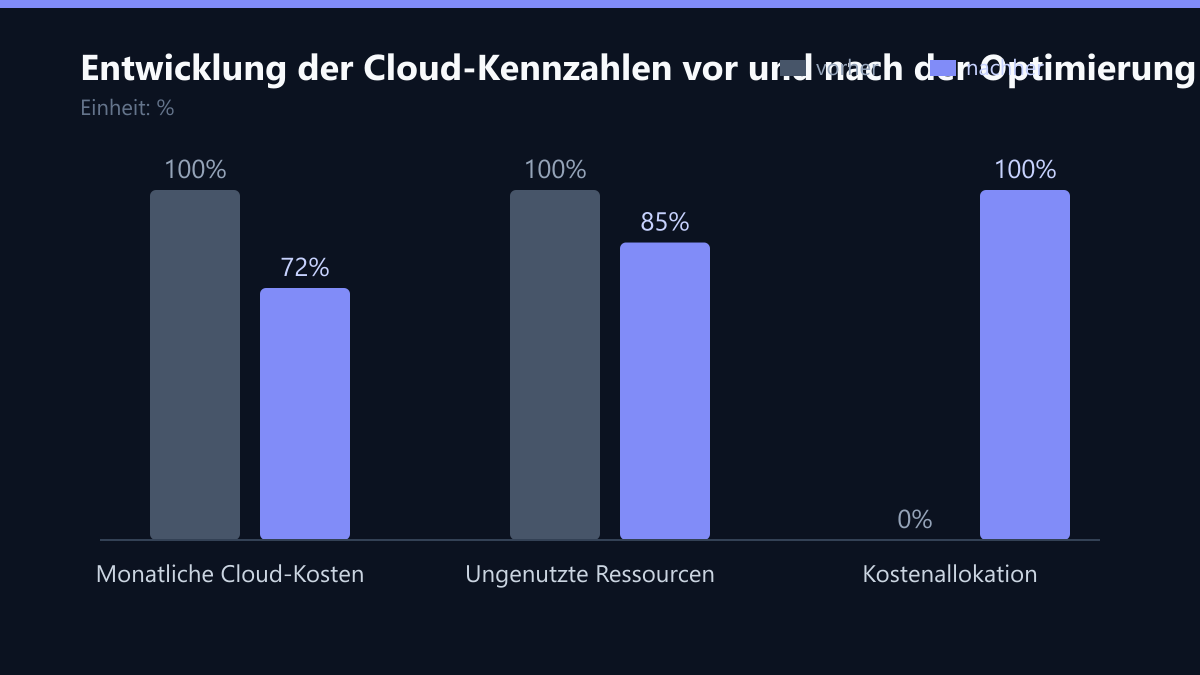
Die gemeldeten Ergebnisse basieren auf einer strengen Vergleichsmethode. Die „Vor“-Zahlen wurden aus der Durchschnittsausgabe der letzten sechs Monate vor dem Projektstart ermittelt, um saisonale Schwankungen auszugleichen. Die „Nach“-Zahlen repräsentieren die Durchschnittsausgabe der ersten drei Monate nach der vollständigen Implementierung (Tag 90). Die 28 % Reduktion bezieht sich auf die reinen Infrastrukturkosten (Compute, Storage, Data Transfer) und schließt Support-Kosten aus. Die Messung der ungenutzten Ressourcen erfolgte über die Analyse der CloudWatch-Metriken (CPU, Memory, Disk I/O) kombiniert mit dem Status der Ressourcen in der AWS-Konsole. 100 % Abdeckung durch Tagging bedeutet, dass zu dem Stichtag jede aktive Ressource in der Produktiv- und Staging-Umgebung die erforderlichen Metadaten-Fields besaß, was durch ein automatisiertes Compliance-Check-Skript verifiziert wurde.
Ergebnis: Nachhaltige Stabilität statt kurzfristiger Schnitte
Nach der Implementierung der Maßnahmen stabilisierten sich die Cloud-Kosten und sanken nachhaltig. Der Kunde erzielte eine signifikante Kostenreduktion bei gleichbleibender Systemperformance. Die KPIs nach 90 Tagen zeigten eine 28 % niedrigere monatliche Cloud-Ausgaben im Vergleich zum Vorjahreszeitraum. Zusätzlich wurde eine 15 % Reduktion der ungenutzten Ressourcen durch automatisiertes Cleanup erreicht. Die 100 % Abdeckung durch Tagging und Kostenallokation ermöglichte es der Finanzabteilung, nun exakte Vorhersagen für die nächsten Quartale zu erstellen, was die Budgetplanung erheblich vereinfachte. Besonders hervorzuheben ist, dass es Zero Downtime während der gesamten Optimierungsphase gab. Die Performance-SLA wurden zu jedem Zeitpunkt eingehalten, was im Vorstand als wichtiger Vertrauensbeweis gewertet wurde.
Was wir heute anders machen würden
Rückblickend gibt es zwei Punkte, die wir in einem ähnlichen Projekt anders angehen würden. Erstens hätten wir das Tagging-Schema früher in die CI/CD-Pipeline integriert. In diesem Projekt haben wir das Tagging zunächst manuell und über Terraform-Module etabliert. Heute würden wir direkt bei der Erstellung der Infrastruktur-Templates die Tagging-Pflicht härter durchsetzen, um die „Schuld“ bei der Einführung zu minimieren. Zweitens hätten wir die Kommunikation mit den Dev-Teams intensiver gestaltet. Rightsizing wird oft als Eingriff in die technische Souveränität empfunden. Ein früheres Involvement der Entwickler bei der Definition der „sicheren“ Instanzgrößen hätte die Akzeptanz und die Geschwindigkeit der Phase 2 erhöht.
Learnings: Kultur vor Technik
Der Erfolg lag nicht nur in der technischen Umsetzung, sondern in der kulturellen Verankerung von FinOps. Wir lernten, dass Klarheit vor Optimierung steht: Ohne sauberes Tagging sind Einsparungen nicht messbar und nicht zuordenbar. Automatisierung verhindert, dass manuelle Fehler wiederkehren, aber nur, wenn die Grunddaten sauber sind. Regelmäßige Reviews der Dashboards sind essenziell für langfristige Effekte, da sich Workloads und Anforderungen ändern. Kommunikation mit den Dev-Teams ist entscheidend, um Rightsizing als Vorteil statt als Eingriff zu kommunizieren. Diese Struktur lässt sich direkt auf andere Cloud-Provider wie Azure oder GCP übertragen, da die Prinzipien der Kostenallokation und Automatisierung provider-unabhängig sind.
Passend dazu
- IT-Beratung & IT-Strategie
- Cloud-Optimierung: 5 Strategien zur Reduktion von Cloud-Spending um 30 Prozent
- FinOps im Mittelstand: So kontrollieren Sie Ihre Cloud-Ausgaben mit Azure Cost Management
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- E-Commerce Entwicklung
- Azure-Cloud-Kosten um 35 Prozent gesenkt
- Sicherung der DSGVO-Konformität und Senkung der Latenzzeit um 45 Prozent bei der Cloud-Modernisierung einer E-Commerce-Plattform in Hamburg
- Reduktion der Support-Arbeit um 40 Prozent: KI-Triage im E-Commerce für einen deutschen Magento-Händler
- Serverkosten um 40 Prozent senken: Magento 2 Migration auf Adobe Cloud
- Automotive Supplier in Munich: Edge-Cloud Integration Speeds Up Data Processing by 50 Percent
- Automated Invoice Processing with OCR and LLM: Reducing Accounting Backlog by 40 Percent in DACH Manufacturing
- Churn Prediction in B2B SaaS: Retaining 25% More Customers with Behavioral AI Models in New York
- Logistik: Phishing-Automatisierung mit KI-SOC für einen US-3PL-Anbieter
- NIS2 Gap Analysis und technische Kontrolle für einen Münchner Maschinenbauer
- Cloud FinOps für den Mittelstand: 7 Taktiken gegen unnötige Ausgaben
- Globale DR-Synchronisierung für einen US-amerikanischen Maschinenbauer
- Cybersecurity Essentials für MSP-Kunden: Was Ihr Anbieter abdecken muss
- SaaS: Improving Customer Satisfaction Scores by 25 Percent via Multilingual Support in Asia
- Warum Ihr IT-Helpdesk einen Cybersecurity-Fokus braucht