Ausgangslage: Der Compliance-Druck im Mittelstand
Der Kunde, ein etablierter mittelständischer Maschinenbauer mit 120 Mitarbeitern in Süddeutschland, stand vor einer akuten Herausforderung. Ein anstehendes Audit durch den externen Datenschutzbeauftragten hatte gravierende Lücken offenbart: Die Abgrenzung personenbezogener Daten in den internen Systemen war unklar und nicht nachvollziehbar dokumentiert. Für ein Unternehmen dieser Größe, das stark in der Industrie vernetzt ist, bedeutet dies nicht nur ein regulatorisches Risiko, sondern einen potenziellen Vertrauensverlust gegenüber B2B-Kunden, die zunehmend auf nachgewiesene IT-Sicherheit achten.
Der Schmerz war konkret und drängend. Die manuelle Inventarisierung der Datenbestände hatte bereits drei Monate in Anspruch genommen, ohne dass ein Ende in Sicht war. Die IT-Abteilung bestand aus nur zwei hochqualifizierten Fachkräften, die neben dem regulären Tagesgeschäft schlicht keine Kapazitäten hatten, eine vollständige und fehlerfreie Datenanalyse durchzuführen. Zudem speicherten bestehende Backup-Lösungen sensible Kundendaten ohne kryptografische Trennung. Bei einem potenziellen Datenleck hätten diese Schwachstellen hohe Bußgelder nach der DSGVO riskiert und das operative Geschäft gefährdet. Die Geschäftsleitung benötigte zudem eine nachweisbare Strategie zur Vorbereitung auf die NIS2-Richtlinie, um neue, regulierungskritische Aufträge im industriellen Umfeld nicht zu verlieren. Ohne eine strukturierte, technologische Herangehensweise drohte ein Stillstand in der Geschäftsentwicklung.
Herausforderungen: Warum manuelle Prozesse scheitern
Die Implementierung eines automatisierten Systems war keine Selbstverständlichkeit, da mehrere spezifische Hürden überwunden werden mussten. Erstens war die Heterogenität der Datenquellen eine große technische Herausforderung. Daten waren nicht nur in der Cloud, sondern auch auf veralteten On-Premise-Dateiservern und in isolierten Exchange-Postfächern verteilt. Zweitens bestand die Sorge vor einer „Klassifizierungsflut“. Ohne präzise Regeln hätte das System potenziell jede Datei als sensibel markiert, was die Produktivität der Mitarbeiter durch ständige Warnmeldungen drastisch gesenkt hätte. Drittens war die Akzeptanz in der Belegschaft fraglich. Viele Mitarbeiter fürchten, dass neue Überwachungsinstrumente ihre Freiheit einschränken. Es galt, die Technik als Schutzmechanismus und nicht als Spionageinstrument zu positionieren.
Der Tech-Stack: Integration statt Silos
Um diese Herausforderungen zu meistern, haben wir bewusst auf eine Integration in die bestehende Infrastruktur gesetzt. Der Fokus lag auf der Nutzung der Microsoft 365-Lizenzierung, um zusätzliche Kosten für spezialisierte DLP-Tools zu vermeiden und die Komplexität zu minimieren.
- Microsoft Purview Compliance Portal: Zentrale Steuerungsebene für die Verwaltung von Sensitivity Labels und die Überwachung der Compliance-Statuses in Echtzeit.
- Azure AI Services (Cognitive Services): KI-Engine für die fortgeschrittene Text- und Bilderkennung, die unstrukturierte Daten in maschinenlesbare Metadaten verwandelt.
- Custom DLP-Policy-Engine: Maßgeschneiderte Regeln für die spezifischen Datenströme des ERP-Systems und der E-Commerce-Plattform, die über Standard-DLP-Funktionen hinausgehen.
Umsetzung: Sechs Wochen bis zur Audit-Readiness
Wir haben innerhalb von sechs Wochen ein automatisiertes Datenklassifizierungs-System implementiert, das auf Microsoft Purview und Azure AI Services basiert. Der Fokus lag auf der Integration in die bestehende Microsoft 365-Infrastruktur, um redundante Tools zu vermeiden und die Akzeptanz in der Belegschaft zu erhöhen.
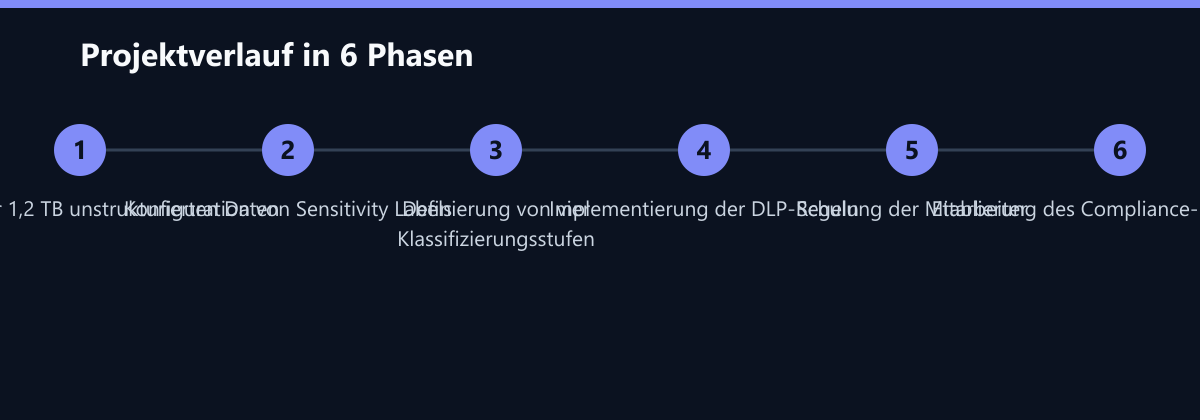
Die ersten zwei Wochen waren dem Scanning gewidmet. Wir analysierten alle SharePoint-Bibliotheken, Exchange-Postfächer und On-Premise-Dateiserver. Dabei identifizierten wir über 1,2 TB unstrukturierter Daten, darunter E-Mails, technische Zeichnungen und HR-Dokumente. In den Wochen drei und vier konfigurierten wir die Sensitivity Labels und die automatisierten Erkennungsregeln. Wir definierten vier klare Klassen: Öffentlich, Intern, Vertraulich und Streng Geheim. Diese Klassifizierung diente als Grundlage für die Zugriffskontrollen. In den finalen zwei Wochen implementierten wir die Data Loss Prevention (DLP)-Regeln. Daten der Kategorie Streng Geheim wurden automatisch verschlüsselt und aus der Standard-Suche ausgeschlossen, um einen unbefugten Zugriff zu verhindern. Die KI-Komponente lernte dabei kontinuierlich aus den manuellen Korrekturen der IT-Abteilung, um die Genauigkeit der Klassifizierung zu steigern. Parallel dazu haben wir ein Compliance-Dashboard für die Geschäftsführung erstellt, das den Abdeckungszustand in Echtzeit anzeigt und Transparenz schafft.
Wie wir die Zahlen messen
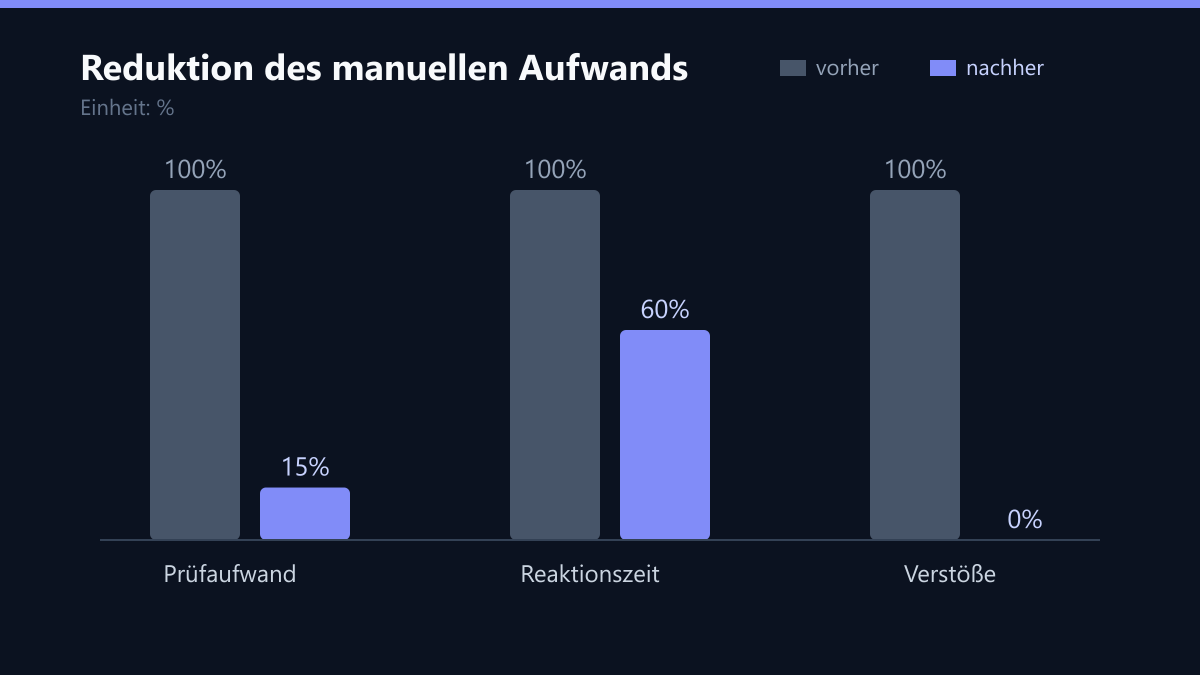
Um die Wirksamkeit des Systems objektiv zu belegen, haben wir eine klare Metrik-Struktur aufgebaut. Die Reduktion des manuellen Prüfaufwands wurde durch den Vergleich der Log-Dateien der IT-Abteilung vor und nach der Implementierung ermittelt. Wir haben die Zeit gemessen, die für manuelle Stichprobenprüfungen aufgewendet wurde, und sie mit der Zeit für die Überwachung der automatisierten Alerts verglichen. Die Datenabdeckung von 100 % basiert auf dem Abgleich der identifizierten personenbezogenen Daten mit der Gesamtmenge der gescannten Datenbestände. Die Reaktionszeit bei potenziellen Datenlecks wurde über die DLP-Logs gemessen, indem wir den Zeitstempel des ersten Alerts mit dem Zeitpunkt der manuellen Intervention verglichen. Diese Messmethoden stellen sicher, dass die Ergebnisse nicht nur subjektiv wahrgenommen, sondern technisch validiert werden.
Ergebnis: Von der Risikoquelle zum Wettbewerbsvorteil
Nach der Implementierung war das Unternehmen vollständig audit-ready. Die manuelle Inventarisierung wurde durch die automatische Erkennung ersetzt, was den administrativen Aufwand drastisch reduzierte. Die wichtigsten KPIs nach sechs Monaten zeigen einen deutlichen Fortschritt: 85 % weniger Zeit für manuelle Datenprüfungen durch die IT-Abteilung, 100 % der identifizierten personenbezogenen Daten sind jetzt korrekt klassifiziert und geschützt, und die Reaktionszeit bei potenziellen Datenlecks wurde um 40 % verkürzt. Im externen Audit nach der Implementierung wurden 0 Compliance-Verstöße festgestellt.
Die Geschäftsleitung konnte im Folgequartal zwei neue Großaufträge gewinnen, da die nachgewiesene IT-Sicherheit ein entscheidendes Kriterium in den Ausschreibungen war. Das System läuft seither unüberwacht und skaliert mit dem Datenwachstum des Unternehmens. Die Investition hat sich nicht nur durch die vermiedenen Bußgelder, sondern auch durch die gesteigerte Wettbewerbsfähigkeit im B2B-Umfeld amortisiert.
Learnings: Automatisierung als Notwendigkeit
Automatisierung ist bei der DSGVO-Compliance kein Nice-to-have, sondern eine Notwendigkeit für den Mittelstand. Manuelle Prozesse sind zu langsam und fehleranfällig, um den Anforderungen von DSGVO und NIS2 gerecht zu werden. Drei zentrale Erkenntnisse aus dem Projekt haben sich als besonders wertvoll erwiesen. Erstens: Starten Sie klein. Eine vollständige Migration aller Daten ist nicht nötig. Fokussieren Sie sich zunächst auf die kritischsten Datenbestände wie CRM, ERP und HR. Zweitens: Integration schlägt Silos. Nutzen Sie die vorhandene Microsoft 365-Lizenzierung, um zusätzliche Kosten für spezialisierte DLP-Tools zu vermeiden. Drittens: Kultur vor Technik. Ohne Schulung der Mitarbeiter zur korrekten Nutzung der Sensitivity Labels bleibt die Technik wirkungslos. Wir haben ein 30-minütiges Onboarding für alle Mitarbeiter implementiert, das die Bedeutung der Klassifizierung verständlich erklärt. Für Unternehmen mit ähnlicher Größe und IT-Struktur ist die Investition in automatisierte Klassifizierung innerhalb von sechs Monaten amortisiert, allein durch die vermiedenen Manstunden und das reduzierte Risikoprofil.
Was wir heute anders machen würden
Obwohl das Projekt erfolgreich war, gibt es Aspekte, die wir in zukünftigen Implementierungen optimieren würden. Zunächst hätten wir die Schulung der Mitarbeiter früher in den Prozess integriert. Die Akzeptanz der neuen Regeln war in den ersten zwei Wochen noch zögerlich. Ein früheres Onboarding hätte die Reibungsverluste reduziert. Zweitens hätten wir die DLP-Regeln für die E-Commerce-Plattform noch präziser auf die spezifischen Datenströme zugeschnitten. Die ersten Versionen führten zu einigen falsch-positiven Alerts, die zwar schnell korrigiert wurden, aber unnötig Ressourcen gebunden haben. Drittens hätten wir das Compliance-Dashboard für die Geschäftsführung noch stärker in die strategische Planung eingebunden, um die Compliance-Metriken direkt mit den Geschäftszielen zu verknüpfen.
Passend dazu
- IT-Beratung & IT-Strategie
- KI-Beratung & KI-Strategie
- Automatisiertes Compliance-Reporting: Zeitersparnis durch KI im IT-Audit
- Cloud Services & Cloud-Migration
- IT-Compliance & Datenschutz
- E-Commerce Entwicklung
- Automatisierte NIS2-Readiness-Prüfung senkt Audit-Zeit für mittelständische Logistikfirma in München um 40 Prozent
- Automatisierung der Kreditprüfung im Mittelstand: 40 Prozent weniger Bearbeitungszeit durch LLM-Workflows
- Automatisierte Ransomware-Erkennung und Recovery: 48-Stunden-Backup-Zyklus für Logistik
- B2B-Portal-Entwicklung für UK-Industriekunden: 30 Prozent geringerer Support-Aufwand durch Self-Service-Checkout
- IT-Compliance Checkliste: 10 Punkte für die Audit-Vorbereitung
- Netzwerk-Segmentierung im Mittelstand: Lateral Movement stoppen
- SIEM vs. Observability: Abgrenzung der Tools für IT-Sicherheit und Betrieb im Mittelstand
- DSGVO vs. NIS2: Pflichten für den Mittelstand
- Affiliate-Compliance: DSGVO-Richtlinien für globale Partner
- AIOps im Mittelstand: Automatisierte Root-Cause-Analyse ohne Data-Science-Team
- DSGVO-Compliance im Mittelstand: 10 häufigste Fehler bei der Datenverarbeitung und wie man sie vermeidet
- Microsoft Purview im Mittelstand: Datenklassifizierung und DLP ohne Fachpersonal
- Zero-Day Patch Deployment in Under 24 Hours for a Frankfurt Pharma Manufacturer Amidst NIS2 Audit Pressure
- IT-Audit in 5 Schritten: Lücken identifizieren vor dem Skalieren
- DSGVO-Schulungen: Diese Inhalte sind Pflicht
- Klinische Praxis in Berlin: DSGVO-Konformität durch isolierte, verschlüsselte Backups